Protection des données
Modes de détection, bibliothèque de 61 détecteurs, détection d’entités et modèles au choix, analyse de sécurité, avis au modèle et conservation.
La protection des données s’exécute sur chaque requête avant l’envoi. Le mode par défaut est tokenize : chaque valeur détectée sans exception correspondante est remplacée par un jeton typé stable, comme «EMAIL_1».
Les valeurs protégées ne parviennent au fournisseur que sous forme de jetons, et la réponse retrouve les vraies valeurs à son retour vers vous, en streaming ou non.
La table des jetons reste en mémoire le temps de la requête et n’est jamais conservée. La pseudonymisation est à sens unique : elle protège ce que vous envoyez.
Dans Sluis Workspace, les résultats de recherche web publics et la propre sortie du modèle plus tôt dans le même tour ne sont pas tokenisés à nouveau. Une valeur déjà tokenisée par la conversation reste remplacée par son jeton, et le journal d’audit indique quand cette règle s’est appliquée.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives: only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back: restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Quatre modes déterminent ce qui arrive à une valeur détectée :
tokenize(par défaut) la remplace par un jeton réversible.maskla réécrit de façon irréversible.blockrefuse la requête avec422.allow_logla laisse passer en signalant la ligne d’audit.
61 détecteurs intégrés sont fournis d’office : 29 pour les données personnelles, du numéro de sécurité sociale américain aux pièces d’identité nationales validées par la somme de contrôle, la date ou le format propres à chaque pays, et 32 pour les secrets et identifiants. Chacun peut être activé ou désactivé par organisation. Les termes personnalisés (simples ou regex) couvrent tout ce qui est propre à votre activité, et le libellé d’un terme personnalisé peut atteindre 32 caractères :
Exceptions par motif
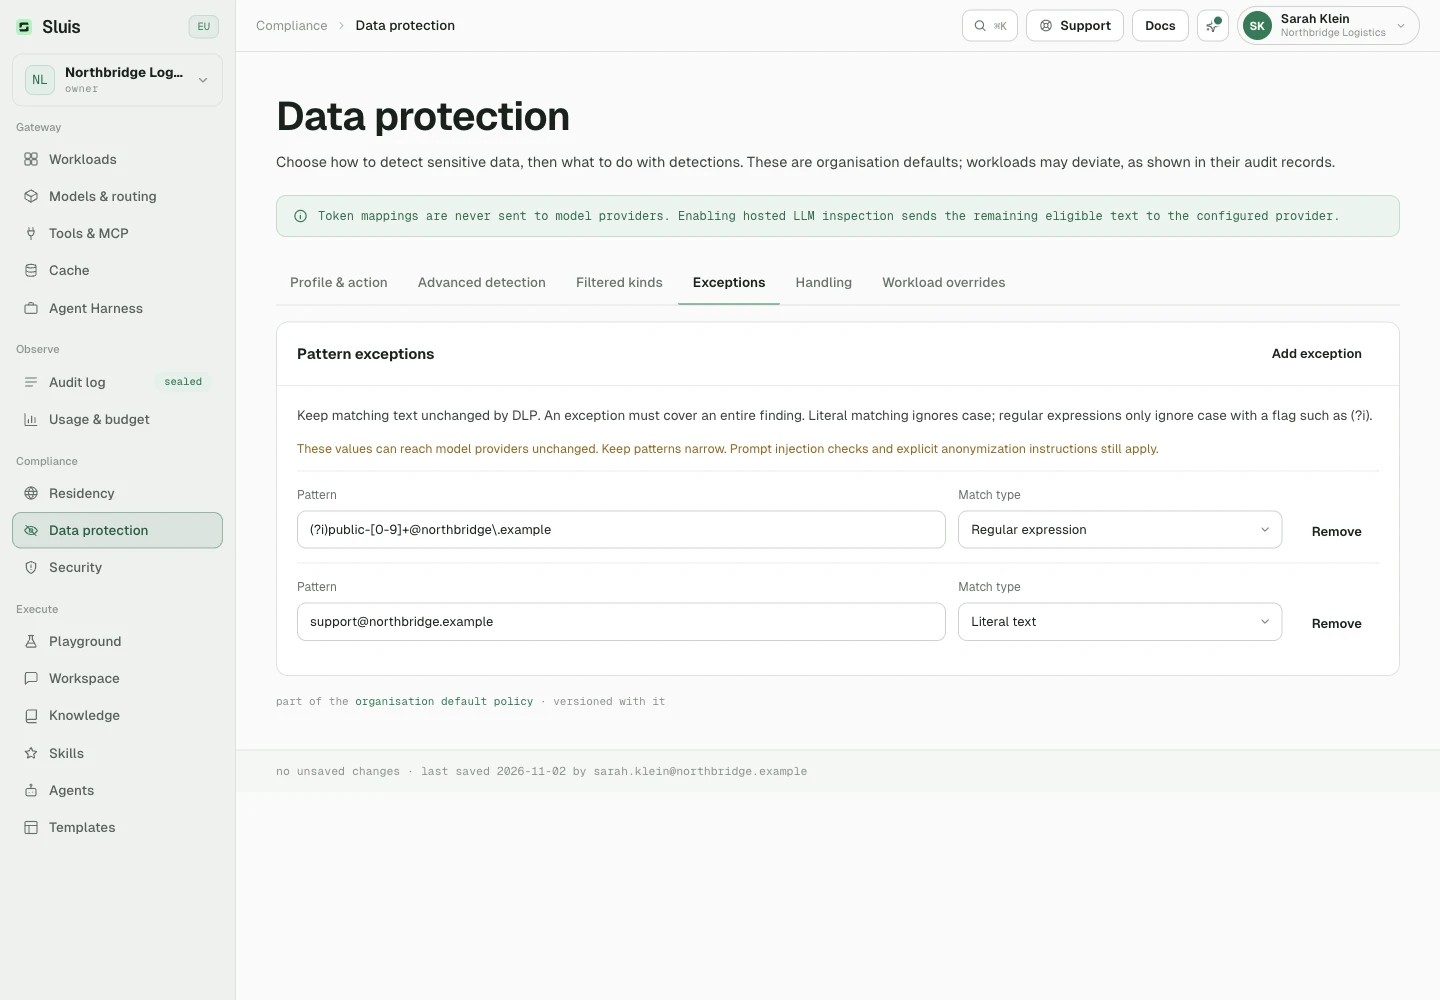
Dans Console › Protection des données › Exceptions, ajoutez un texte littéral ou une expression régulière pour les valeurs que vous souhaitez laisser intactes, comme l’adresse publique support@northbridge.example.
- Les motifs littéraux ignorent la casse, y compris pour les lettres Unicode.
- Les expressions régulières utilisent la syntaxe Rust regex et respectent la casse, sauf si vous ajoutez
(?i). - Une seule correspondance d’exception dans le texte original doit contenir toute la valeur détectée. Une correspondance partielle ne suffit pas ; les correspondances distinctes, adjacentes ou chevauchantes ne sont jamais réunies.
Utilisez des motifs précis. Une valeur exemptée n’est ni pseudonymisée, ni masquée, ni utilisée pour bloquer la requête : son texte original peut donc parvenir au fournisseur du modèle. Les autres valeurs détectées restent protégées.
Les exceptions s’appliquent aux détecteurs intégrés et personnalisés, aux noms, aux dictionnaires et à la reconnaissance d’entités locale ou hébergée, y compris dans le texte protégé des documents et des embeddings. Elles ne désactivent ni l’analyse des injections de prompt ni les autres contrôles de sécurité. Les termes à retirer explicitement via sluis.remove ou une requête de document restent prioritaires.
Détection d'entités
Les personnes, organisations et lieux sont difficiles à repérer par simple motif. Sluis combine plusieurs couches :
- heuristiques de contexte
- corrélation avec les e-mails
- annuaire de noms du tenant
- dictionnaires fournis
- NER facultatif (reconnaissance d’entités nommées)
Le modèle NER tourne comme un sidecar interne au réseau, donc le texte reste dans le périmètre du déploiement. Ces couches inspectent aussi le texte extrait des documents et de l’OCR lorsque la protection des documents est activée.
- Avec le NER activé, une requête peut nommer jusqu’à 100 000 entités distinctes et 6,4 millions de caractères de texte. Au-delà de ce plafond, l’analyse est considérée comme incomplète.
- Un nom que le modèle détecte une fois est remplacé partout où il revient dans la requête : le même mot entier, avec la même casse et le même jeton, y compris dans les messages où le modèle ne l’a pas signalé.
- Les mots génériques isolés et les acronymes courts ne couvrent que l’endroit signalé par le modèle.
Dictionnaire de noms
Le dictionnaire de noms est l’équivalent déterministe du NER : des prénoms et noms de famille compilés à partir de données ouvertes gouvernementales, dans un dictionnaire livré avec la gateway.
- Il reconnaît les noms complets et les noms précédés d’une formule de politesse, sans latence ajoutée et sans que rien ne quitte votre périmètre.
- Les noms qui sont aussi des mots courants ne correspondent qu’avec un contexte en forme de nom autour.
- Les noms rares restent du ressort de l’annuaire ou du NER.
Modèles NER au choix
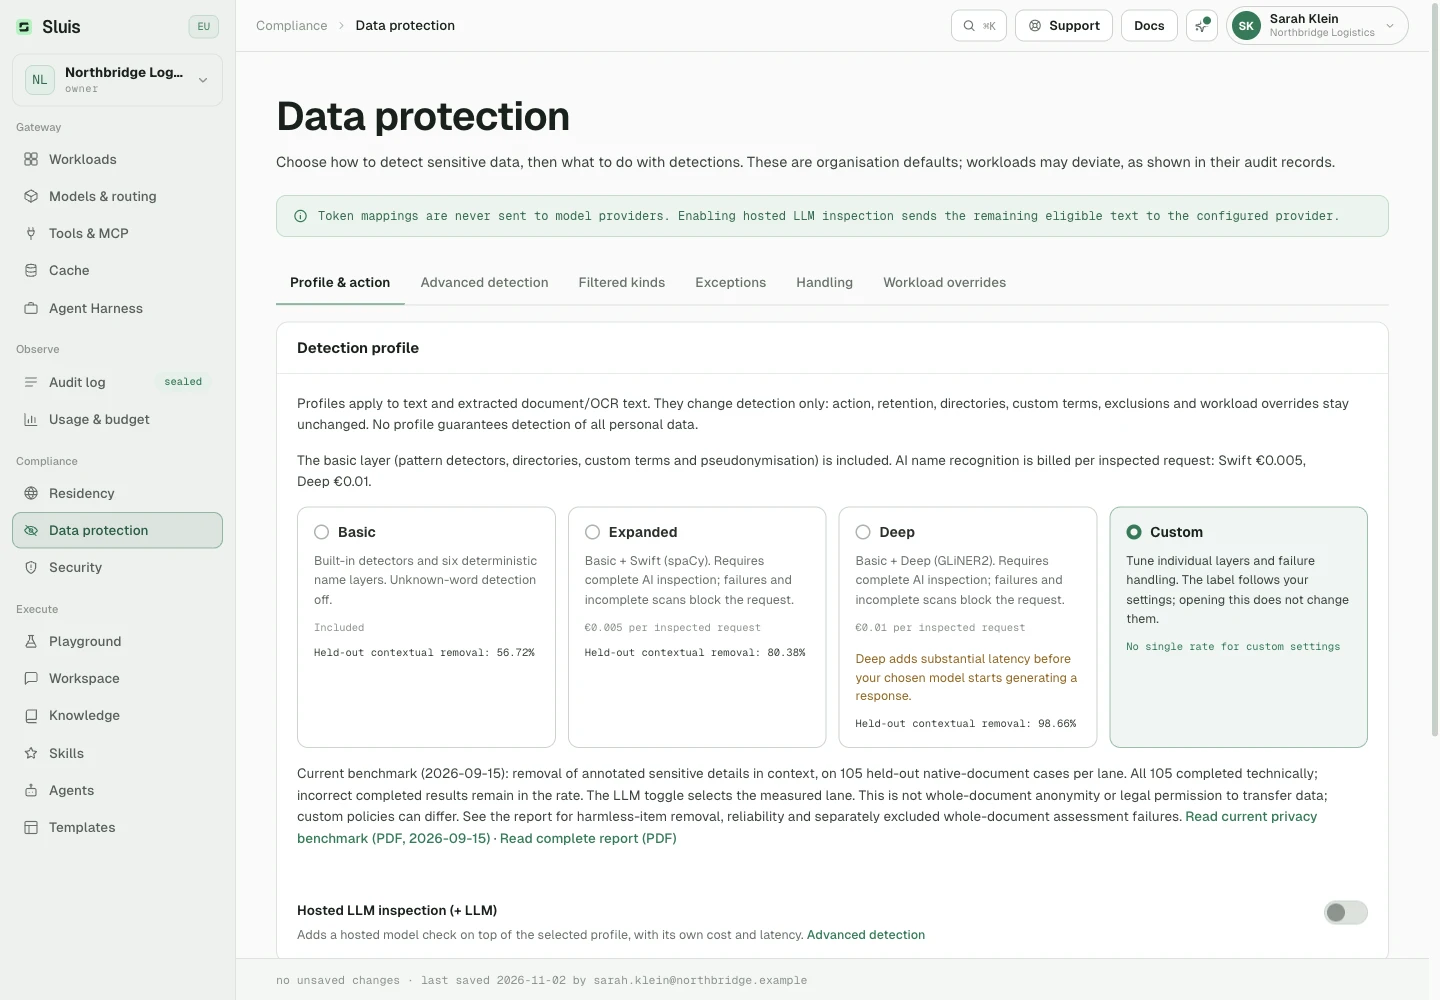
Choisissez Basic, Expanded ou Deep dans Protection des données.
- Basic est le choix par défaut des nouvelles organisations. Il utilise les détecteurs intégrés et six couches déterministes de noms, sans appel à un modèle.
- Expanded ajoute Swift (spaCy).
- Deep ajoute GLiNER2-PII à la place. Il demande plus de temps de traitement, sans garantie de meilleur rappel.
- Custom permet un réglage individuel.
Les deux profils à modèle exigent une inspection complète et bloquent les échecs de modèle ou les analyses incomplètes.
- Les politiques, exclusions, annuaires et dérogations de workload existants restent inchangés.
- La détection des mots inconnus reste désactivée dans les trois profils.
- Un workload peut choisir un modèle NER disponible même lorsque l’organisation l’a désactivé par défaut.
Facturation
- La reconnaissance de noms par IA est facturée une fois par requête client inspectée : 0,005 € avec Swift (Expanded), 0,01 € avec GLiNER2 (Deep). Basic est inclus.
- Les appels de suivi que Sluis effectue au sein de cette requête ne sont pas facturés à nouveau, et une inspection incomplète ne coûte rien.
- Chaque frais correspond à un reçu d’audit lié, qui compte dans vos budgets.
Latence
- Deep ajoute une latence importante avant que le modèle choisi ne commence à générer une réponse.
- Le temps d’analyse de Swift et de GLiNER2 augmente avec la longueur de l’entrée, le nombre de messages et la charge.
- Il n’y a pas de délai limite : sous charge, une requête attend dans une file au lieu d’être refusée, et ne s’arrête que si vous vous déconnectez. Ce n’est pas une garantie de vitesse.
- L’inspection facultative par un LLM hébergé ajoute une attente distincte avant la génération de la réponse, selon la longueur de l’entrée, la charge du fournisseur et les nouvelles tentatives.
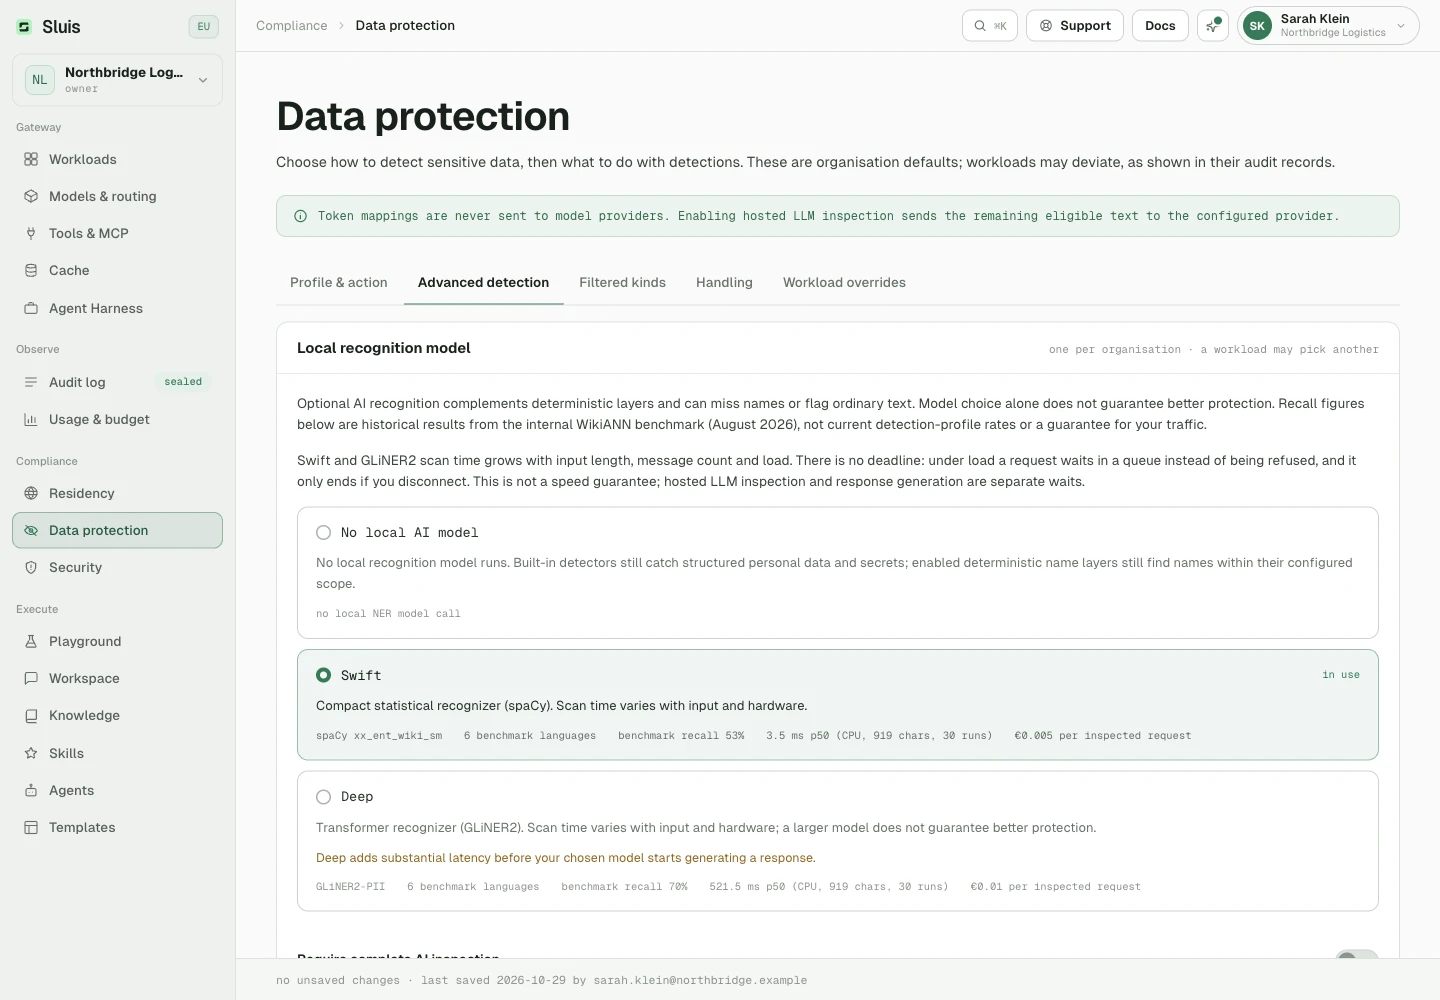
| Modèle | Couverture | Précision mesurée | Latence |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Mesuré le 2026-08-12 sur un benchmark interne : phrases de test WikiANN dans six langues (NL, EN, DE, FR, ES, IT ; 150 par langue), notées en micro-F1 sur des paires (étiquette, texte) au niveau du texte, avec le filtre de faux positifs de production appliqué, sur une machine de développement Apple silicon en FP32. WikiANN est un corpus du domaine Wikipédia, de référence silver, et le terrain de prédilection de spaCy. Lisez ces chiffres comme un repère relatif entre les niveaux, pas comme une précision absolue sur le terrain.
Analyse de sécurité
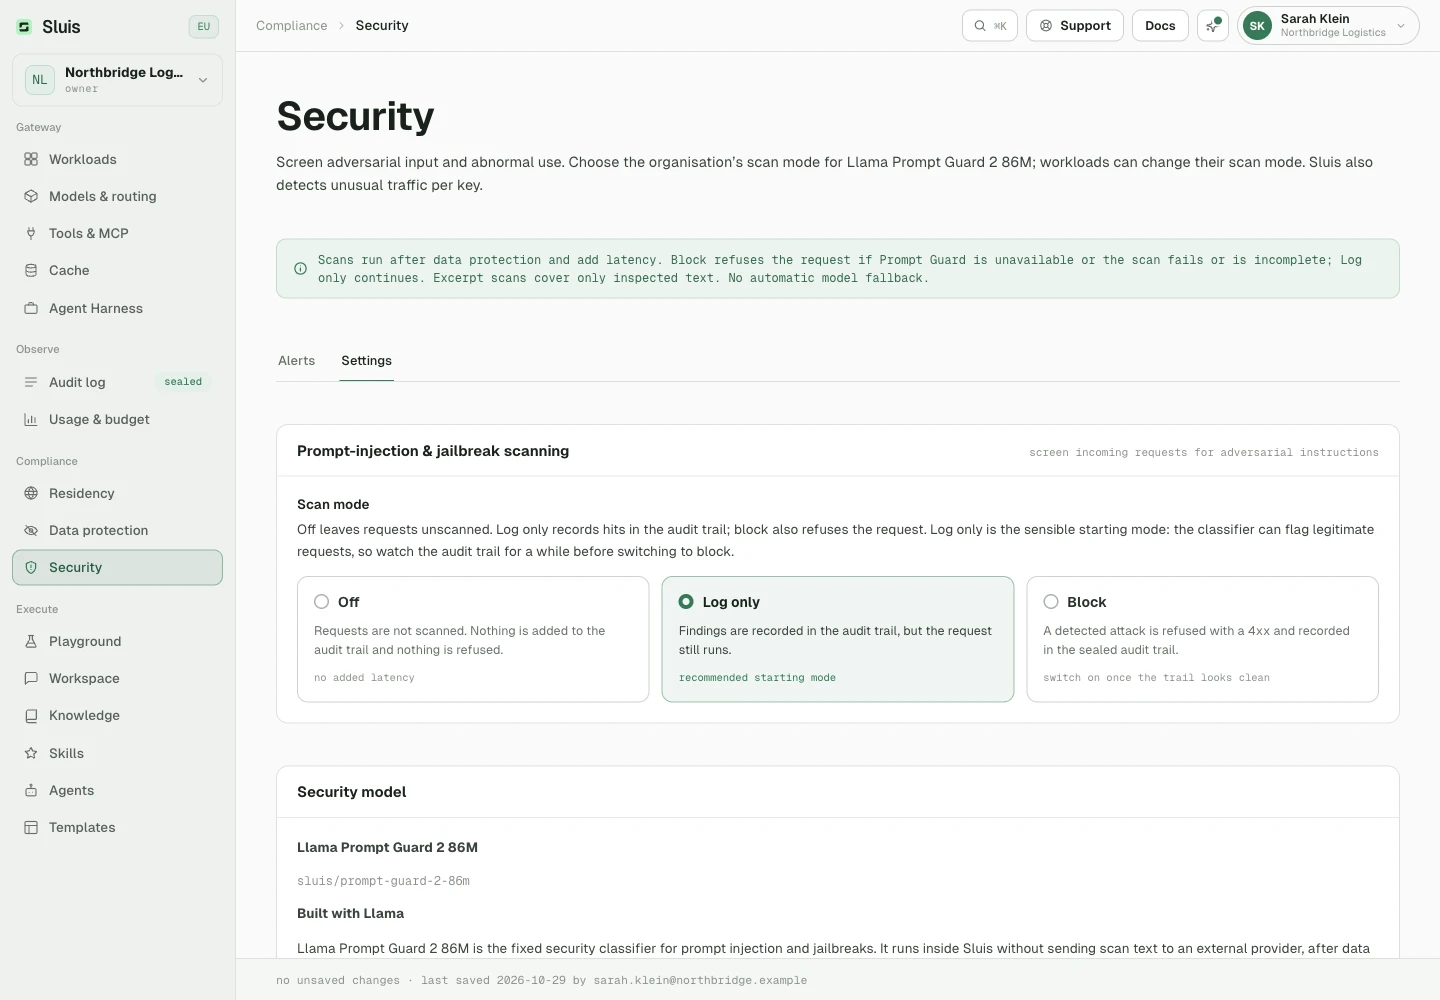
La détection d’injection de prompt et de jailbreak est facultative et s’exécute à l’entrée, avant l’envoi. Elle a trois modes : off | log | block.
offignore l’analyse.logconsigne les constats sans bloquer le trafic.blockrefuse les attaques détectées. Il échoue en mode fermé lorsque Prompt Guard est indisponible ou que la classification échoue ou est incomplète. Il n’y a aucun repli automatique vers un autre modèle.
Fonctionnement de l’analyse
- La sécurité utilise toujours Llama Prompt Guard 2 86M (
sluis/prompt-guard-2-86m), au sein de Sluis, sans transfert externe du texte analysé. - Des fenêtres qui se chevauchent, de 512 jetons de modèle au plus, préservent les limites des segments, dans un budget d’analyse total de 4096 à 65536 jetons (8192 par défaut).
- Le seuil de détection est fixé à 0,8.
- Les longues entrées utilisent des extraits choisis. Un résultat sûr ne couvre que le texte inspecté, pas l’entrée complète. L’enregistrement d’audit conserve les octets inspectés et le total.
- L’analyse suit la protection des données, qui peut conserver des données personnelles lorsqu’elle est désactivée ou en simple journalisation.
- Les analyses ajoutent une latence variable. Elles attendent le scanner jusqu’à sa réponse ou jusqu’à la déconnexion de l’appelant, et il n’y a pas de délai limite d’analyse.
Coût et audit
- 0,01 € par analyse logique terminée, une seule fois quels que soient les fenêtres ou le verdict, y compris les résultats sûrs échantillonnés. Pas de supplément par jeton.
- Les analyses désactivées, les refus préalables et les échecs techniques ne sont pas facturés.
- Chaque analyse a une entrée d’audit facturable distincte et liée :
security.scan. Des frais peuvent s’appliquer même lorsque la requête parente est bloquée ou servie depuis le cache. - Les dérogations de workload peuvent modifier le mode d’analyse.
- Séparément, l’inspection de confidentialité facultative par Nemotron utilise Nebul selon votre politique de résidence et est facturée au jeton.
Built with Llama. Meta Llama 4 Community License.
Détection d’anomalies
La détection d’anomalies de comportement des clés, facultative, s’exécute comme tâche de fond sans aucune latence sur les requêtes : des références par clé fondées sur des statistiques robustes avec saisonnalité heure de la semaine, plus une couche multivariée de forêt d’isolation.
Les alertes sont explicables, jamais un simple score. Elles apparaissent dans la vue Sécurité de la Console, et par e-mail si vous le souhaitez.
Notice au modèle
Lorsque la tokenisation a réécrit une requête, Sluis injecte un message système initial indiquant au modèle que les jetons «…» sont des substituts opaques qu’il doit conserver intacts. C’est ce qui rend la restauration fiable. L’avis est activé par défaut, et vous pouvez le personnaliser ou le désactiver par organisation.
Rétention et fidélité de l'audit
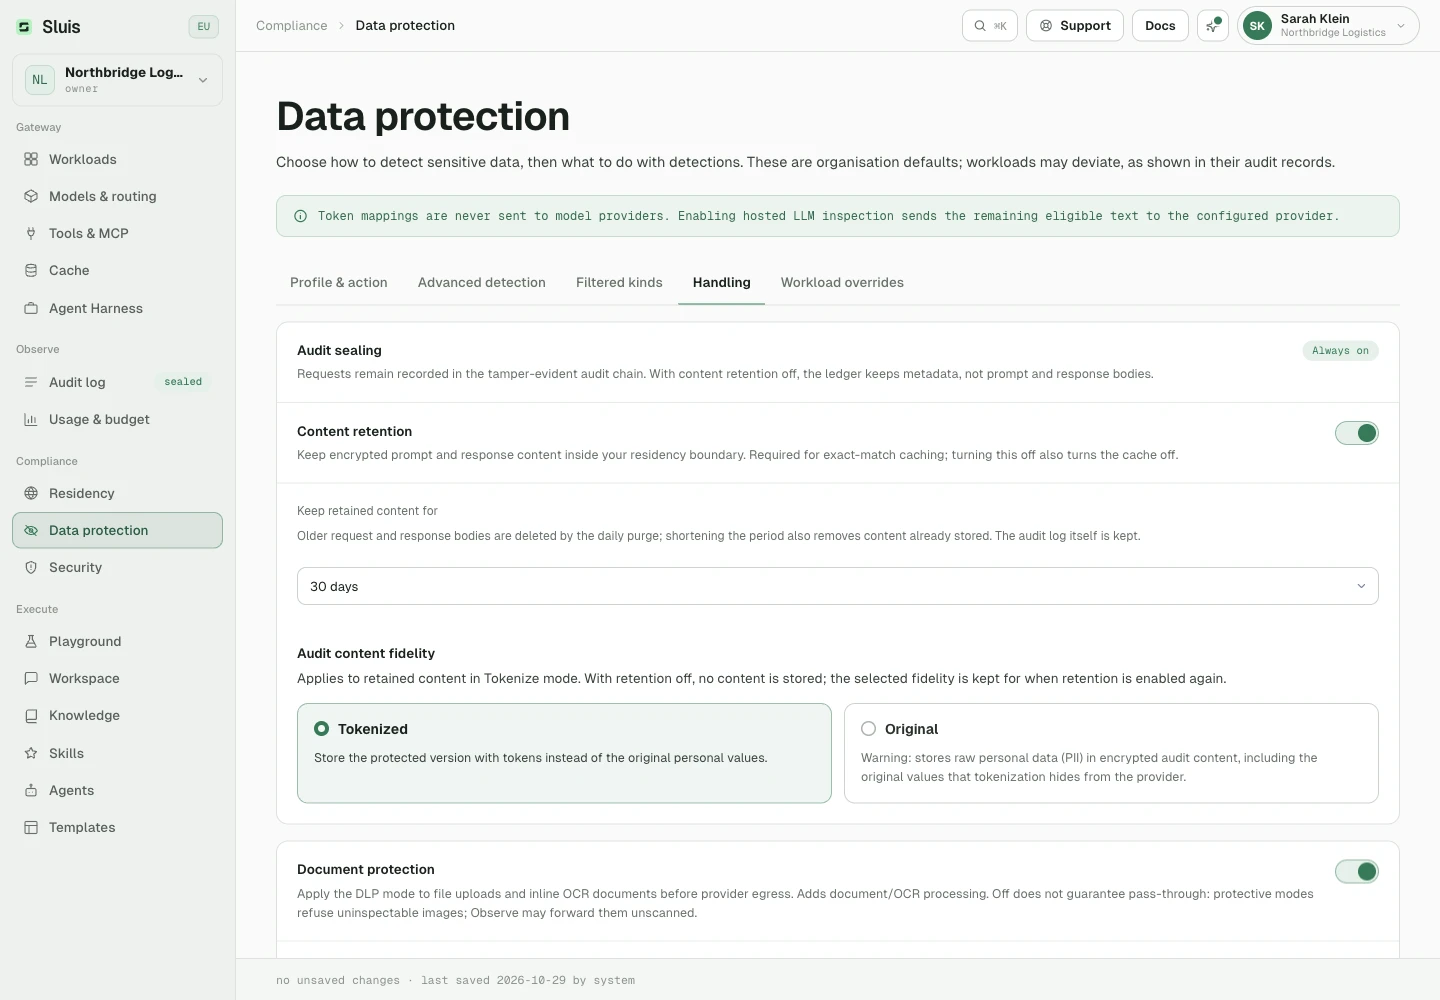
La conservation du contenu garde le corps des requêtes et des réponses pour le journal d’audit. Elle est activée par défaut et chiffrée au repos.
- La fidélité d’audit choisit si le contenu conservé stocke les jetons ou les valeurs d’origine.
- Le contenu conservé expire après 30 jours par défaut. Dans la vue Protection des données de la Console, vous pouvez définir une autre durée en jours (de 1 à 36 500) ou le conserver indéfiniment.
- Une purge quotidienne applique la durée actuelle au contenu déjà stocké : la raccourcir supprime donc aussi le contenu plus ancien.
- Le contenu des chats de Sluis Workspace est supprimé à l’issue de la plus courte entre cette durée et celle du Workspace pour les valeurs personnelles dans les chats (7 jours par défaut).
- Le registre des métadonnées d’audit est conservé et jamais modifié.
- Désactivez la conservation pour obtenir un registre de métadonnées seul. Cela désactive aussi le cache de réponses.
Anonymisation de documents
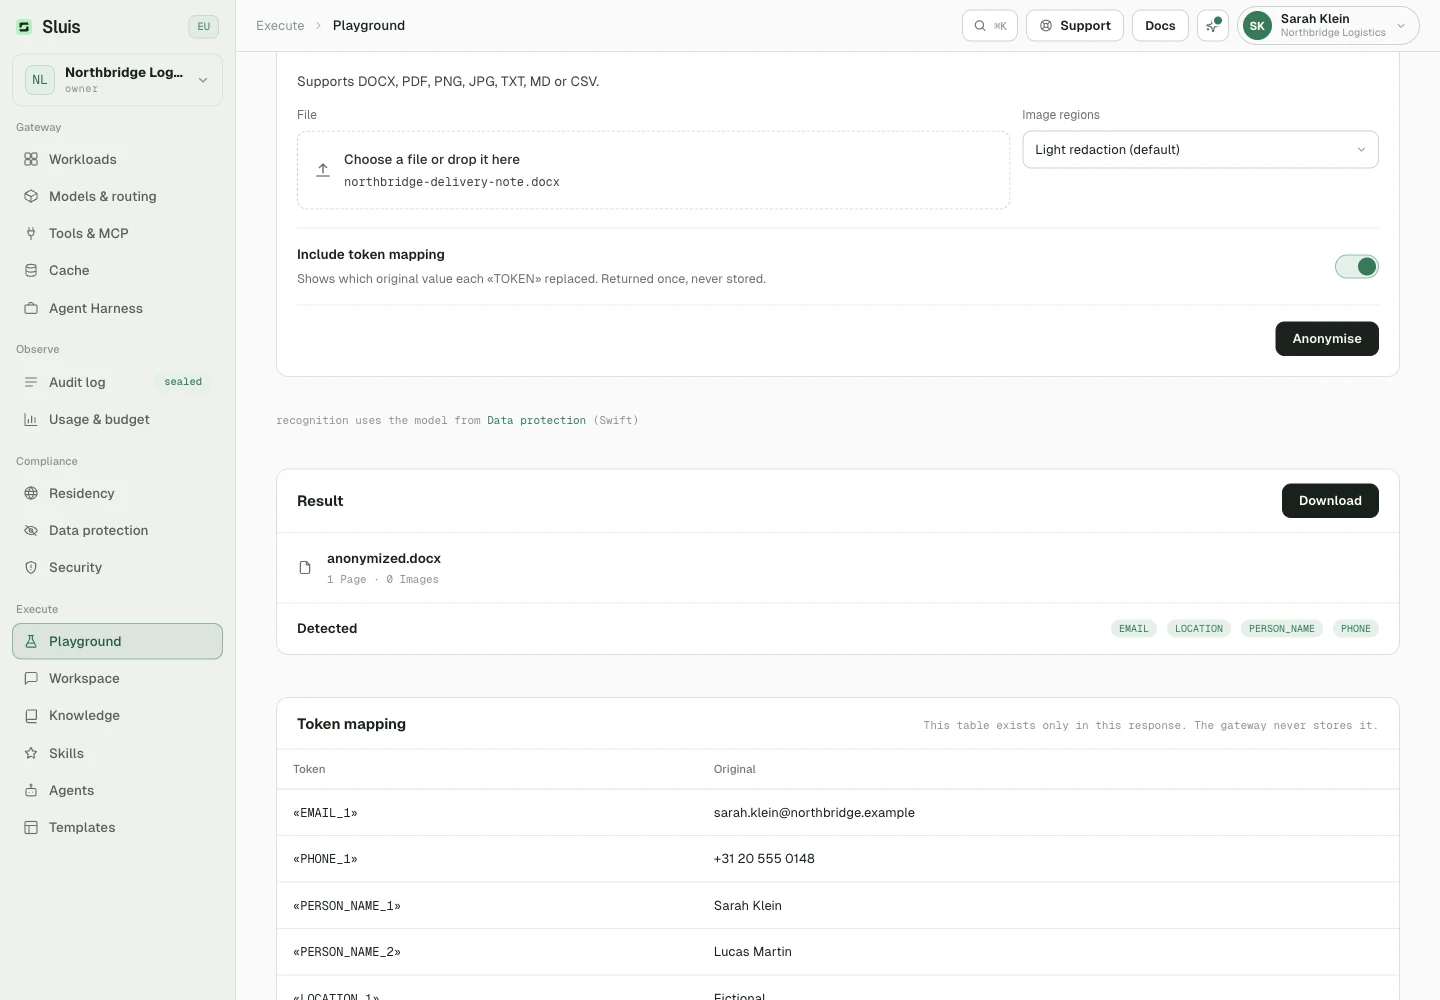
Envoyez un fichier docx, pdf, image ou texte à POST /v1/documents/anonymize : le même document revient avec les données personnelles et les secrets remplacés par des balises comme «PERSON_NAME_1» dans le texte, et floutés dans les images et les pages PDF.
- Le traitement est local à la gateway, OCR compris. L’opération est scellée dans la chaîne d’audit et mesurée à la page ou à l’image.
- Les PDF expurgés gardent une couche de texte invisible et consultable, construite à partir du texte anonymisé.
- Pour les gros documents, mettez en file une tâche asynchrone et récupérez le résultat plus tard via une URL signée à durée limitée.
- Sur les scans, les lignes que l’OCR ne peut pas lire de façon fiable (signatures, écriture illisible) et l’encre hors de toute ligne de texte reconnue (paraphes, tampons) sont détruites plutôt que devinées. Elles apparaissent comme
«UNREADABLE»dans la couche de texte, et la réponse signale la catégorieUNREADABLE_REDACTED.
Correspondance des jetons
Le point de terminaison synchrone ne renvoie la correspondance des jetons que si vous la demandez (include_mapping: true) et que l’appelant y a droit : un workload avec documents et documents_reidentify, ou un propriétaire ou administrateur de la console. La correspondance est scellée dans la chaîne d’audit sous forme de compteurs et de hash, et n’est jamais stockée. Les tâches asynchrones rejettent les demandes de correspondance avec 422.
En transit
La même protection s’applique en transit. Avec la politique dlp_documents activée, les fichiers téléversés via /v1/files et les documents OCR en ligne sont anonymisés avant de partir vers un fournisseur, refusés sous block, et analysés sous allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Les jetons pseudonymisés sont stables au sein d’une requête, pas d’une requête à l’autre : les embeddings d’un texte tokenisé peuvent donc différer entre deux appels.
Le paramètre de politique dlp_embeddings détermine si l’analyse couvre /v1/embeddings. Il est activé par défaut. Le mettre sur off envoie les entrées d’embedding au fournisseur sans analyse, et chaque appel exempté est consigné dans la piste d’audit.
Termes à retirer par requête
Toute requête JSON du plan de données (chat completions, completions, embeddings, responses et les entrées natives Anthropic) peut porter une extension sluis de premier niveau avec une liste remove. Elle nomme les termes que la gateway doit retirer du prompt avant l’envoi.
- Chaque entrée est une simple chaîne, ou un objet avec un
textet unkindvalantperson | organization | location | term. - 128 entrées au plus. Chacune doit être non vide après suppression des espaces et faire 256 caractères au plus.
- La correspondance se fait par mot entier, sans tenir compte de la casse.
- L’extension est une construction de la gateway. Elle est toujours retirée avant l’envoi et n’atteint jamais un fournisseur, le cache ni le contenu conservé.
# name the terms the gateway must remove: the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out: the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Ce qui arrive à une correspondance
Chaque correspondance devient un jeton réversible comme «PERSON_NAME_1», qui rejoint la passe normale de pseudonymisation :
- Sous
tokenize, le mode par défaut, les valeurs d’origine sont restaurées dans la réponse, y compris en streaming. - Sous
mask, le terme est remplacé par[REDACTED:<kind>]. - Sous
block, la requête est refusée avec422.
L’instruction est toujours respectée, même lorsque le workload définit dlp: off, que l’organisation fonctionne en allow_log, ou que /v1/embeddings est exempté. Elle ne peut que renforcer la protection, jamais l’affaiblir : c’est pourquoi elle est permise par requête, contrairement à l’en-tête retiré x-sluis-dlp. Le terme listé n’atteint jamais le fournisseur.
Erreurs et audit
- Une directive mal formée n’est jamais ignorée en silence. Un type inconnu, une entrée hors limites ou un champ inconnu dans l’extension est refusé avec
422. - Ce qui s’est réellement exécuté est indiqué sur la ligne d’audit scellée. Les termes fournis par l’appelant portent la couche requête,
dlp:tokenize:person_name(request), distincte des couches(ner)et(directory), si bien que la piste montre d’où vient chaque retrait. - Le point de terminaison synchrone
/v1/documents/anonymizeaccepte la même liste comme optionremove. Les tâches asynchrones la rejettent avec422.
Dérogations du workload
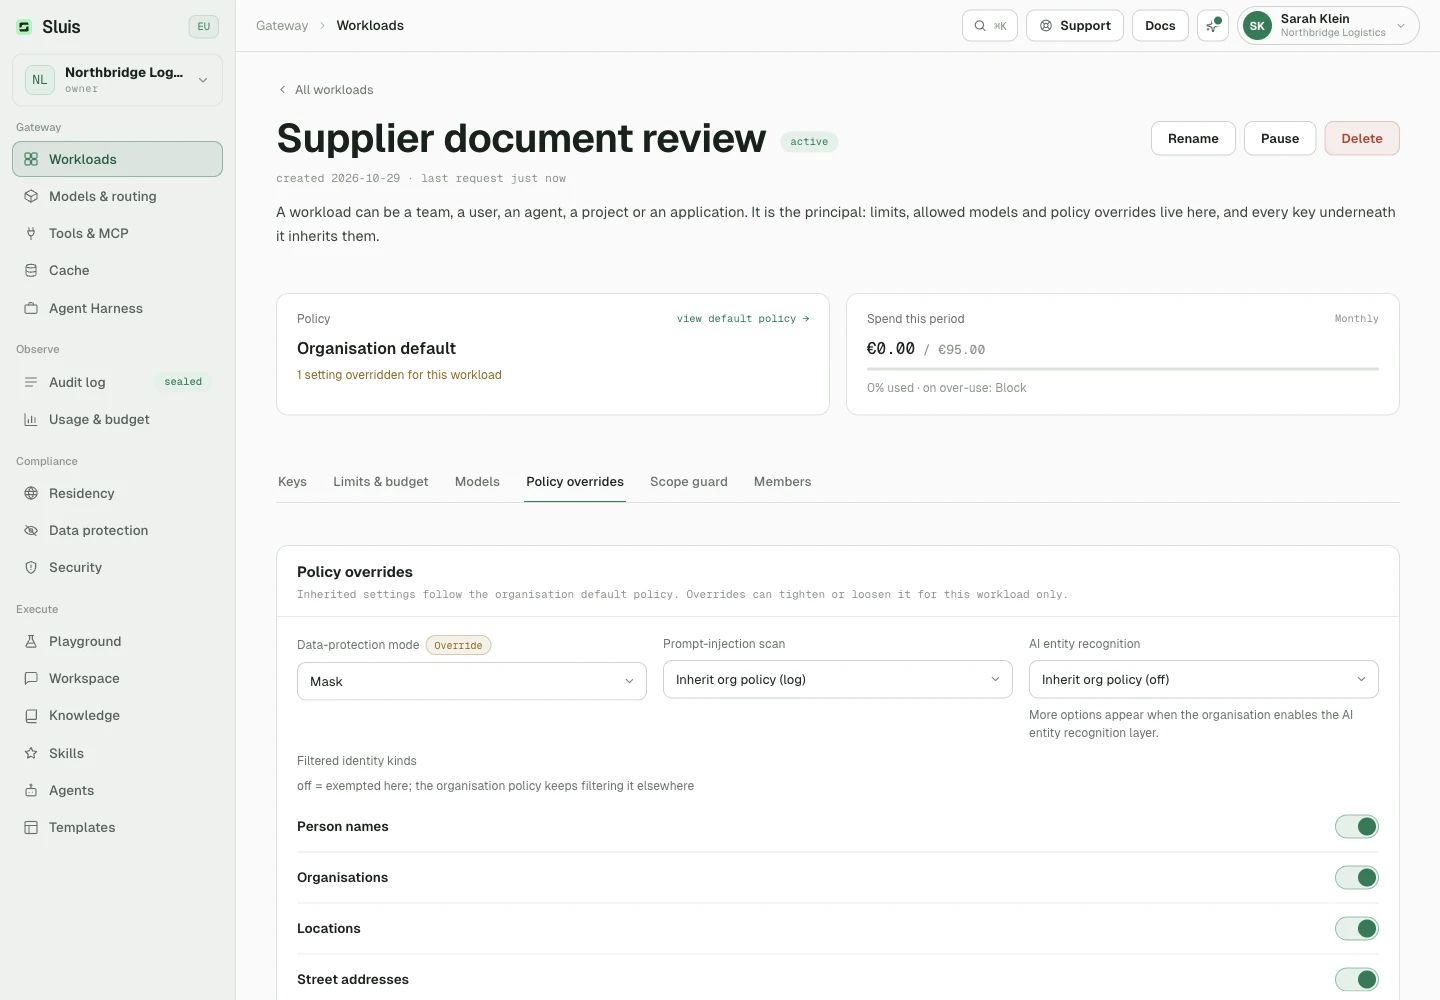
Les dérogations appartiennent au workload et s’appliquent à tous ses identifiants. Les options que vous laissez vides héritent de la politique de l’organisation.
Choisissez ner_model : off, swift ou deep. Sous dlp.entities, réglez les catégories de noms et sous dlp.detectors, les détecteurs intégrés comme record_id ou vat_number. Les choix absents héritent des paramètres de l’organisation. Ils s’appliquent aussi aux documents et images, selon l’activation et l’action de protection de l’organisation. Un autre détecteur peut toujours trouver la même valeur.
- Dans la Console, un propriétaire ou administrateur configure
option_overridessous Workloads. - Via l’API, définissez
option_overridesavecPOST /admin/workloadsà la création d’un workload.
Pour modifier un workload existant, PATCH /admin/workloads/{workload_id} exige l’ensemble de ses paramètres modifiables, dont le nom, le statut, les limites et le budget. Il les remplace au lieu de fusionner champ par champ.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "entities": { "person": true }, "detectors": { "record_id": false } },
        "ner_model": "swift",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
L’en-tête de requête x-sluis-dlp a été retiré. Les requêtes qui le portent reçoivent 400 : configurez donc le workload à la place. Les dérogations effectives sont consignées dans la piste d’audit scellée.