Référence API
Authentification, endpoints, streaming, raisonnement et erreurs sur la surface OpenAI, API natives Anthropic et matrice de compatibilité par endpoint.
Authentification
Chaque requête vers /v1/* s’authentifie avec une clé virtuelle dans l’en-tête Authorization: Bearer. Créez des clés sous Workloads dans la Console.
- Le secret n’est affiché qu’une fois, et seul son hash est stocké.
- Une clé est un identifiant pour un workload. Le workload porte les limites de débit, le budget, les modèles autorisés et les dérogations de politique. La politique de l’organisation continue de s’appliquer.
- Une clé peut porter une date d’expiration facultative. Passé ce terme, elle est refusée exactement comme une clé inconnue.
- Un modèle absent de la liste d’autorisation non vide du workload est refusé avec un
403 permission_errorscellé avant tout envoi. Le refus lui-même est inscrit dans la chaîne d’audit. - Un workload peut limiter ses clés à des familles d’endpoints, par exemple chat et embeddings. Les autres familles reçoivent un
403 operation_not_allowedscellé avant tout envoi. - Créer une clé de production exige une adresse e-mail vérifiée.
- Une exception : les liens de téléchargement signés et à durée limitée des documents anonymisés n’exigent aucune clé.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the workload's allow-list never dispatches:
# → 403 permission_error, and the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    {
      "id": "mistral/mistral-large-latest",
      "object": "model",
      "created": 1704067200,
      "owned_by": "mistral",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": 0.55,
        "output_eur_per_mtok": 1.65,
        "cached_input_eur_per_mtok": 0.055,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }],
        "eur_per_page": null,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    },
    {
      "id": "sluis/fast",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": "mistral/mistral-large-latest",
      "pricing": { "input_eur_per_mtok": 0.55, "output_eur_per_mtok": 1.65, "cached_input_eur_per_mtok": 0.055, "audio_input_eur_per_mtok": null, "audio_output_eur_per_mtok": null, "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }], "eur_per_page": null, "eur_per_minute": null, "eur_per_image": null, "estimated": false }
    },
    {
      "id": "sluis/auto",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": null,
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": null
    },
    {
      "id": "sluis/ocr",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "ocr",
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": null,
        "output_eur_per_mtok": null,
        "cached_input_eur_per_mtok": null,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [],
        "eur_per_page": 0.01,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    }
  ]
}
Endpoints
Sluis expose la surface compatible OpenAI ci-dessous, ainsi que les chemins natifs Anthropic décrits plus bas.
Les endpoints sans gestionnaire de premier niveau sont relayés tels quels vers le fournisseur routé, streaming compris, afin que les upstreams compatibles OpenAI conservent une fidélité totale.
Un navigateur qui ouvre un chemin que l’API ne sert pas, comme l’hôte API seul, est redirigé vers cette documentation. Les clients API reçoivent toujours un simple 404.
| Endpoint | Rôle |
|---|---|
| POST / | Chat completions, la surface principale : routage, protection des données, mise en cache, streaming. |
| POST / | Text completions historiques. |
| POST / | Embeddings. |
| POST / | Classification de modération. |
| POST / | L’API OpenAI Responses. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | OCR de documents (Mistral, ou entièrement local avec le modèle sluis/ocr), facturé à la page. Avec la politique dlp_documents active, les documents inline sont anonymisés avant de partir. |
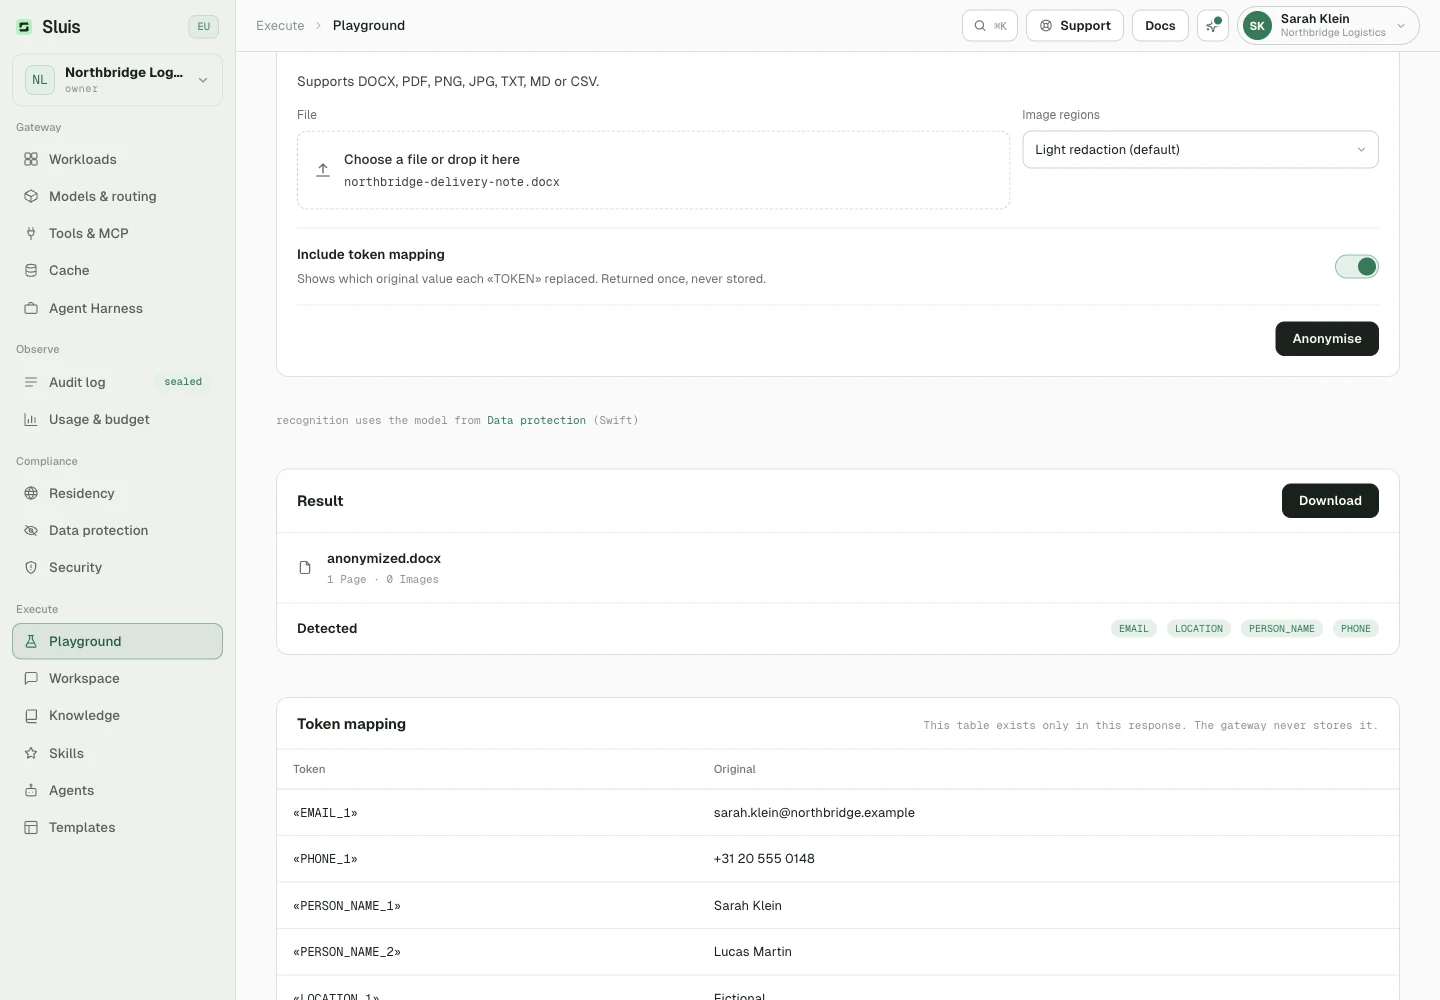
| POST / | Anonymisation de documents : les données personnelles deviennent des «MERGE_TAG»s, les images sont floutées. Facturé par page ou par image. |
| POST / | Jobs d’anonymisation asynchrones : mettez un gros document en file, suivez /jobs/{id} et récupérez /jobs/{id}/result. Le lien de téléchargement signé (/v1/documents/deliverables/{id}) est à durée limitée et n’exige aucune clé API. |
| GET / | Modèles autorisés par votre politique, vos identifiants et votre workload, avec type, fenêtre de contexte, capacités, résidence, cible d’alias et prix final de cette organisation en EUR, hors TVA. |
| GET / | Métadonnées et prix propres à l’organisation pour un modèle, au même format que la liste. |
| POST / | Transcription, traduction et synthèse vocale, relayées vers le fournisseur routé. Avec le modèle sluis/transcribe, POST /v1/audio/transcriptions exécute la transcription vocale propre à Sluis, avec détection des locuteurs. Voir Transcription vocale. |
| POST / | Génération et retouche d’images, relayées. mistral/image-generation fait exception : Mistral ne la sert que via son connecteur agent, donc la gateway traduit la requête OpenAI et répond en b64_json, facturé à l’image. |
| POST / | Génération de vidéo, relayée. |
| / | Opérations sur fichiers, relayées avec la propre clé de votre organisation (BYOK ou fournisseur personnalisé). Les fichiers avec purpose=batch font exception : ils passent par le contrôle propre à la gateway et peuvent utiliser des clés gérées. |
| / | Lots à la forme OpenAI : envoyez un fichier JSONL avec purpose=batch à /v1/files, puis créez, suivez et annulez ici. Chaque ligne passe la protection des données et la résidence comme un appel live. Résultats sous 24 heures, facturés à la moitié du prix live. Mistral, Azure, OpenAI et Qwen. |
| POST / | Anthropic Message Batches : créer, lister, obtenir, résultats et annuler. Désactivés sauf si votre déploiement les active. Ils exigent la conservation du contenu et ne tournent que sur des modèles Anthropic. Sinon, ces routes renvoient 404. |
| POST / | Entrée native Anthropic Messages : pointez n’importe quel outil SDK Anthropic vers Sluis, avec n’importe quel modèle connecté. |
| POST / | Estimation locale de tokens pour la gestion de contexte du SDK Anthropic. Rien n’est envoyé. |
| GET / | Découverte native des modèles Anthropic (list et get), depuis le catalogue en mémoire. Sur /v1/models, l’en-tête anthropic-version sélectionne cette même forme. |
| HEAD / | Sonde de préchauffage pour les clients du SDK Anthropic comme Claude Code : 200 avec un corps vide. |
| GET / | WebSocket compatible OpenAI Realtime pour la voix en direct (speech to speech) avec vertex/gemini-3.8-live, hébergé en multi-région UE sur Google Vertex AI. Aussi servi sur /openai/v1/realtime ; le paramètre de requête model est obligatoire. Authentifiez la requête d'upgrade avec Authorization: Bearer ou x-api-key. Il parle les noms d'événements GA ; les formats bêta OpenAI-Beta: realtime=v1, les secrets client éphémères, les clés par sous-protocole navigateur et l'audio G.711 ne sont pas pris en charge. Les outils côté serveur, la reprise de session, la réplication de voix et la sortie avatar sont refusés à l'initialisation. Le texte est protégé comme sur tout endpoint ; les trames audio et vidéo sont transmises sans inspection. Une session se termine à un plafond de dépense de 2 EUR, et le fournisseur ferme une connexion après environ 10 minutes ; reconnectez-vous pour continuer. Facturation par token aux tarifs par modalité du modèle (texte, audio, trames image et vidéo), d'après le rapport d'usage du fournisseur. Indisponible dans Sluis Workspace, le Playground et les alias sluis/*. La liste complète des événements figure dans l'agent skill. |
| GET / | WebSocket Gemini Live natif (BidiGenerateContent), aussi sur /ws/google.cloud.aiplatform.v1.LlmBidiService/BidiGenerateContent ; la version dans le nom du service peut être v1, v1beta, v1beta1 ou v1alpha. Un SDK google-genai dont l'URL de base est l'origine de la gateway se connecte sans modification. Authentifiez la requête d'upgrade avec x-goog-api-key, Authorization: Bearer ou x-api-key ; le paramètre de requête ?key= n'est pas accepté. Les trames sont relayées telles que les définit le protocole Gemini Live, et setup.model vaut gemini-3.8-live. Les refus arrivent sous forme de trame de fermeture WebSocket avec la raison en texte. Même modèle, mêmes limites, même protection des données et même facturation que /v1/realtime. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Chaque corps JSON ci-dessus peut aussi porter l'extension gateway sluis.remove, qui nomme les termes à pseudonymiser dans le prompt avant l'envoi. Elle est retirée avant que la requête ne quitte la gateway ; voir la Référence protection des données.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}
Transcription vocale avec détection des locuteurs
Définissez le modèle sur sluis/transcribe et envoyez POST /v1/audio/transcriptions. La gateway exécute sa propre transcription vocale, sans sortie vers un fournisseur.
- Envoyez un
filemultipart jusqu’à 240 minutes. La langue est détectée automatiquement. response_formatvautjson(par défaut),textouverbose_json(segments avec un locuteur).- Facturé 0,02 € par minute d’audio, par seconde entamée.
- Le mode DLP de l’organisation s’applique à la transcription, comme pour
sluis/ocr. - Répond
503là où le déploiement n’exécute pas la transcription.
# Speech to text with speaker detection, billed €0.02 per minute of audio (per started second).
# model "sluis/transcribe" runs in the gateway's own worker: no provider egress, language detected automatically.
curl https://api.sluis.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F model=sluis/transcribe \
  -F response_format=verbose_json \
  -F file=@meeting.m4a
{
  "task": "transcribe",
  "duration": 94.2,
  "text": "Goedemorgen allemaal.\nGoedemorgen, fijn dat jullie er zijn.",
  "segments": [
    { "id": 0, "start": 0.4, "end": 2.1, "text": "Goedemorgen allemaal.", "speaker": "speaker_1" },
    { "id": 1, "start": 2.6, "end": 5.0, "text": "Goedemorgen, fijn dat jullie er zijn.", "speaker": "speaker_2" }
  ],
  "usage": { "type": "duration", "seconds": 95 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"] }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local router contract (sluis/typed/router) | Behaviour |
|---|---|
| Model ids | sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. For your own questions, use a typesafe/jev-* model with your own TypeSafe key. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. The other rows describe sluis/typed/router only. |
| Availability | Every answer comes from verified model weights, reported as revision. If the router is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. |
| Response | JSON with model, answers, decision and revision (weights SHA256). Each answer has its type, its typed value (choice, score or noul), confidence, probabilities, legend and answer_confidence. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. |
| Data protection | Tenant DLP applies locally to the state: block refuses; tokenize or mask rewrites what the router is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The router reports no token count, so input is estimated at about 4 characters per token over the state it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local router. |
Documents en entrée
Joignez un PDF, un document Word, une image ou un fichier texte à une requête chat comme part de contenu "type": "file" portant une URL de données file_data en base64.
N’importe quel modèle routé l’accepte. Les fournisseurs qui comprennent nativement les parts de fichier les reçoivent inchangées. Pour tous les autres, la gateway convertit le document avant l’envoi.
Comment le modèle reçoit le document
- Avec un moteur de rendu PDF, les modèles avec vision reçoivent chaque page du PDF comme part
image_url. Le budget est de 48 pages par requête, partagé entre tous les documents joints, et des limites du fournisseur peuvent s’appliquer. Sans moteur de rendu, le repli du déploiement extrait le texte ou refuse. - Les modèles sans entrée image reçoivent le texte extractible du document comme texte de prompt. L’analyse de protection des données le couvre ensuite comme tout autre texte.
- Les documents plus longs ou plus lourds relèvent de
/v1/ocr. - L’API Responses prend des parts
input_fileau lieu de la formefileimbriquée des chat completions. - Sluis ne peut ni inspecter ni résoudre les références
file_idcôté fournisseur. Elles ne passent que vers un fournisseur qui les prend en charge, avec votre propre clé de fournisseur et l’inspection des documents désactivée. Sinon, insérez les octets enfile_data.
Protection des données pour les documents
- Avec la politique
dlp_documentsactivée, le document est anonymisé ou refusé avant que quoi que ce soit ne quitte la gateway. - Si elle est désactivée et que le mode DLP est protecteur (
tokenize,maskoublock), les documents qui voyageraient comme images non inspectables sont refusés. Enallow_log, ils passent avec un marqueur explicite « non analysé » dans le journal d’audit. - Les parties audio (
input_audio) ne peuvent pas être analysées.block, ou la reconnaissance IA obligatoire avec l’inspection des documents activée, les refuse avec422. Sinon, elles portentx-sluis-unscanned: audio.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Définissez stream: true et la réponse arrive sous forme de server-sent events. Chaque frame est un delta chat.completion.chunk, et le flux se termine par data: [DONE].
Les flux ne sont jamais mis en tampon dans la gateway : ils la traversent en dérivation, et le sceau d’audit ainsi que le comptage se produisent même si le client raccroche tôt.
Demandez stream_options.include_usage et la gateway réclame au fournisseur un frame final d’usage. Si le fournisseur n’en envoie pas, ou si le flux est coupé, la gateway estime l’usage pour le comptage.
Vous voulez voir ce qu’un appel en streaming a coûté à votre organisation ? Envoyez x-sluis-include-cost: true avec stream_options.include_usage. L’objet d’usage final contient alors sluis_cost_eur, voir Coût d’un appel.
Bedrock sépare le raisonnement de la réponse dans reasoning_content et reasoning_signature, y compris dans les deltas diffusés. Les refus utilisent finish_reason: content_filter, les limites de sortie length, même avec des appels d’outils partiels. N’exécutez pas d’arguments d’outils incomplets. Les exceptions de flux AWS deviennent des frames d’erreur sans détails sensibles.
Keepalive, en-têtes et redémarrages
- Après 15 secondes sans frame, la gateway écrit une ligne de commentaire SSE (
: keepalive) entre les événements, afin que les proxys à délai d’inactivité gardent la connexion ouverte pendant qu’un modèle réfléchit. Les clients SSE l’ignorent. - Les flux portent
Cache-Control: no-cacheetX-Accel-Buffering: no. - Quand une réplique de la gateway redémarre, elle continue de servir les flux ouverts jusqu’à cinq minutes. Un flux encore ouvert ensuite se termine par un événement d’erreur de code
server_restarting: relancez alors la requête. - Les flux tokenisés acceptent des événements individuels jusqu’à 4 Mio. Les événements plus gros terminent le flux par une erreur.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Raisonnement
Passez le paramètre OpenAI reasoning_effort (minimal | low | medium | high) sur n’importe quel modèle capable de raisonnement. Sluis le traduit selon le fournisseur (le niveau de réflexion de Gemini, l’effort de réflexion adaptatif de Claude) et l’omet là où un modèle le rejetterait, de sorte qu’un seul paramètre fonctionne sur tout le catalogue.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Cache de prompt
Les préfixes de prompt répétés (prompts système, outils, historique de conversation) peuvent être mis en cache chez le fournisseur pour réduire le coût et la latence. Sluis traduit selon le fournisseur les blocs cache_control de type Anthropic (TTL optionnel de 5m ou 1h) ainsi que prompt_cache_key et prompt_cache_retention de premier niveau d’OpenAI.
Plusieurs limites de cache système ou assistant peuvent fusionner lors de la traduction, y compris avec des TTL différents.
| Fournisseur | Comportement du cache de prompt |
|---|---|
| Anthropic | cache_control explicite sur les blocs système, le contenu et les outils, TTL compris. Lectures et écritures sont rapportées séparément. |
| Bedrock | cache_control devient des blocs cachePoint Converse dans system, messages et toolConfig. |
| OpenAI · Azure | Cache automatique. Après activation, prompt_cache_key et prompt_cache_retention sont conservés pour chat et Responses ; options et marqueurs non pris en charge sont retirés. |
| Gemini · Vertex | Le cache implicite Gemini et son usage sont pris en charge ; les références explicites cachedContent ne le sont pas. Claude sur Vertex traduit cache_control et le TTL comme Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Cache automatique si proposé ; toutes les directives explicites sont retirées. Le champ natif usage.cached_tokens de Moonshot est reconnu. |
| Scaleway | Cache automatique si proposé ; toutes les directives explicites sont retirées. Les lectures utilisent le tarif officiel Scaleway en EUR des entrées en cache si disponible, pas LiteLLM. |
| Nebul | Cache automatique si proposé ; toutes les directives explicites sont retirées. Les lectures utilisent le tarif officiel en EUR des entrées en cache si disponible. |
| Nebius · nebius-eu | Cache automatique si proposé ; toutes les directives explicites sont retirées. Les prix officiels ne reprennent pas les remises cache LiteLLM ; le repli LiteLLM peut fournir un tarif cache en l'absence de prix officiel du modèle. |
| Custom | Après activation par l'organisation, les directives sont transmises intactes ; leur prise en charge relève du contrat de l'opérateur. |
Le cache de prompt explicite est opt-in
Le cache de prompt explicite est un réglage au niveau de l’organisation (provider_prompt_cache). Il est désactivé par défaut et indépendant de la conservation du contenu Sluis et du cache de réponses exactes. Activez-le dans Console › Protection des données.
- Les préfixes en cache restent chez le fournisseur après filtrage par la protection des données Sluis.
- Désactivé, le contrôle retire
prompt_cache_key,prompt_cache_retention,prompt_cache_options,cache_controletprompt_cache_breakpoint. Il ne désactive pas le cache automatique propre au fournisseur. - Sans votre propre clé pour un fournisseur, les appels passent par un identifiant Sluis partagé avec d’autres organisations. Chez OpenAI et Azure, Sluis fixe à la place de la vôtre une
prompt_cache_keydérivée de votre organisation. Chez tous les autres fournisseurs, les compteurs de tokens en cache de votre usage affichent 0. La facturation applique quand même la vraie remise de cache.
Facturation et limites
- Les lectures et écritures de cache sont des sous-ensembles du total des tokens du prompt, pas des entrées supplémentaires. Les lectures utilisent le tarif cache disponible.
- Les écritures Anthropic 1h utilisent le tarif propre au TTL quand la ventilation d’usage et le tarif sont disponibles. Sinon, le tarif de création par défaut s’applique.
- Un tarif cache manquant signifie le tarif d’entrée ordinaire, jamais une facturation nulle.
- L’usage du cache apparaît dans le tiroir d’audit et dans Utilisation et budget.
- Les longs prompts sont facturés au tarif long contexte du fournisseur. Dès que le prompt (tokens en cache compris) dépasse le seuil du modèle, tout l’appel est facturé à ce tarif. Il est indiqué sous le prix dans le tableau des modèles.
Avec une clé gérée par Sluis, Sluis refuse une requête avec 400, avant tout envoi, lorsqu’elle choisit un supplément que Sluis ne peut pas mesurer :
- un
cache_controlavec unttlautre que5m, là où le fournisseur le respecte (Anthropic, Bedrock, Claude sur Vertex) - un
service_tierautre queauto,default,flexoustandard_only - la bêta long contexte d’Anthropic (
context-1m) sur un modèle pour lequel Sluis n’a pas de tarif long contexte
Votre propre clé de fournisseur transmet ces trois cas inchangés.
Codes d'erreur
Les erreurs utilisent l'enveloppe d'erreur OpenAI ; la valeur error.type reflète le statut HTTP, si bien que la gestion d'erreurs de votre SDK continue de fonctionner sans changement.
| Code | Quand |
|---|---|
| 400 invalid_request_error | Corps de requête ou paramètres mal formés. |
| 400 invalid_request_error | Identifiant de modèle sans préfixe de fournisseur. Chaque identifiant appelable est provider/model, par exemple mistral/mistral-large-latest. Le message indique : model must be provider-prefixed. |
| 400 invalid_request_error | La requête porte l’en-tête x-sluis-dlp, supprimé. Les dérogations par requête ont été remplacées par les dérogations d’options par workload : configurez-les dans Console › Workloads. |
| 401 authentication_error | Clé API manquante ou inconnue. |
| 402 insufficient_quota | Aucun forfait actif ou budget atteint. Activez un forfait ou relevez le budget. La requête n’atteint jamais un fournisseur. |
| 403 permission_error | La clé n’a pas la permission, par exemple le modèle ne figure pas sur la liste d’autorisation du workload. |
| 422 invalid_request_error | Refusée avant l’envoi, par exemple la protection des données en mode block a détecté la requête. |
| 422 document_too_large_to_scan | Un document est trop volumineux pour le chemin emprunté : une page encore au-dessus du plafond de pixels de rendu à la résolution minimale d’analyse, ou un fichier au-dessus du plafond d’octets de l’extraction de texte. Les pages grand format (plans A0 et A1) sont réduites automatiquement. Réduisez ou scindez le document, puis renvoyez-le. |
| 429 rate_limit_error | Limite de débit atteinte. Appliquée à la gateway, donc la requête n’atteint jamais un fournisseur. |
| 403 permission_error | Bloquée par la politique de résidence : aucune juridiction autorisée ne sert la requête. Le corps inclut le motif. |
| 403 scope_violation | Refusée par la garde de périmètre du workload en mode block : l’appel sort du périmètre défini pour ce workload. Le message donne la raison de la garde, et la requête n’atteint jamais un fournisseur. |
| 422 malware_detected | Le fichier envoyé correspond à une signature de logiciel malveillant et a été refusé avant d’être stocké ou analysé. Le nom de la signature n’est jamais renvoyé. |
| 503 pdf_renderer_unavailable | Un PDF en ligne devait être envoyé sous forme d’images de pages car le modèle routé accepte l’entrée image, mais ce déploiement n’a pas de moteur de rendu PDF. La requête est refusée plutôt que traitée à partir du texte extrait, ce qui écarterait ce que montre un plan ou un scan. |
| 503 malware_scan_unavailable | Le fichier envoyé n’a pas pu être analysé pour détecter des logiciels malveillants (analyseur indisponible ou lent, ou fichier supérieur à la limite d’analyse de 100 Mio) et n’a donc pas été accepté. Rien n’a été stocké. Réessayez avec un backoff. |
| 503 scope_guard_unavailable | La garde de périmètre du workload est en mode block mais n’a pas pu rendre de verdict : l’appel est refusé plutôt que laissé passer. Réessayez avec un backoff. |
| 503 auth_unavailable | La gateway n’a pas pu lire son stockage de clés, donc n’a pas pu vérifier la clé. On ne sait pas si la clé est invalide. Réessayez avec un backoff et respectez Retry-After. |
| 504 api_error | Le fournisseur n’a pas répondu dans le délai de réponse du workload : 300 secondes par défaut, de 10 à 600 si le workload le fixe, moins si la requête envoie x-sluis-upstream-timeout. error.sluis.cause vaut timeout. La gateway n’a pas rejoué l’appel, car le fournisseur peut encore le traiter. Raccourcissez le prompt ou demandez un délai plus long avant de renvoyer. |
| 5xx api_error | Défaillance du fournisseur en amont après plusieurs tentatives. Le disjoncteur détourne le trafic des fournisseurs défaillants. Le corps reprend le message du fournisseur lui-même, accompagné d’un objet error.sluis qui nomme la cause et chaque tentative, avec son statut amont ou son erreur de transport et sa durée. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. \"mistral/mistral-large-latest\"",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model not permitted for this API key",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}API Anthropic Messages
Sluis parle nativement l’API Anthropic Messages. Pointez Claude Code ou n’importe quel SDK Anthropic vers la gateway et appelez POST /v1/messages. /anthropic/v1/messages est le chemin préfixé, sans ambiguïté, vers le même gestionnaire.
La requête est traduite vers la forme interne, passe par le même pipeline Inspect, Route, Seal et Meter que tout autre appel, puis revient au format Anthropic, streaming compris.
Authentification
- Envoyez votre clé Sluis dans l’en-tête
x-api-keyd’Anthropic ou dans l’en-tête habituelAuthorization: Bearer. Les deux sont acceptés. - L’en-tête
anthropic-versionest accepté avec n’importe quelle valeur et jamais exigé. SurGET /v1/models, sa présence sélectionne la forme Anthropic. - L’analyse est volontairement ouverte : champs de corps inconnus, types de blocs de contenu inconnus, valeurs
anthropic-betainconnues et la requête?beta=trueque Claude Code envoie sont tolérés, pas refusés. - Les drapeaux bêta sont transmis tels quels aux upstreams de la famille Anthropic et ignorés partout ailleurs.
Endpoints
| Endpoint | Rôle |
|---|---|
| POST / | Messages, en tampon ou en streaming. Prend en charge les prompts système (chaîne ou blocs), les outils et leurs résultats (y compris les résultats d’erreur et les images qu’ils contiennent), les images, les blocs de document, les blocs thinking et redacted_thinking dans l’historique, et les marqueurs cache_control à chaque position pouvant être mise en cache. |
| POST / | Estimation locale de tokens pour la gestion de contexte du SDK. Rien n’est envoyé, conservé ni mesuré. |
| GET / | Découverte native des modèles à la forme Anthropic, depuis le catalogue en mémoire. Au chemin racine, l’en-tête anthropic-version sélectionne cette forme, et sans lui vous obtenez la forme OpenAI. Sous /anthropic, elle s’applique toujours. Les curseurs before_id, after_id et limit sont au mieux, et created_at est un espace réservé fixe, car le catalogue n’a pas de date de sortie par modèle. |
| HEAD / | La sonde de préchauffage que Claude Code envoie avant une session : HEAD uniquement, avec 200 et un corps vide. |
Routage du modèle
Le format de transport ne restreint jamais le modèle : l’entrée n’est qu’un codec, et l’identifiant du modèle décide de la route.
- Un identifiant nu comme
claude-sonnet-5se résout via le fournisseur par défaut de cette entrée,anthropic, sauf si votre organisation le redirige ailleurs (par exemple versvertexpour Claude hébergé dans l’UE). La barrière de résidence décide toujours si cette cible peut servir la requête. - Fixez une cible explicitement avec un identifiant préfixé du fournisseur, comme
vertex/claude-opus-4-8. - Ou passez un alias
sluis/*. Un outil SDK Anthropic tourne alors sur n’importe quel fournisseur connecté, dans le cadre de votre politique.
Streaming
Avec "stream": true, la réponse suit toute la grammaire d’événements Anthropic :
message_start, puiscontent_block_start,content_block_deltaetcontent_block_stoppour chaque bloc, puismessage_deltaavec l’usage cumulé (y compris les tokens de lecture et de création de cache), puismessage_stop.- Le texte arrive en
text_delta, les arguments d’outil eninput_json_delta, et le raisonnement enthinking_deltaplussignature_deltaquand le fournisseur routé en a produit. message_startporte le nombre de tokens d’entrée quand le fournisseur le rapporte dans son premier chunk. Sinon, il part de zéro, etmessage_deltarapporte l’usage mis à jour.- Un événement
pingsuitmessage_startet se répète après environ 15 secondes de silence en amont, pour qu’un long tour de réflexion ne déclenche jamais le chien de garde d’un client. - Un échec en cours de flux est réencodé en événement
errorau lieu d’un flux tronqué. stop_sequenceporte la séquence détectée quand la réponse vient d’un fournisseur de la famille Anthropic, et vaut null sinon.- Envoyez
x-sluis-include-cost: trueet l’usage demessage_deltacontient aussisluis_cost_eur, le prix de l’appel pour votre organisation en EUR, plussluis_cost_estimated: trueuniquement en cas d’estimation. Voir Coût d’un appel.
# native Anthropic Messages: the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true: the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Erreurs
Les échecs des gestionnaires Messages utilisent l’enveloppe d’Anthropic : un "type": "error" de premier niveau avec le type d’erreur du fournisseur. Cela inclut les refus qui n’atteignent jamais un modèle, comme une clé inconnue ou un blocage par la protection des données.
Les types sont invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error et overloaded_error.
- La réponse porte un en-tête
request-idet un champ de corpsrequest_id, l’identifiant de corrélation pour votre client. - Quand l’appel a produit une ligne d’audit, l’en-tête
x-sluis-request-ididentifie cette ligne. Un échec d’authentification n’a pas de ligne d’audit. - Les réponses HTTP 5xx traitées par la gateway portent aussi un
x-request-idde diagnostic distinct. Un identifiant sûr fourni par le client est également renvoyé sur les autres réponses. Les erreurs générées par un proxy en amont ne sont pas couvertes. - Les refus au niveau de la gateway qui surviennent avant le gestionnaire, comme la contre-pression du registre ou la surcharge, peuvent revenir à la forme d’erreur OpenAI.
# failures from the Messages handlers are Anthropic-shaped: auth and
# data-protection refusals included
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "`mcp_servers` is not supported: an external MCP server reached from the model would bypass the Sluis tool gate. Register the server with Sluis and call it through the compliance-native MCP gateway (`/v1/mcp`), which audits and meters every tool call."
  },
  "request_id": "req_4c81…"
}
Un tableau mcp_servers non vide est refusé avec 400 invalid_request_error au lieu d’être transmis. Un modèle qui appellerait lui-même un serveur MCP externe se trouverait hors de la barrière Sluis. Enregistrez plutôt le serveur dans la Console et appelez ses outils via la gateway MCP, où chaque appel d’outil exécuté est inspecté, routé, scellé et mesuré.
Matrice de compatibilité
Ce que les entrées natives couvrent aujourd'hui, endpoint par endpoint. Ce tableau est l'engagement : ce qui n'y figure pas comme pris en charge est sur la feuille de route, refusé volontairement ou relève d'une autre surface produit, jamais sous-entendu.
| Anthropic | Statut | Remarques |
|---|---|---|
| POST / | ✓ natif | En tampon et en streaming, outils, images, blocs de document, aller-retour du raisonnement et marqueurs de cache de prompt. |
| POST / | ✓ estimation locale | Répondu localement. Rien n’est envoyé. |
| GET / | ✓ natif | Forme native list et get depuis le catalogue en mémoire. Négociée par en-tête au chemin racine, inconditionnelle sous /anthropic. |
| HEAD / | ✓ | Sonde de préchauffage de Claude Code, HEAD uniquement. |
| Message Batches | ✓ opt-in | Disponible lorsque votre déploiement l’active : créer, lister, obtenir, résultats et annuler, pour les modèles qui se résolvent vers Anthropic. Sinon 404. Utilisez /v1/batches à la forme OpenAI pour les autres fournisseurs. |
| Files | ✗ feuille de route | L’API Files n’est pas relayée. Les blocs de document inline et file_data couvrent le cas courant. |
| mcp_servers | ✗ refusé | Un tableau non vide est refusé avec 400 au lieu d’être transmis. Enregistrez le serveur et utilisez la gateway MCP de Sluis. |
| Skills · Agents · Admin | ✗ hors périmètre | Skills, agents gérés et les API d’administration, d’usage et de coût sont une autre surface produit, pas de la compatibilité d’inférence. |
Routage entre protocoles
Les champs propres à un éditeur survivent tant que la requête atterrit chez un fournisseur qui parle le même protocole. Une requête Anthropic servie par un fournisseur de la famille Anthropic garde ses blocs de réflexion, ses marqueurs de cache, ses drapeaux bêta et le stop_sequence détecté.
Routés d’un protocole à l’autre, ces champs sont supprimés à l’envoi et jamais rejetés à l’entrée. La ligne d’audit enregistre à la fois le format de transport et le fournisseur résolu, de sorte que toute dégradation est attribuable.
Les valeurs opaques ne sont jamais réécrites : les signatures de réflexion et les charges redacted_thinking sont transmises telles quelles ou pas du tout. C’est aussi pourquoi un bloc de réflexion mis de côté que l’analyse de protection des données signale est supprimé plutôt que masqué : un bloc réécrit porterait une signature invalide.