Límites de velocidad y presupuestos por workload, topes de organización y caché de respuesta exacta, con el comportamiento de cada límite al alcanzarse.
Presupuestos y límites
Cada workload tiene sus propios límites de tasa (peticiones y tokens por minuto) y un presupuesto de gasto compartido entre sus credenciales. Un límite agregado de toda la organización se aplica a todos los workloads.
Elija un periodo de presupuesto: total, daily o monthly. La acción de presupuesto block detiene las llamadas que superan el presupuesto, y notify las deja continuar.
Cómo se aplican los límites
Superado el límite de tasa del workload, la llamada devuelve 429 con una cabecera Retry-After: los segundos enteros hasta la siguiente ventana de un minuto (de 1 a 60). Superado un presupuesto con bloqueo, devuelve 402. En ambos casos la petición nunca llega a un proveedor.
Antes de despachar, el gateway comprueba el gasto liquidado y reserva un importe estimado en los presupuestos con tope. El uso real se tarifica con el libro de precios en vivo y se descuenta cuando se mide la respuesta.
Si no se puede acceder a los contadores, un presupuesto con bloqueo se reconcilia con el libro de auditoría inmutable y falla en cerrado cuando no se puede verificar. Las ventanas de tasa fallan en abierto cuando Redis no está disponible, y los presupuestos en modo notify nunca bloquean.
Las subidas a Knowledge de Workspace se miden del mismo modo. Los embeddings que necesita un documento se tarifican como una llamada a /v1/embeddings y se cargan a la organización, a su crédito prepagado y al presupuesto del miembro que sube el archivo. Una subida se rechaza con 402 cuando el presupuesto o el crédito de la organización se ha agotado.
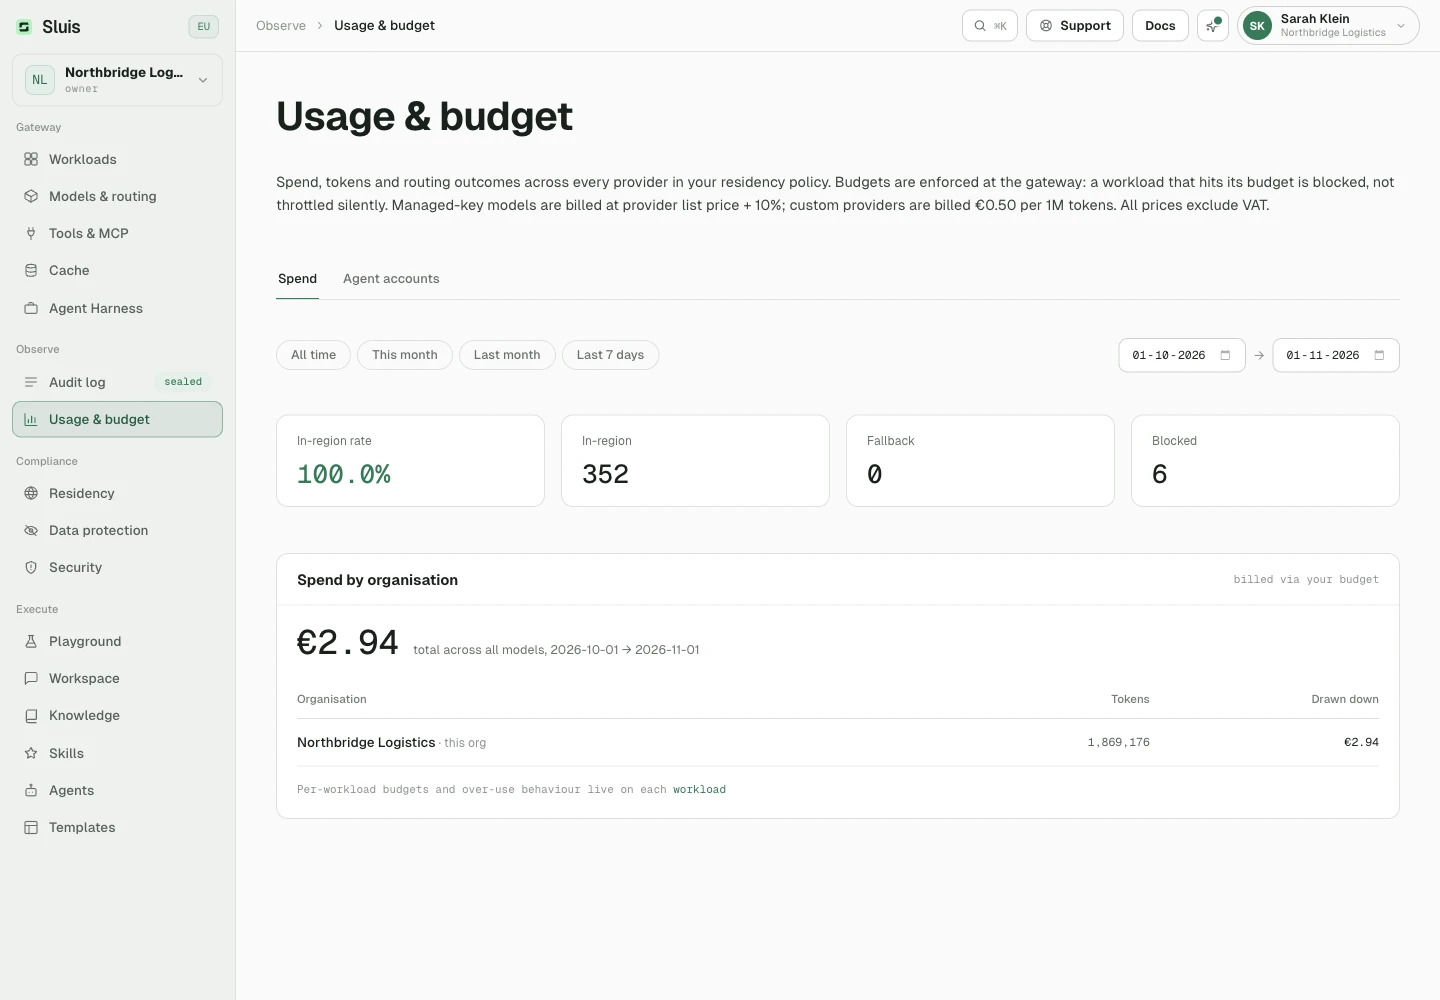
Uso: revise el consumo y los gastos.Interfaz en inglés · datos de demostración ilustrativos. Abra la imagen para verla a tamaño completo.
# past the workload's rate limit: the request never reaches a provider# response header: Retry-After: 23 (whole seconds until the next per-minute window)
{
"error": {
"message": "rate limit exceeded",
"type": "rate_limit_error",
"param": null,
"code": "rate_limit_exceeded"
}
}
# a workload budget is used up (a missing plan or credit also returns 402, with its own code and message)
{
  "error": {
    "message": "budget exceeded",
    "type": "insufficient_quota",
    "param": null,
    "code": "insufficient_quota"
  }
}
Caché
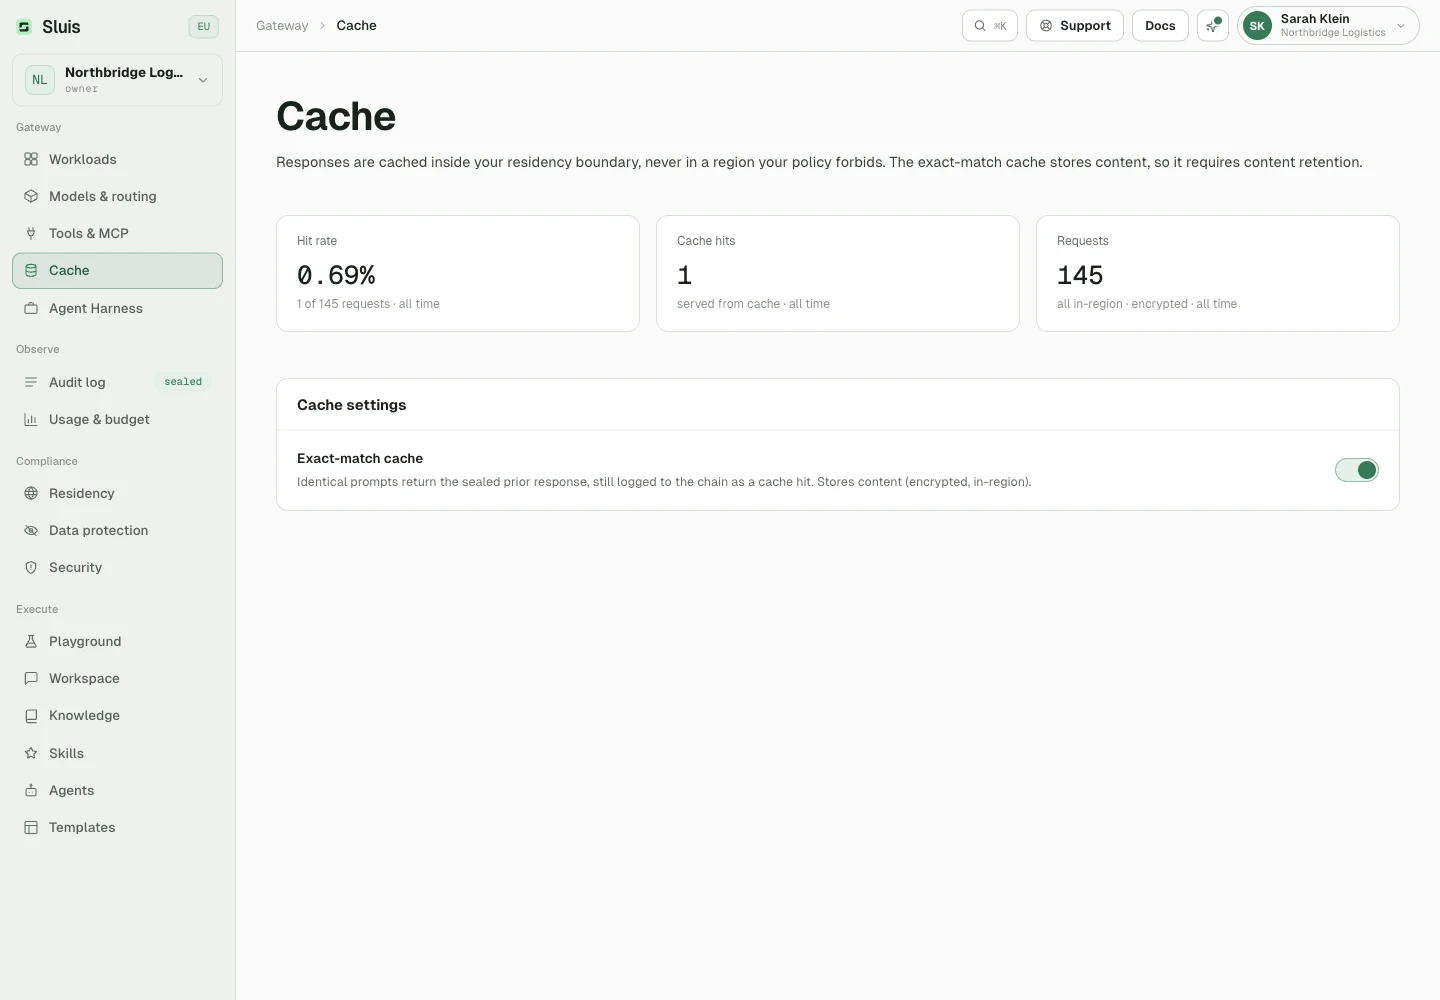
Una caché de respuesta exacta opcional compara peticiones normalizadas. Actívela en la vista Cache de la Consola.
Está estrictamente aislada por organización y cifrada en reposo.
Requiere retención de contenido.
Caché: configure la caché de respuestas exacta.Interfaz en inglés · datos de demostración ilustrativos. Abra la imagen para verla a tamaño completo.
Las nuevas filas de auditoría registran cómo se sirvió la llamada: none | exact.
# with retention and exact caching on, a repeat of a cacheable request can come from the cachecurl https://api.sluis.ai/v1/chat/completions \
-H "Authorization: Bearer $SLUIS_KEY" \
-H "Content-Type: application/json" \
-d '{ "model": "mistral/mistral-large-latest", "messages": [{ "role": "user", "content": "Define GDPR" }] }'# audit row of a cache hit: cache_hit: exact, no provider dispatch, no token cost