Referencia de la API
Autenticación, endpoints, streaming, razonamiento y errores en la superficie OpenAI, API nativas de Anthropic y matriz de compatibilidad por endpoint.
Autenticación
Cada solicitud a /v1/* se autentica con una clave virtual en la cabecera Authorization: Bearer. Cree las claves en Workloads, en la Consola.
- El secreto se muestra una sola vez, y solo se almacena su hash.
- Una clave es la credencial de un workload. El workload define los límites de tasa, el presupuesto, los modelos permitidos y las excepciones de política. La política de la organización sigue aplicándose.
- Una clave puede tener una caducidad opcional. Pasada esa fecha, la clave se rechaza igual que una desconocida.
- Un modelo que no figura en la lista de permitidos del workload, cuando esta no está vacía, se rechaza con un
403 permission_errorsellado antes de despachar nada. El propio rechazo queda en la cadena de auditoría. - Un workload puede limitar sus claves a familias de endpoints, por ejemplo chat y embeddings. Las demás familias reciben un
403 operation_not_allowedsellado antes de despachar nada. - Crear una clave de producción requiere una dirección de correo verificada.
- Una excepción: los enlaces de descarga firmados y con caducidad de los documentos anonimizados no necesitan clave.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the workload's allow-list never dispatches:
# → 403 permission_error, and the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    {
      "id": "mistral/mistral-large-latest",
      "object": "model",
      "created": 1704067200,
      "owned_by": "mistral",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": 0.55,
        "output_eur_per_mtok": 1.65,
        "cached_input_eur_per_mtok": 0.055,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }],
        "eur_per_page": null,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    },
    {
      "id": "sluis/fast",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": "mistral/mistral-large-latest",
      "pricing": { "input_eur_per_mtok": 0.55, "output_eur_per_mtok": 1.65, "cached_input_eur_per_mtok": 0.055, "audio_input_eur_per_mtok": null, "audio_output_eur_per_mtok": null, "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }], "eur_per_page": null, "eur_per_minute": null, "eur_per_image": null, "estimated": false }
    },
    {
      "id": "sluis/auto",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": null,
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": null
    },
    {
      "id": "sluis/ocr",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "ocr",
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": null,
        "output_eur_per_mtok": null,
        "cached_input_eur_per_mtok": null,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [],
        "eur_per_page": 0.01,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    }
  ]
}
Endpoints
Sluis expone la superficie compatible con OpenAI que se muestra abajo, además de las rutas nativas de Anthropic descritas más adelante.
Los endpoints sin un manejador propio se retransmiten tal cual al proveedor enrutado, incluido el streaming, de modo que los upstreams compatibles con OpenAI conservan toda su fidelidad.
Un navegador que abre una ruta que la API no sirve, como el host de la API a secas, se redirige a esta documentación. Los clientes de API siguen recibiendo un 404 simple.
| Endpoint | Propósito |
|---|---|
| POST / | Chat completions, la superficie principal: enrutamiento, protección de datos, caché, streaming. |
| POST / | Text completions heredadas. |
| POST / | Embeddings. |
| POST / | Clasificación de moderación. |
| POST / | La API OpenAI Responses. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | OCR de documentos (Mistral, o totalmente local con el modelo sluis/ocr), facturado por página. Con la política dlp_documents activada, los documentos en línea se anonimizan antes de salir. |
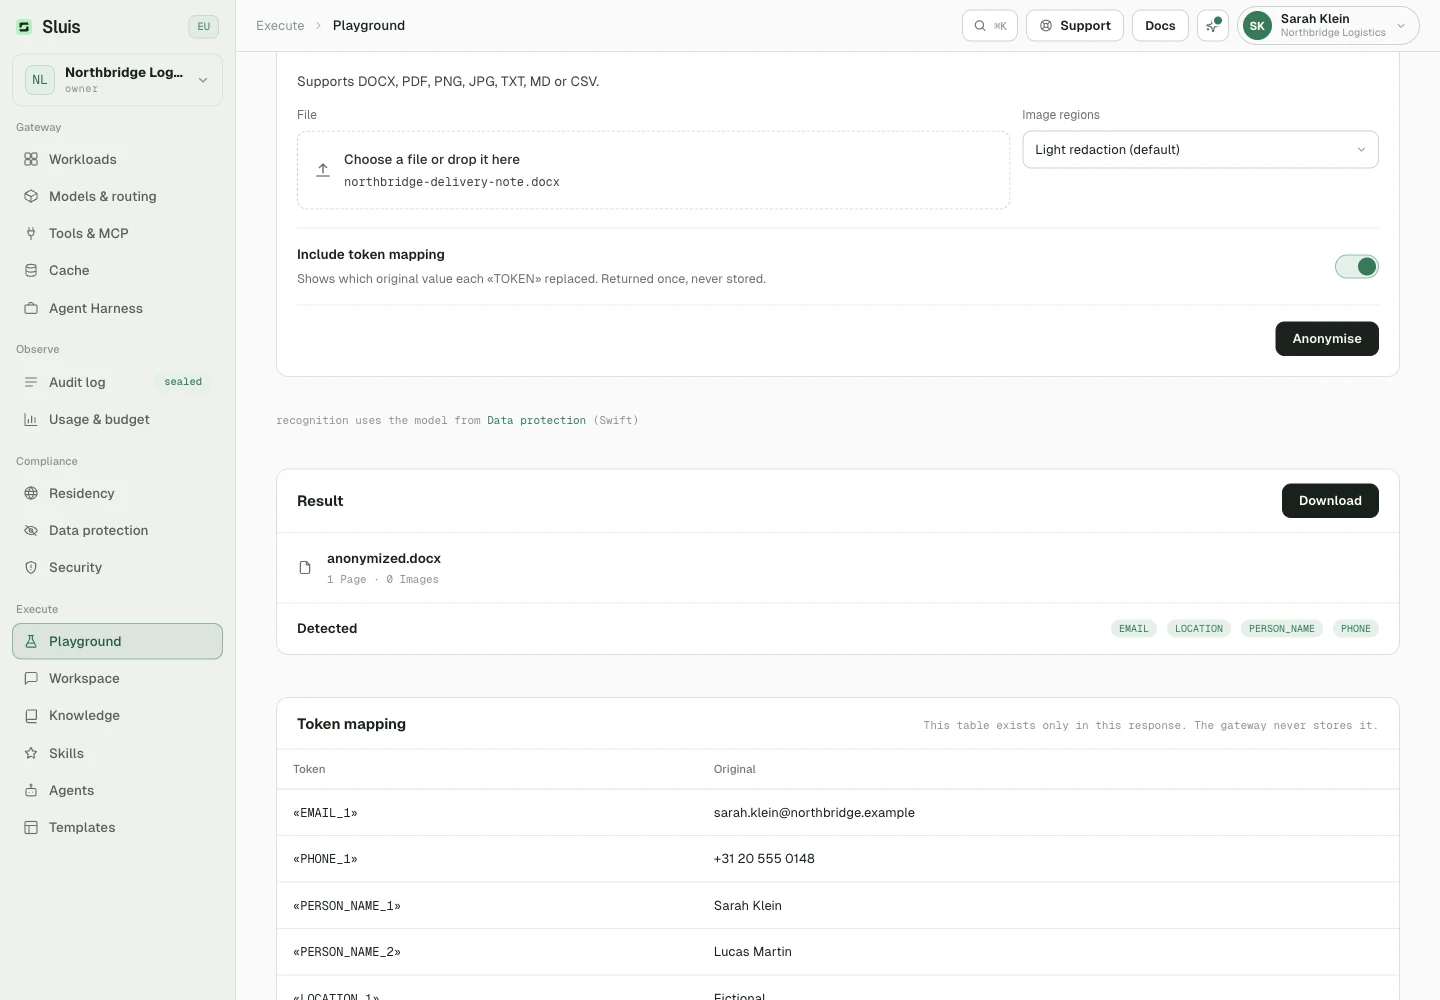
| POST / | Anonimización de documentos: los datos personales se sustituyen por «MERGE_TAG»s y las imágenes se difuminan. Se factura por página o imagen. |
| POST / | Trabajos de anonimización asíncronos: ponga en cola un documento grande, consulte /jobs/{id} y recoja /jobs/{id}/result. El enlace de descarga firmado (/v1/documents/deliverables/{id}) tiene caducidad y no necesita clave API. |
| GET / | Modelos permitidos por su política, credenciales y workload, con tipo, ventana de contexto, capacidades, residencia, destino de alias y precio final de esta organización en EUR, sin IVA. |
| GET / | Metadatos y precio específico de la organización para un modelo, con el mismo formato que la lista. |
| POST / | Transcripción, traducción y voz, retransmitidas al proveedor enrutado. Con el modelo sluis/transcribe, POST /v1/audio/transcriptions ejecuta el reconocimiento de voz propio de Sluis con detección de hablantes. Vea Voz a texto. |
| POST / | Generación y edición de imágenes, retransmitidas. mistral/image-generation es la excepción: Mistral solo la sirve a través de su conector de agentes, así que el gateway traduce la solicitud de OpenAI y responde con b64_json, facturado por imagen. |
| POST / | Generación de vídeo, retransmitida. |
| / | Operaciones con archivos, retransmitidas con la propia clave de su organización (BYOK o un proveedor personalizado). Los archivos con purpose=batch son la excepción: pasan por el control propio del gateway y pueden usar claves gestionadas. |
| / | Lotes con formato OpenAI: suba un archivo JSONL con purpose=batch a /v1/files, y aquí cree, consulte y cancele. Cada línea pasa por la protección de datos y la residencia como una llamada en vivo. Los resultados llegan en 24 horas, facturados a la mitad del precio en vivo. Mistral, Azure, OpenAI y Qwen. |
| POST / | Anthropic Message Batches: crear, listar, obtener, resultados y cancelar. Desactivados salvo que su despliegue los habilite. Requieren retención de contenido y funcionan solo con modelos de Anthropic. En caso contrario, estas rutas devuelven 404. |
| POST / | Entrada nativa de Anthropic Messages: apunte cualquier herramienta con SDK de Anthropic a Sluis, con cualquier modelo conectado. |
| POST / | Estimación local de tokens para la gestión de contexto del SDK de Anthropic. No se despacha nada. |
| GET / | Descubrimiento nativo de modelos de Anthropic (listar y obtener), respondido desde el catálogo en proceso. En /v1/models, la cabecera anthropic-version selecciona el mismo formato. |
| HEAD / | Sonda de calentamiento para clientes del SDK de Anthropic como Claude Code: 200 con cuerpo vacío. |
| GET / | WebSocket compatible con OpenAI Realtime para voz en directo (speech to speech) con vertex/gemini-3.8-live, alojado en la multirregión de la UE en Google Vertex AI. También servido en /openai/v1/realtime; el parámetro de consulta model es obligatorio. Autentique la petición de upgrade con Authorization: Bearer o x-api-key. Habla los nombres de evento GA; los formatos beta OpenAI-Beta: realtime=v1, los secretos de cliente efímeros, las claves por subprotocolo del navegador y el audio G.711 no se admiten. Las herramientas del lado del servidor, la reanudación de sesión, la replicación de voz y la salida de avatar se rechazan en la configuración inicial. El texto se protege como en cualquier endpoint; las tramas de audio y vídeo se reenvían sin inspeccionar. Una sesión termina al alcanzar un tope de gasto de 2 EUR, y el proveedor cierra una conexión tras unos 10 minutos; reconéctese para continuar. Se factura por token a las tarifas por modalidad del modelo (texto, audio, tramas de imagen y vídeo), según el informe de uso del proveedor. No disponible en Sluis Workspace, el Playground ni los alias sluis/*. La lista completa de eventos está en el agent skill. |
| GET / | WebSocket nativo de Gemini Live (BidiGenerateContent), también en /ws/google.cloud.aiplatform.v1.LlmBidiService/BidiGenerateContent; la versión en el nombre del servicio puede ser v1, v1beta, v1beta1 o v1alpha. Un SDK google-genai con el origen de la gateway como URL base se conecta sin cambios. Autentique la petición de upgrade con x-goog-api-key, Authorization: Bearer o x-api-key; el parámetro de consulta ?key= no se acepta. Las tramas se retransmiten tal como las define el protocolo Gemini Live, y setup.model es gemini-3.8-live. Los rechazos llegan como trama de cierre WebSocket con el motivo en texto. Mismo modelo, mismos límites, misma protección de datos y misma facturación que /v1/realtime. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Cada cuerpo JSON de arriba puede llevar además la extensión de la gateway sluis.remove, que nombra los términos que deben pseudonimizarse en el prompt antes del envío. Se retira antes de que la petición salga de la gateway; véase la referencia de Protección de datos.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}
Voz a texto con detección de hablantes
Fije el modelo en sluis/transcribe y envíe POST /v1/audio/transcriptions. El gateway ejecuta su propio reconocimiento de voz, sin salida a proveedores.
- Envíe un
filemultipart de hasta 240 minutos. El idioma se detecta automáticamente. response_formatesjson(por defecto),textoverbose_json(segmentos con un hablante).- Se factura a 0,02 € por minuto de audio, por segundo iniciado.
- El modo DLP de la organización se aplica a la transcripción, igual que en
sluis/ocr. - Responde
503donde el despliegue no ejecuta la transcripción.
# Speech to text with speaker detection, billed €0.02 per minute of audio (per started second).
# model "sluis/transcribe" runs in the gateway's own worker: no provider egress, language detected automatically.
curl https://api.sluis.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F model=sluis/transcribe \
  -F response_format=verbose_json \
  -F file=@meeting.m4a
{
  "task": "transcribe",
  "duration": 94.2,
  "text": "Goedemorgen allemaal.\nGoedemorgen, fijn dat jullie er zijn.",
  "segments": [
    { "id": 0, "start": 0.4, "end": 2.1, "text": "Goedemorgen allemaal.", "speaker": "speaker_1" },
    { "id": 1, "start": 2.6, "end": 5.0, "text": "Goedemorgen, fijn dat jullie er zijn.", "speaker": "speaker_2" }
  ],
  "usage": { "type": "duration", "seconds": 95 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"] }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local router contract (sluis/typed/router) | Behaviour |
|---|---|
| Model ids | sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. For your own questions, use a typesafe/jev-* model with your own TypeSafe key. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. The other rows describe sluis/typed/router only. |
| Availability | Every answer comes from verified model weights, reported as revision. If the router is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. |
| Response | JSON with model, answers, decision and revision (weights SHA256). Each answer has its type, its typed value (choice, score or noul), confidence, probabilities, legend and answer_confidence. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. |
| Data protection | Tenant DLP applies locally to the state: block refuses; tokenize or mask rewrites what the router is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The router reports no token count, so input is estimated at about 4 characters per token over the state it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local router. |
Documentos como entrada
Adjunte un archivo PDF, Word, de imagen o de texto plano a una solicitud de chat como una parte de contenido "type": "file" con una URL de datos base64 en file_data.
Cualquier modelo enrutado lo acepta. Los proveedores que entienden nativamente las partes de archivo las reciben sin cambios. Para cualquier otro proveedor, el gateway convierte el documento antes del despacho.
Cómo recibe el modelo el documento
- Con un renderizador de PDF, los modelos con visión reciben cada página del PDF como una parte
image_url. El límite es de 48 páginas por solicitud, compartido entre todos los documentos adjuntos, y pueden aplicarse límites del proveedor. Sin renderizador, el mecanismo de respaldo del despliegue extrae el texto o rechaza la solicitud. - Los modelos sin entrada de imagen reciben el texto extraíble del documento como texto del prompt. El análisis de protección de datos lo cubre entonces como a cualquier otro texto.
- Los documentos más largos o pesados corresponden a
/v1/ocr. - La API Responses usa partes
input_fileen lugar de la forma anidadafilede chat completions. - Sluis no puede inspeccionar ni resolver las referencias
file_iddel lado del proveedor. Solo pasan a un proveedor que las admita, con su propia clave de proveedor y con la inspección de documentos desactivada. En otro caso, incluya los bytes en línea comofile_data.
Protección de datos para documentos
- Con la política
dlp_documentsactivada, el documento se anonimiza o se rechaza antes de que salga nada del gateway. - Con ella desactivada y un modo DLP protector (
tokenize,maskoblock), se rechazan los documentos que viajarían como imágenes no inspeccionables. Conallow_logpasan, con una marca explícita de no analizado en la pista de auditoría. - Las partes de audio (
input_audio) no se pueden analizar.blocko el reconocimiento de IA obligatorio con inspección de documentos activa las rechaza con422. En otro caso llevanx-sluis-unscanned: audio.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Fije stream: true y la respuesta llega como eventos enviados por el servidor. Cada trama es un delta chat.completion.chunk, y el flujo termina con data: [DONE].
Los flujos nunca se almacenan en búfer en el gateway: lo atraviesan en paralelo, y el sellado de auditoría y la medición se realizan aunque el cliente cuelgue antes de tiempo.
Pida stream_options.include_usage y el gateway solicita al proveedor una trama final de uso. Si el proveedor no la envía, o el flujo se corta, el gateway estima el uso para la medición.
¿Quiere saber cuánto costó a su organización una llamada en streaming? Envíe x-sluis-include-cost: true junto con stream_options.include_usage. El objeto de uso final incluye entonces sluis_cost_eur, vea Coste de una llamada.
Bedrock separa el razonamiento de la respuesta en reasoning_content y reasoning_signature, también en los deltas transmitidos. Los rechazos usan finish_reason: content_filter y los límites de salida length, incluso con llamadas parciales a herramientas. No ejecute argumentos de herramientas incompletos. Las excepciones de streaming de AWS se convierten en tramas de error sin detalles sensibles.
Keepalive, cabeceras y reinicios
- Tras 15 segundos sin ninguna trama, el gateway escribe una línea de comentario SSE (
: keepalive) entre eventos, para que los proxies con tiempo de inactividad mantengan abierta la conexión mientras el modelo piensa. Los clientes SSE la ignoran. - Los flujos llevan
Cache-Control: no-cacheyX-Accel-Buffering: no. - Cuando se reinicia una réplica del gateway, sigue atendiendo los flujos abiertos hasta cinco minutos. Un flujo que siga abierto pasado ese plazo termina con un evento de error con el código
server_restarting, así que reintente la solicitud. - Los flujos tokenizados aceptan eventos individuales de hasta 4 MiB. Los eventos mayores terminan el flujo con un error.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Razonamiento
Pase el parámetro reasoning_effort de OpenAI (minimal | low | medium | high) en cualquier modelo con capacidad de razonamiento. Sluis lo traduce para cada proveedor (el nivel de razonamiento de Gemini, el esfuerzo de razonamiento adaptativo de Claude) y lo omite donde un modelo lo rechazaría, así que un único parámetro sirve para todo el catálogo.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Caché de prompts
Los prefijos de prompt repetidos (prompts de sistema, herramientas, historial de conversación) se pueden almacenar en caché en el proveedor para reducir coste y latencia. Sluis traduce para cada proveedor los bloques cache_control al estilo de Anthropic (con TTL opcional de 5m o 1h) y los parámetros de nivel superior de OpenAI prompt_cache_key y prompt_cache_retention.
Varios límites de punto de corte del sistema o del asistente pueden fusionarse durante la traducción, incluidos los TTL mixtos.
| Proveedor | Comportamiento de la caché de prompts |
|---|---|
| Anthropic | cache_control explícito en bloques de sistema, contenido y herramientas, incluido el TTL. Lecturas y escrituras se notifican por separado. |
| Bedrock | cache_control se convierte en bloques cachePoint de Converse en system, messages y toolConfig. |
| OpenAI · Azure | Caché automática. Tras activarla, prompt_cache_key y prompt_cache_retention se conservan en chat y Responses; se eliminan opciones y marcadores no compatibles. |
| Gemini · Vertex | Funcionan la caché implícita de Gemini y su consumo; las referencias explícitas cachedContent no son compatibles. Claude en Vertex traduce cache_control y TTL como Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Caché automática si se ofrece; se eliminan todas las directivas explícitas. Se reconoce usage.cached_tokens nativo de Moonshot. |
| Scaleway | Caché automática si se ofrece; se eliminan todas las directivas explícitas. Las lecturas usan la tarifa oficial de entrada en caché de Scaleway en EUR si está disponible, no LiteLLM. |
| Nebul | Caché automática si se ofrece; se eliminan todas las directivas explícitas. Las lecturas usan la tarifa oficial de entrada en caché en EUR si está disponible. |
| Nebius · nebius-eu | Caché automática si se ofrece; se eliminan todas las directivas explícitas. Los precios oficiales no toman descuentos de caché de LiteLLM; el respaldo LiteLLM puede aportar una tarifa de caché si no hay precio oficial del modelo. |
| Custom | Tras la activación por la organización, las directivas pasan intactas; la compatibilidad depende del contrato del operador. |
La caché explícita de prompts es opcional
La caché explícita de prompts es un ajuste a nivel de organización (provider_prompt_cache). Está desactivada por defecto y es independiente de la retención de contenido de Sluis y de la caché exacta de respuestas. Actívela en Consola › Protección de datos.
- Los prefijos en caché permanecen en el proveedor después de que la protección de datos de Sluis los haya filtrado.
- Cuando está desactivada, el gate elimina
prompt_cache_key,prompt_cache_retention,prompt_cache_options,cache_controlyprompt_cache_breakpoint. No desactiva la caché automática propia del proveedor. - Sin una clave propia para un proveedor, las llamadas se ejecutan con una credencial de Sluis compartida con otras organizaciones. En OpenAI y Azure, Sluis fija un
prompt_cache_keyderivado de su organización en lugar del suyo. En cualquier otro proveedor, los recuentos de tokens en caché de su uso muestran 0. La facturación sigue aplicando el descuento real de caché.
Facturación y límites
- Las lecturas y escrituras de caché son subconjuntos del total de tokens del prompt, no entrada adicional. Las lecturas usan la tarifa de caché disponible.
- Las escrituras de 1h de Anthropic usan la tarifa específica del TTL cuando el desglose de uso y la tarifa están disponibles. En caso contrario se aplica la tarifa de creación por defecto.
- Si falta la tarifa de caché, se aplica el precio de entrada ordinario, nunca una facturación de cero.
- El uso de caché aparece en el panel de auditoría y en Uso y presupuesto.
- Los prompts largos se facturan a la tarifa de contexto largo del proveedor. Cuando el prompt (tokens en caché incluidos) supera el umbral del modelo, toda la llamada se factura a esa tarifa. Se muestra bajo el precio en la tabla Modelos.
Con una clave gestionada por Sluis, Sluis rechaza con 400, antes de enviar nada, una solicitud que elige un recargo que Sluis no puede medir:
- un
cache_controlconttldistinto de5m, donde el proveedor lo respeta (Anthropic, Bedrock, Claude en Vertex) - un
service_tierdistinto deauto,default,flexostandard_only - la beta de contexto largo de Anthropic (
context-1m) en un modelo para el que Sluis no tiene tarifa de contexto largo
Su propia clave de proveedor reenvía los tres sin cambios.
Códigos de error
Los errores usan el sobre de error de OpenAI; el valor error.type refleja el estado HTTP, así que el manejo de errores de su SDK sigue funcionando sin cambios.
| Código | Cuándo |
|---|---|
| 400 invalid_request_error | Cuerpo o parámetros de la solicitud mal formados. |
| 400 invalid_request_error | Al id del modelo le falta el prefijo del proveedor. Todo id invocable es provider/model, por ejemplo mistral/mistral-large-latest. El mensaje dice: model must be provider-prefixed. |
| 400 invalid_request_error | La solicitud lleva la cabecera eliminada x-sluis-dlp. Las excepciones por solicitud se sustituyeron por las excepciones de opciones del workload: configúrelas en Consola › Workloads. |
| 401 authentication_error | Clave API ausente o desconocida. |
| 402 insufficient_quota | No hay un plan activo, o se alcanzó el presupuesto. Active un plan o aumente el presupuesto. La solicitud nunca llega a un proveedor. |
| 403 permission_error | La clave carece de permiso, por ejemplo porque el modelo no está en la lista de permitidos del workload. |
| 422 invalid_request_error | Rechazada antes del despacho, por ejemplo porque la protección de datos en modo block coincidió con la solicitud. |
| 422 document_too_large_to_scan | Un documento es demasiado grande para la ruta que siguió: una página que sigue superando el límite de píxeles de renderizado a la resolución mínima de escaneo, o un archivo que supera el límite de bytes de extracción de texto. Las páginas de gran formato (planos A0 y A1) se reducen automáticamente. Reduzca o divida el documento y vuelva a enviarlo. |
| 429 rate_limit_error | Se alcanzó el límite de tasa. Se aplica en el gateway, así que la solicitud nunca llega a un proveedor. |
| 403 permission_error | Bloqueada por la política de residencia: ninguna jurisdicción permitida atiende la solicitud. El cuerpo incluye el motivo. |
| 403 scope_violation | Rechazada por el control de alcance del workload en modo block: la llamada queda fuera del alcance definido para ese workload. El mensaje incluye el motivo del control, y la solicitud nunca llega a un proveedor. |
| 422 malware_detected | El archivo subido coincidió con una firma de malware y se rechazó antes de almacenarlo o analizarlo. El nombre de la firma nunca se devuelve. |
| 503 pdf_renderer_unavailable | Un PDF en línea tuvo que enviarse como imágenes de página porque el modelo enrutado lee entrada de imagen, pero este despliegue no tiene renderizador de PDF. Se rechaza en lugar de responder con el texto extraído, lo que descartaría lo que muestra un plano o un escaneo. |
| 503 malware_scan_unavailable | No se pudo analizar el archivo subido en busca de malware (el escáner no está disponible o es lento, o el archivo supera el límite de análisis de 100 MiB), así que no se aceptó. No se almacenó nada. Reintente con backoff. |
| 503 scope_guard_unavailable | El control de alcance del workload está en modo block pero no pudo llegar a un veredicto, así que la llamada se rechaza en lugar de dejarla pasar. Reintente con backoff. |
| 503 auth_unavailable | El gateway no pudo leer su almacén de claves, así que no pudo verificar la clave. No se sabe que la clave sea inválida. Reintente con backoff y respete Retry-After. |
| 504 api_error | El proveedor no respondió dentro del plazo de respuesta del workload: 300 segundos por defecto, de 10 a 600 si el workload lo fija, menos si la solicitud envió x-sluis-upstream-timeout. error.sluis.cause es timeout. El gateway no repitió la llamada, porque el proveedor puede seguir ejecutándola. Acorte el prompt o pida un plazo mayor antes de reenviar. |
| 5xx api_error | Fallo del proveedor upstream tras los reintentos. El circuit breaker desvía el tráfico lejos de los proveedores en mal estado. El cuerpo incluye el mensaje del propio proveedor y un objeto error.sluis que indica la causa y cada intento, con su estado upstream o error de transporte y lo que tardó. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. \"mistral/mistral-large-latest\"",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model not permitted for this API key",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}Anthropic Messages API
Sluis habla de forma nativa la API Anthropic Messages. Apunte Claude Code o cualquier SDK de Anthropic al gateway y llame a POST /v1/messages. /anthropic/v1/messages es la ruta con prefijo, sin ambigüedad, al mismo manejador.
La solicitud se traduce a la forma interna, pasa por el mismo flujo Inspect, Route, Seal y Meter que cualquier otra llamada, y vuelve en el formato de Anthropic, streaming incluido.
Autenticación
- Envíe su clave de Sluis en la cabecera
x-api-keyde Anthropic o en la cabecera habitualAuthorization: Bearer. Se aceptan ambas. - La cabecera
anthropic-versionse acepta con cualquier valor y nunca es obligatoria. EnGET /v1/models, su presencia selecciona el formato de Anthropic. - El análisis es abierto a propósito: se toleran, y no se rechazan, los campos de cuerpo desconocidos, los tipos de bloque de contenido desconocidos, los valores desconocidos de
anthropic-betay la consulta?beta=trueque envía Claude Code. - Los indicadores beta viajan byte a byte a los upstreams de la familia Anthropic y se ignoran en cualquier otro sitio.
Endpoints
| Endpoint | Propósito |
|---|---|
| POST / | Messages, con búfer o en streaming. Admite prompts de sistema (cadena o bloques), herramientas y resultados de herramientas (incluidos resultados de error e imágenes en ellos), imágenes, bloques de documento, bloques thinking y redacted_thinking en el historial, y marcadores cache_control en cada posición almacenable en caché. |
| POST / | Estimación local de tokens para la gestión de contexto del SDK. No se despacha, retiene ni mide nada. |
| GET / | Descubrimiento nativo de modelos en el formato de Anthropic, respondido desde el catálogo en proceso. En la ruta raíz, la cabecera anthropic-version selecciona este formato, y sin ella se obtiene el formato de OpenAI. Bajo /anthropic se aplica siempre. Los cursores before_id, after_id y limit son de mejor esfuerzo, y created_at es un valor provisional fijo porque el catálogo no tiene fecha de lanzamiento por modelo. |
| HEAD / | La sonda de calentamiento que Claude Code envía antes de una sesión: solo HEAD, respondida con 200 y cuerpo vacío. |
Enrutamiento de modelos
El formato de transmisión nunca restringe el modelo: la entrada es un códec, y el id del modelo decide la ruta.
- Un id simple como
claude-sonnet-5se resuelve con el proveedor por defecto de esta entrada,anthropic, salvo que su organización lo apunte a otro (por ejemplo avertexpara Claude alojado en la UE). El control de residencia sigue decidiendo si ese destino puede atender la solicitud. - Fije un destino explícitamente con un id con prefijo de proveedor, como
vertex/claude-opus-4-8. - O pase un alias
sluis/*. Una herramienta con SDK de Anthropic se ejecuta entonces en cualquier proveedor conectado, dentro de su política.
Streaming
Con "stream": true la respuesta usa la gramática completa de eventos de Anthropic:
message_start, luegocontent_block_start,content_block_deltaycontent_block_stoppor cada bloque, luegomessage_deltacon el uso acumulado (incluidos los tokens de lectura y creación de caché), y por últimomessage_stop.- El texto llega como
text_delta, los argumentos de herramientas comoinput_json_delta, y el razonamiento comothinking_deltamássignature_deltacuando lo produjo el proveedor enrutado. message_startincluye el recuento de tokens de entrada cuando el proveedor lo informa en su primer fragmento. En caso contrario empieza en cero, ymessage_deltainforma del uso actualizado.- Un evento
pingsigue amessage_starty se repite tras unos 15 segundos de silencio del upstream, de modo que un turno largo de razonamiento nunca activa el watchdog de un cliente. - Un fallo a mitad del flujo se recodifica como un evento
erroren lugar de un flujo truncado. stop_sequencecontiene la secuencia coincidente cuando la respuesta vino de un proveedor de la familia Anthropic, y es nulo en otro caso.- Envíe
x-sluis-include-cost: truey el uso demessage_deltaincluye tambiénsluis_cost_eur, el precio de la llamada para su organización en EUR, mássluis_cost_estimated: truesolo cuando es una estimación. Vea Coste de una llamada.
# native Anthropic Messages: the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true: the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Errores
Los fallos de los manejadores de Messages usan el envoltorio de Anthropic: un "type": "error" de nivel superior con el tipo de error del proveedor. Eso incluye los rechazos que nunca llegan a un modelo, como una clave desconocida o un bloqueo de protección de datos.
Los tipos del proveedor son invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error y overloaded_error.
- La respuesta lleva una cabecera
request-idy un campo de cuerporequest_id, el id de correlación para su cliente. - Cuando la llamada generó una fila de auditoría, la cabecera
x-sluis-request-ididentifica esa fila. Un fallo de autenticación no genera fila de auditoría. - Las respuestas HTTP 5xx gestionadas por el gateway también llevan un
x-request-idde diagnóstico independiente. Un id seguro enviado por el cliente también se devuelve en otras respuestas. Los errores generados por un proxy anterior al gateway quedan fuera de esta garantía. - Los rechazos a nivel de gateway que ocurren antes del manejador, como la contrapresión del libro de registro o la sobrecarga, pueden volver con el formato de error de OpenAI.
# failures from the Messages handlers are Anthropic-shaped: auth and
# data-protection refusals included
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "`mcp_servers` is not supported: an external MCP server reached from the model would bypass the Sluis tool gate. Register the server with Sluis and call it through the compliance-native MCP gateway (`/v1/mcp`), which audits and meters every tool call."
  },
  "request_id": "req_4c81…"
}
Un array mcp_servers no vacío se rechaza con 400 invalid_request_error en lugar de reenviarse. Un modelo que llamara por sí mismo a un servidor MCP externo quedaría fuera del gate de Sluis. Registre el servidor en la Consola y llame a sus herramientas a través del gateway MCP, donde cada llamada a herramienta ejecutada se inspecciona, enruta, sella y mide.
Matriz de compatibilidad
Lo que cubren hoy las entradas nativas, endpoint por endpoint. Esta tabla es la afirmación: lo que aquí no figura como soportado está en la hoja de ruta, se rechaza a propósito o pertenece a otra superficie de producto, nunca se insinúa en silencio.
| Anthropic | Estado | Notas |
|---|---|---|
| POST / | ✓ nativo | Con búfer y en streaming, herramientas, imágenes, bloques de documento, ida y vuelta de thinking y marcadores de caché de prompts. |
| POST / | ✓ estimación local | Se responde en local. No se despacha nada. |
| GET / | ✓ nativo | Formato nativo de listar y obtener desde el catálogo en proceso. Negociado por cabecera en la ruta raíz, incondicional bajo /anthropic. |
| HEAD / | ✓ | La sonda de calentamiento de Claude Code, solo HEAD. |
| Message Batches | ✓ opcional | Disponible cuando su despliegue lo habilita: crear, listar, obtener, resultados y cancelar, para modelos que se resuelven a Anthropic. En caso contrario, 404. Use /v1/batches con formato OpenAI para otros proveedores. |
| Files | ✗ hoja de ruta | La API Files no se traslada. Los bloques de documento en línea y file_data cubren el caso habitual. |
| mcp_servers | ✗ rechazado | Un array no vacío se rechaza con 400 en lugar de reenviarse. Registre el servidor y use el gateway MCP de Sluis. |
| Skills · Agents · Admin | ✗ fuera de alcance | Skills, los agentes gestionados y las API de administración, uso y coste son otra superficie de producto, no compatibilidad de inferencia. |
Enrutamiento entre protocolos
Los campos exclusivos de un proveedor se conservan mientras la solicitud llegue a un proveedor que hable el mismo protocolo. Una solicitud de Anthropic atendida por un proveedor de la familia Anthropic conserva sus bloques thinking, marcadores de caché, indicadores beta y el stop_sequence coincidente.
Si se enruta entre protocolos, esos campos se descartan en el despacho y nunca se rechazan en la entrada. La fila de auditoría registra tanto el formato de transmisión como el proveedor resuelto, así que cualquier degradación es atribuible.
Los valores opacos nunca se reescriben: las firmas de thinking y los contenidos redacted_thinking se reenvían tal cual o no se reenvían. Por eso también un bloque thinking aparcado que el análisis de protección de datos marca se descarta en lugar de enmascararse: un bloque reescrito llevaría una firma inválida.