Ochrona danych
Tryby wykrywania, biblioteka 61 detektorów, wykrywanie encji z modelami do wyboru, skanowanie bezpieczeństwa, powiadomienie modelu i retencja.
Ochrona danych działa na każdym żądaniu przed wysyłką. Domyślny tryb to tokenize: każda wykryta wartość bez pasującego wyjątku jest zamieniana na stabilny, typizowany token, taki jak «EMAIL_1».
Chronione wartości trafiają do dostawcy wyłącznie jako tokeny, a w drodze powrotnej do Ciebie odpowiedź jest przywracana do prawdziwych wartości, niezależnie od tego, czy jest strumieniowana.
Mapa tokenów żyje w pamięci przez czas trwania żądania i nigdy nie jest utrwalana. Pseudonimizacja działa w jedną stronę: chroni to, co wysyłasz.
W Sluis Workspace publiczne wyniki wyszukiwania w sieci i własna odpowiedź modelu z wcześniejszej części tej samej tury nie są tokenizowane na nowo. Wartość, którą rozmowa już zatokenizowała, pozostaje zastąpiona swoim tokenem, a dziennik audytu zapisuje, kiedy tak się stało.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives: only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back: restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Cztery tryby określają, co dzieje się z wykrytą wartością:
tokenize(domyślny) zamienia ją na odwracalny token.maskprzepisuje ją nieodwracalnie.blockodrzuca żądanie z kodem422.allow_logprzepuszcza ją, oznaczając wpis w audycie.
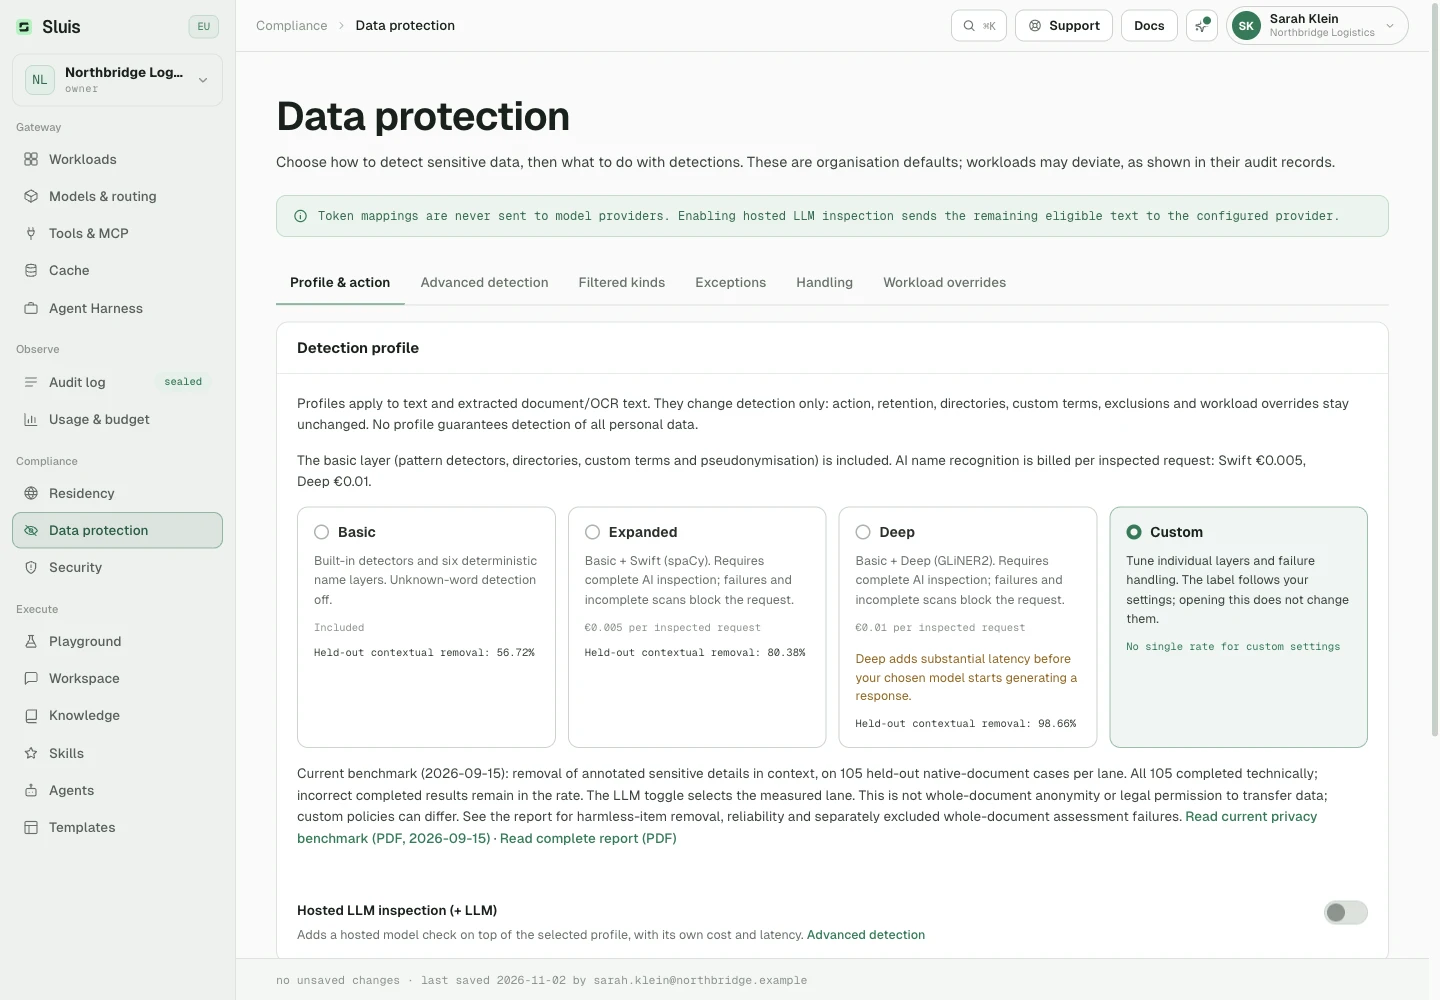
61 wbudowanych detektorów działa od ręki: 29 dla danych osobowych, od amerykańskiego numeru SSN po krajowe numery identyfikacyjne weryfikowane sumą kontrolną, datą lub formatem zgodnie z regułami każdego kraju, oraz 32 dla sekretów i poświadczeń. Każdy można włączać lub wyłączać per organizacja. Własne terminy (zwykłe lub regex) obejmują wszystko, co specyficzne dla Twojej firmy, a etykieta własnego terminu może mieć do 32 znaków:
Wyjątki według wzorca
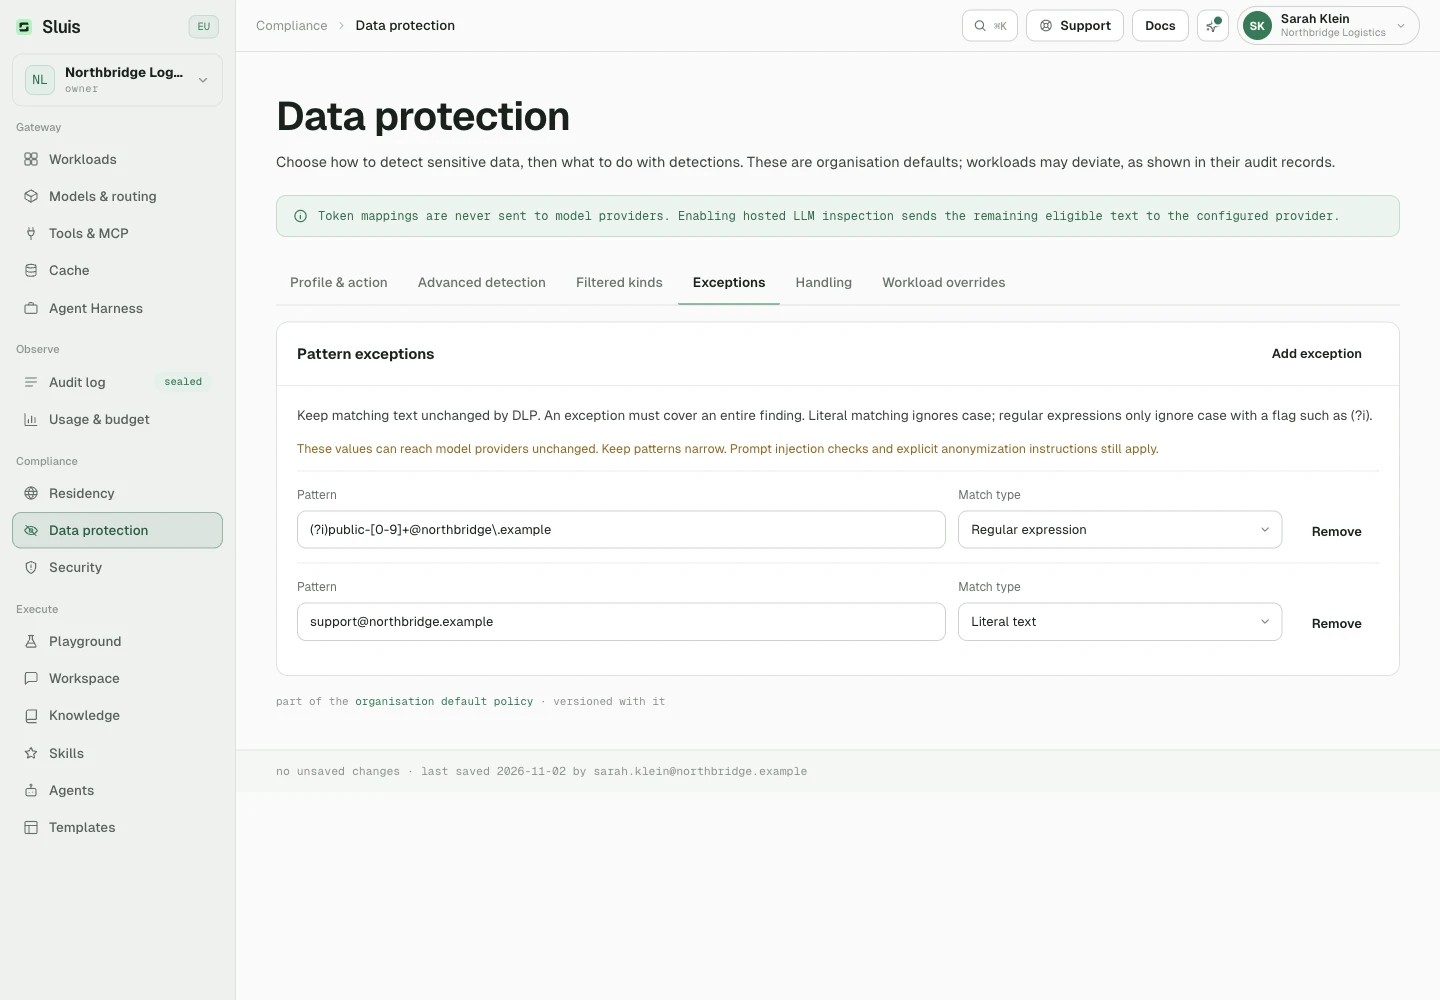
W Konsola › Ochrona danych › Wyjątki dodaj tekst dosłowny lub wyrażenie regularne dla wartości, które chcesz pozostawić bez zmian, na przykład publicznego adresu support@northbridge.example.
- Wzorce dosłowne ignorują wielkość liter, także liter Unicode.
- Wyrażenia regularne używają składni Rust regex i rozróżniają wielkość liter, chyba że dodasz
(?i). - Jedno dopasowanie wyjątku w oryginalnym tekście musi obejmować całą wykrytą wartość. Częściowe dopasowanie nie wystarcza; oddzielne dopasowania sąsiadujące lub nakładające się nigdy nie są łączone.
Stosuj precyzyjne wzorce. Wartość objęta wyjątkiem nie jest pseudonimizowana, maskowana ani używana do zablokowania żądania, więc jej oryginalny tekst może trafić do dostawcy modelu. Pozostałe wykryte wartości pozostają chronione.
Wyjątki dotyczą detektorów wbudowanych i własnych, nazw, słowników oraz lokalnego lub hostowanego rozpoznawania encji, także w chronionym tekście dokumentów i embeddingów. Nie wyłączają skanowania prompt injection ani innych kontroli bezpieczeństwa. Jawne terminy do usunięcia w sluis.remove lub żądaniu dokumentu zawsze mają pierwszeństwo.
Wykrywanie encji
Osoby, organizacje i miejsca trudno wykrywać samymi wzorcami. Sluis łączy kilka warstw:
- heurystyki kontekstowe
- korelacja e-mail
- katalog nazw tenanta
- dostarczane słowniki
- opcjonalne NER (rozpoznawanie nazwanych encji)
Model NER działa jako sidecar wewnątrz sieci, więc tekst pozostaje w obrębie wdrożenia. Te warstwy analizują też tekst wyodrębniony z dokumentów i przez OCR, gdy ochrona dokumentów jest włączona.
- Przy włączonym NER jedno żądanie może zawierać do 100 000 różnych encji i 6,4 mln znaków tekstu. Powyżej tego limitu skan uznaje się za niepełny.
- Nazwa wykryta przez model choć raz jest zastępowana wszędzie, gdzie wraca w żądaniu: to samo całe słowo, z tą samą wielkością liter i tym samym tokenem, także w wiadomościach, w których model jej nie zgłosił.
- Pojedyncze ogólne słowa i krótkie akronimy obejmują tylko miejsce zgłoszone przez model.
Słownik nazwisk
Słownik nazwisk to deterministyczny odpowiednik NER: imiona i nazwiska skompilowane z rządowych danych otwartych w słownik dostarczany wewnątrz gateway.
- Wychwytuje pełne imiona i nazwiska oraz nazwiska poprzedzone tytułem grzecznościowym, bez dodatkowych opóźnień i bez wysyłania czegokolwiek poza Twój perymetr.
- Nazwiska będące zarazem zwykłymi wyrazami są wychwytywane tylko w kontekście o kształcie nazwiska.
- Rzadkie nazwiska pozostają zadaniem katalogu lub NER.
Modele NER do wyboru
W Ochronie danych wybierz Podstawowy, Rozszerzony lub Dogłębny.
- Podstawowy to ustawienie domyślne nowych organizacji. Używa wbudowanych detektorów i sześciu deterministycznych warstw nazw, bez wywołania modelu.
- Rozszerzony dodaje Swift (spaCy).
- Dogłębny dodaje zamiast tego GLiNER2-PII. Wymaga więcej czasu przetwarzania, ale nie gwarantuje wyższej czułości.
- Własny pozwala dostosować poszczególne ustawienia.
Oba profile z modelem wymagają pełnej inspekcji i blokują błędy modelu lub niepełne skany.
- Istniejące polityki, wyłączenia, katalogi i wyjątki workloadów pozostają bez zmian.
- Wykrywanie nieznanych słów pozostaje wyłączone we wszystkich trzech profilach.
- Workload może wybrać dostępny model NER, nawet gdy organizacja ma go domyślnie wyłączonego.
Rozliczanie
- Rozpoznawanie nazw przez AI jest rozliczane raz za każde żądanie klienta, które sprawdza: 0,005 € ze Swift (Rozszerzony), 0,01 € z GLiNER2 (Dogłębny). Podstawowy jest wliczony.
- Dalsze wywołania wykonywane przez Sluis w ramach tego żądania nie są rozliczane ponownie, a niepełna inspekcja nic nie kosztuje.
- Każda opłata jest powiązanym potwierdzeniem w audycie i wlicza się do Twoich budżetów.
Opóźnienie
- Dogłębny znacznie wydłuża oczekiwanie, zanim wybrany model zacznie generować odpowiedź.
- Czas skanowania Swift i GLiNER2 rośnie wraz z długością danych wejściowych, liczbą wiadomości i obciążeniem.
- Nie ma limitu czasu: pod obciążeniem żądanie czeka w kolejce zamiast być odrzucone i kończy się tylko wtedy, gdy się rozłączysz. To nie jest gwarancja szybkości.
- Opcjonalna inspekcja przez hostowany LLM dodaje osobne oczekiwanie przed generowaniem odpowiedzi, zależne od długości danych, obciążenia dostawcy i ponowień.
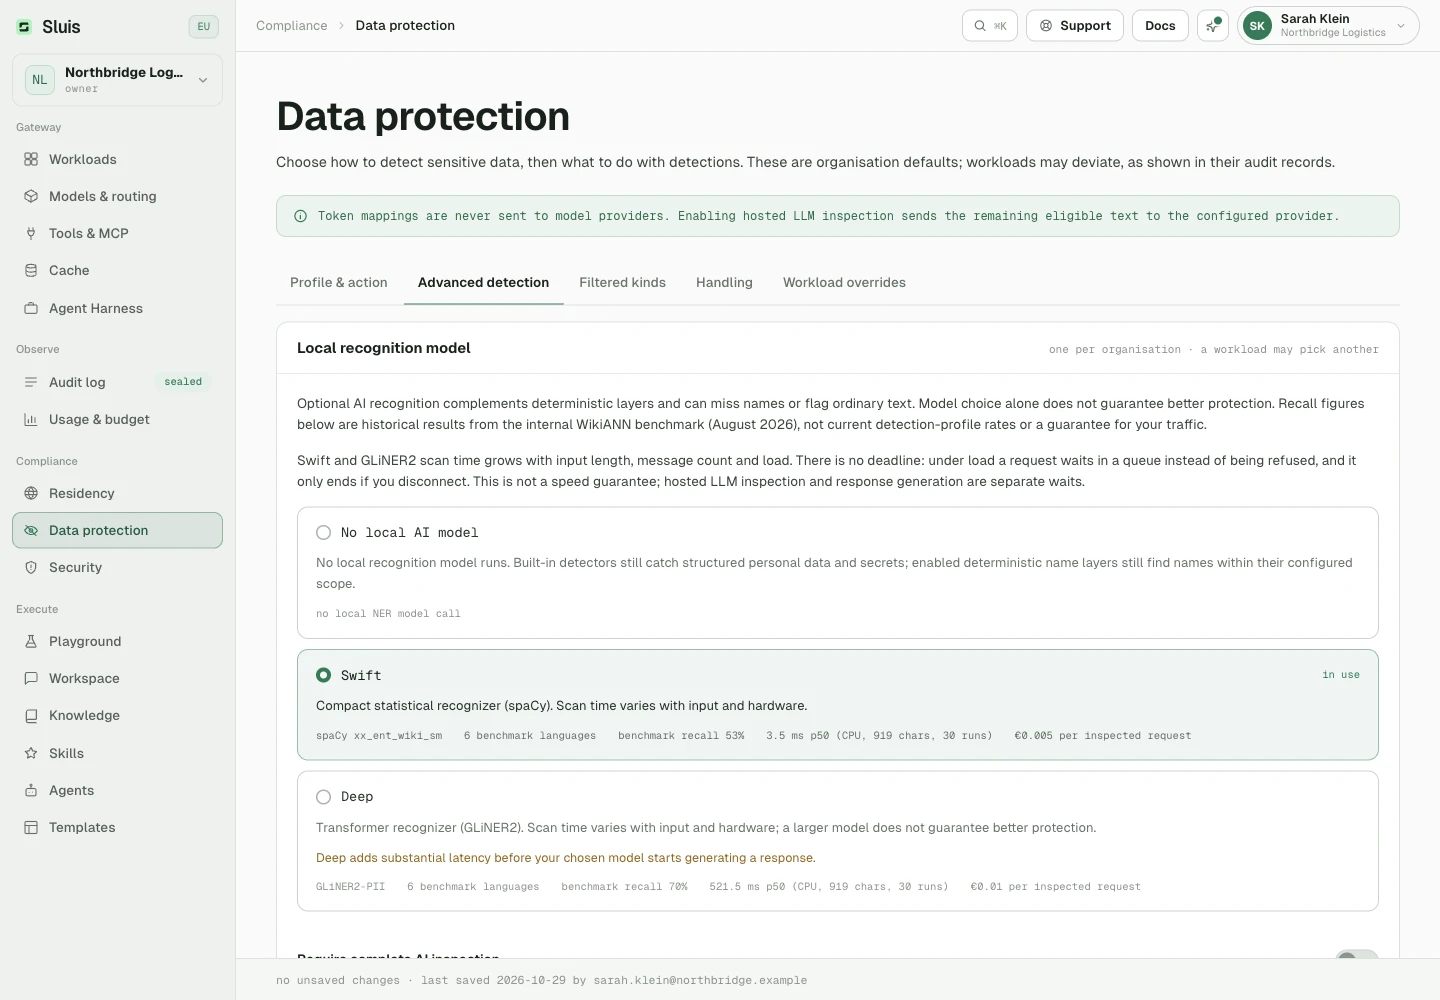
| Model | Pokrycie | Zmierzona dokładność | Opóźnienie |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Zmierzone 2026-08-12 na wewnętrznym benchmarku: zdania testowe WikiANN w sześciu językach (NL, EN, DE, FR, ES, IT; po 150 na język), oceniane jako micro-F1 dla par (etykieta, tekst) na poziomie tekstu, z zastosowanym produkcyjnym filtrem fałszywych trafień, na maszynie deweloperskiej z procesorem Apple silicon w FP32. WikiANN to dane z domeny Wikipedii, o standardzie silver, i naturalny teren spaCy. Traktuj liczby jako względną wskazówkę między poziomami, a nie bezwzględną dokładność w praktyce.
Skanowanie bezpieczeństwa
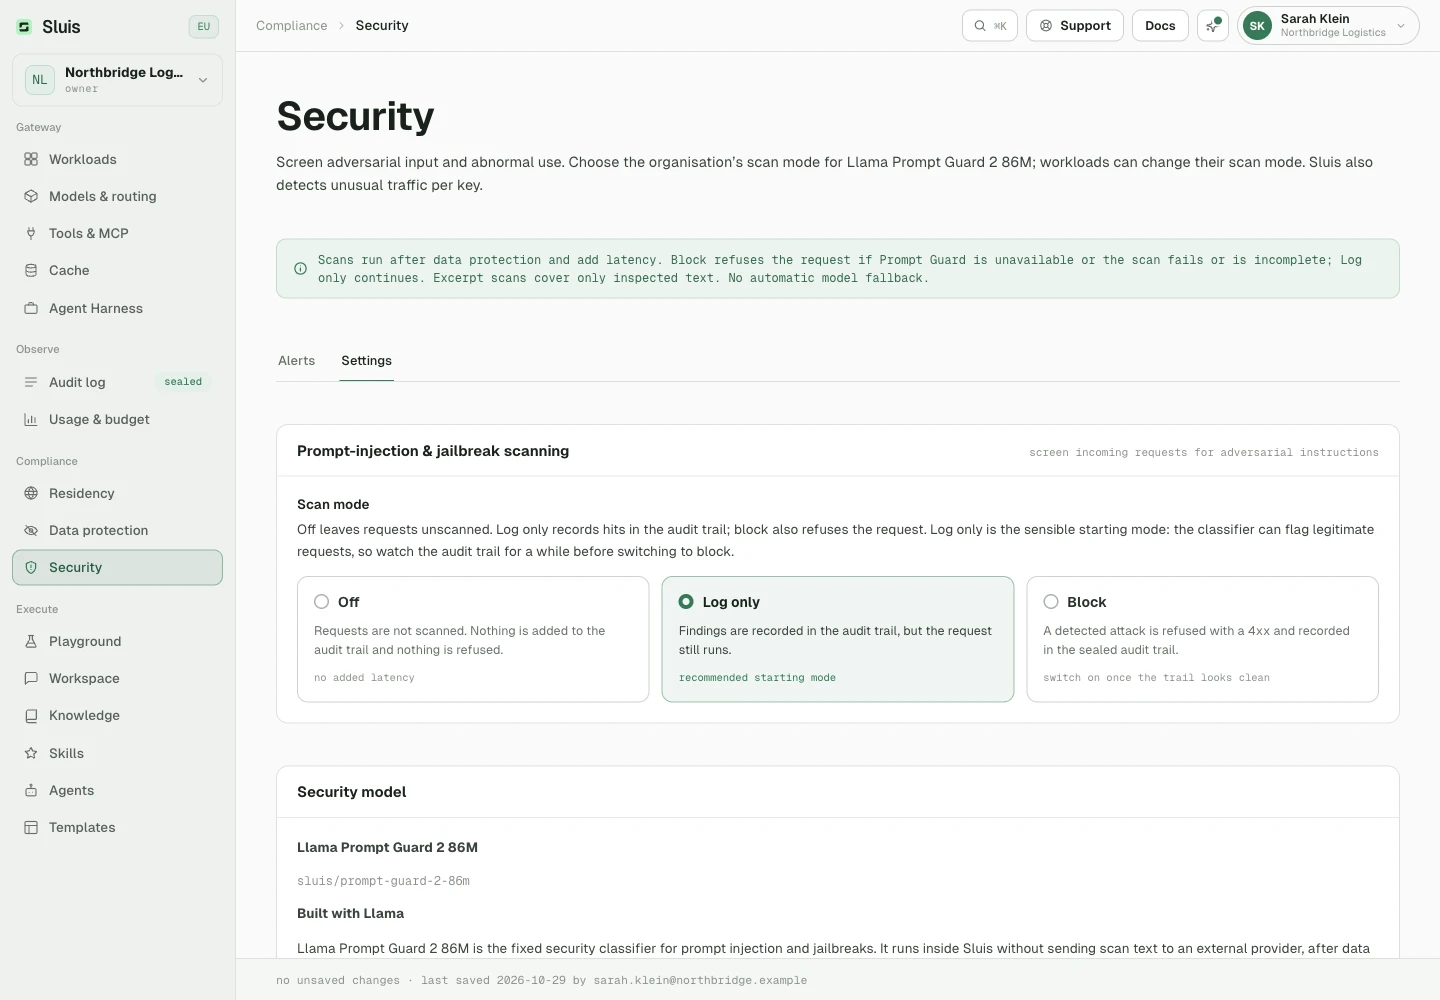
Wykrywanie prompt injection i jailbreaków jest opcjonalne i działa na bramce, przed wysyłką. Ma trzy tryby: off | log | block.
offpomija skan.logzapisuje wyniki bez blokowania ruchu.blockodrzuca wykryte ataki. Działa w trybie fail closed, gdy Prompt Guard jest niedostępny albo klasyfikacja się nie powiedzie lub jest niepełna. Nie ma automatycznego przejścia na inny model.
Jak działa skanowanie
- Bezpieczeństwo zawsze używa Llama Prompt Guard 2 86M (
sluis/prompt-guard-2-86m) wewnątrz Sluis, bez przesyłania tekstu skanu na zewnątrz. - Nakładające się okna o długości najwyżej 512 tokenów modelu zachowują granice segmentów, w ramach łącznego budżetu skanu od 4096 do 65 536 tokenów (domyślnie 8192).
- Próg wykrywania jest stały i wynosi 0,8.
- Długie dane wejściowe używają wybranych fragmentów. Bezpieczny wynik obejmuje tylko sprawdzony tekst, a nie całość danych. Wpis audytu zachowuje liczbę sprawdzonych i wszystkich bajtów.
- Skanowanie podlega ochronie danych, która może zachować dane osobowe, gdy jest wyłączona lub tylko loguje.
- Skany dodają zmienne opóźnienie. Czekają na skaner, aż odpowie albo wywołujący się rozłączy, i nie ma limitu czasu skanu.
Koszt i audyt
- 0,01 € za każdy ukończony skan logiczny, raz, niezależnie od liczby okien i werdyktu, także dla wyników bezpiecznych ocenionych na próbce. Bez dopłaty za tokeny.
- Wyłączone skany, odmowy przed wysyłką i awarie techniczne nie są rozliczane.
- Każdy skan ma osobny, powiązany rozliczalny wpis w audycie:
security.scan. Opłaty mogą nadal obowiązywać, gdy żądanie nadrzędne zostanie zablokowane lub obsłużone z cache. - Wyjątki workloadu mogą zmieniać tryb skanu.
- Osobno opcjonalna inspekcja prywatności Nemotron korzysta z Nebul zgodnie z Twoją polityką rezydencji i jest rozliczana za tokeny.
Built with Llama. Meta Llama 4 Community License.
Wykrywanie anomalii
Opcjonalne wykrywanie anomalii w zachowaniu kluczy działa jako zadanie w tle, bez żadnego opóźnienia żądań: bazowe profile per klucz z odpornych statystyk z sezonowością godzina tygodnia, plus wielowymiarowa warstwa isolation forest.
Alerty są wyjaśnialne, nigdy nie są gołym wynikiem. Pojawiają się w widoku Bezpieczeństwo w Console, opcjonalnie e-mailem.
Powiadomienie dla modelu
Gdy tokenizacja przepisała żądanie, Sluis wstrzykuje na początku wiadomość systemową informującą model, że tokeny «…» to nieprzezroczyste symbole zastępcze, które musi zachować w nienaruszonym stanie. To właśnie zapewnia niezawodne przywracanie. Jest domyślnie włączone, a możesz je dostosować lub wyłączyć per organizacja.
Retencja i wierność audytu
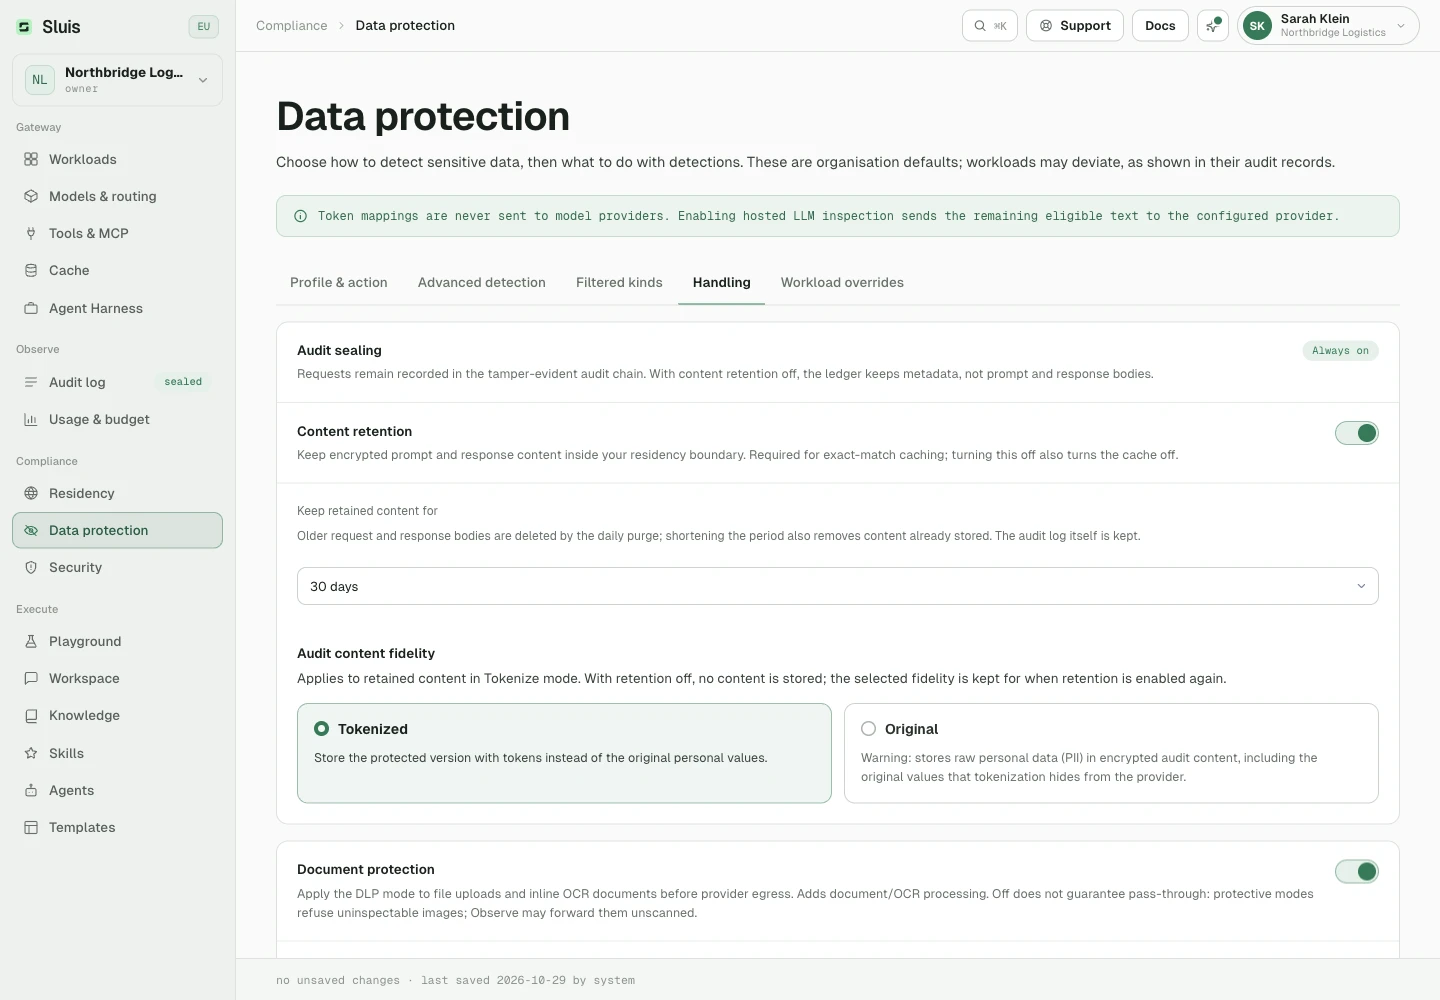
Retencja treści zachowuje body żądań i odpowiedzi na potrzeby dziennika audytu. Jest domyślnie włączona i szyfrowana w spoczynku.
- Wierność audytu decyduje, czy zachowana treść przechowuje tokeny, czy wartości oryginalne.
- Zachowana treść wygasa domyślnie po 30 dniach. W widoku Ochrona danych w Console możesz ustawić inny okres w dniach (od 1 do 36 500) albo zachować ją bezterminowo.
- Codzienne czyszczenie stosuje bieżący okres do treści już zapisanej, więc jego skrócenie usuwa także starszą treść.
- Treść z czatów Sluis Workspace jest usuwana po krótszym z dwóch okresów: tym ustawieniu albo okresie Workspace dla wartości osobowych w czatach (domyślnie 7 dni).
- Rejestr metadanych audytu jest zachowywany i nigdy nie jest zmieniany.
- Wyłącz retencję, aby rejestr zawierał tylko metadane. To wyłącza też cache odpowiedzi.
Anonimizacja dokumentów
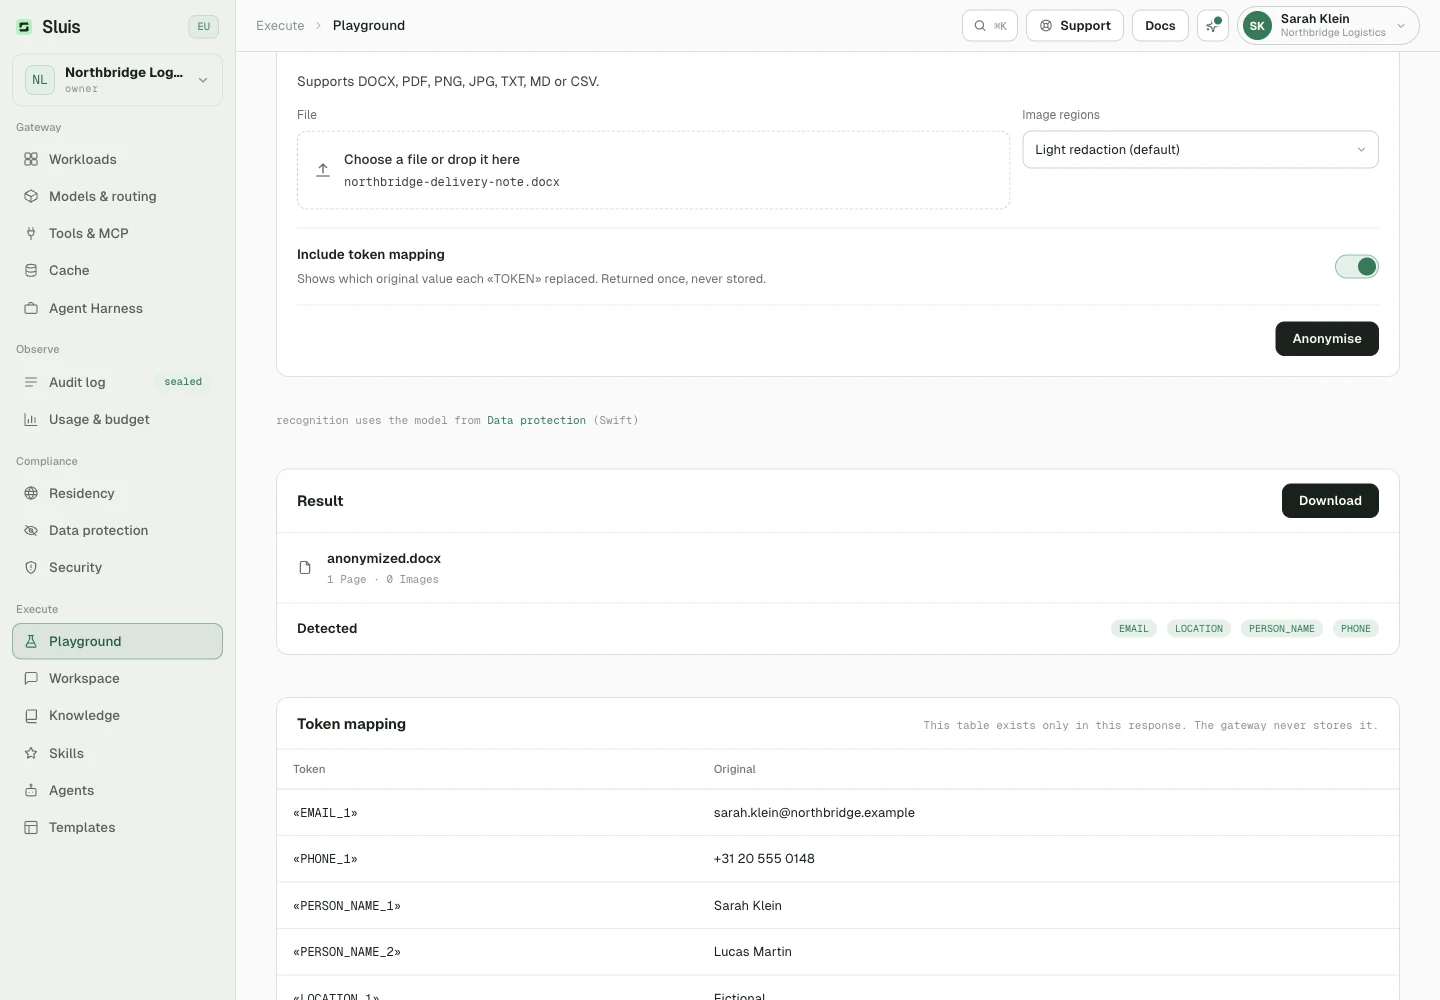
Wyślij plik docx, pdf, obraz lub tekst na POST /v1/documents/anonymize, a ten sam dokument wraca z danymi osobowymi i sekretami zastąpionymi znacznikami, takimi jak «PERSON_NAME_1», w tekście oraz rozmytymi na obrazach i stronach PDF.
- Przetwarzanie jest lokalne w gateway, wraz z OCR. Operacja jest pieczętowana w łańcuchu audytu i rozliczana za stronę lub obraz.
- Zredagowane PDF-y zachowują niewidoczną, przeszukiwalną warstwę tekstu zbudowaną z zanonimizowanego tekstu.
- Dla dużych dokumentów zakolejkuj zadanie asynchroniczne i odbierz wynik później przez podpisany URL o ograniczonej ważności.
- W skanach linie, których OCR nie odczyta wiarygodnie (podpisy, nieczytelne pismo odręczne), oraz tusz poza każdą rozpoznaną linią tekstu (parafy, pieczęcie) są niszczone, a nie zgadywane. W warstwie tekstu mają postać
«UNREADABLE», a odpowiedź zgłasza kategorięUNREADABLE_REDACTED.
Mapa tokenów
Endpoint synchroniczny zwraca mapę tokenów tylko na Twoją prośbę (include_mapping: true) i gdy wywołujący ma do tego uprawnienia: workload z documents i documents_reidentify albo owner lub admin w Console. Mapa jest pieczętowana w łańcuchu audytu jako liczba i skrót i nigdy nie jest przechowywana. Zadania asynchroniczne odrzucają żądania mapy z kodem 422.
W tranzycie
Ta sama ochrona działa w tranzycie. Z włączoną polityką dlp_documents pliki wysyłane przez /v1/files i dokumenty OCR inline są anonimizowane, zanim wyjdą do dostawcy, odrzucane w trybie block i skanowane w trybie allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddingi
Pseudonimizowane tokeny są stabilne w obrębie jednego żądania, nie między żądaniami, więc embeddingi tokenizowanego tekstu mogą się różnić między wywołaniami.
Ustawienie polityki dlp_embeddings decyduje, czy skanowanie obejmuje /v1/embeddings. Jest domyślnie włączone. Ustawienie off wysyła dane wejściowe embeddingów do dostawcy bez skanowania, a każde zwolnione wywołanie jest odnotowane w dzienniku audytu.
Terminy do usunięcia w żądaniu
Każde żądanie JSON w płaszczyźnie danych (chat completions, completions, embeddings, responses oraz natywne ingressy Anthropic) może nieść na najwyższym poziomie rozszerzenie sluis z listą remove. Wskazuje ona terminy, które gateway musi usunąć z promptu przed wysyłką.
- Każdy wpis to zwykły ciąg znaków albo obiekt z polem
texti polemkindo wartościperson | organization | location | term. - Najwyżej 128 wpisów. Każdy musi być niepusty po przycięciu i mieć najwyżej 256 znaków.
- Dopasowanie działa na granicach słów i ignoruje wielkość liter.
- Rozszerzenie jest konstrukcją gateway. Zawsze znika przed wysyłką i nigdy nie trafia do dostawcy, do cache ani do przechowywanej treści.
# name the terms the gateway must remove: the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out: the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Co dzieje się z dopasowaniem
Każde dopasowanie staje się odwracalnym tokenem, takim jak «PERSON_NAME_1», który dołącza do zwykłej pseudonimizacji:
- W trybie
tokenize, domyślnym, oryginalne wartości są przywracane w odpowiedzi, łącznie ze streamingiem. - W trybie
masktermin zastępuje[REDACTED:<kind>]. - W trybie
blockżądanie jest odrzucane z kodem422.
Instrukcja jest zawsze respektowana, nawet gdy workload ustawia dlp: off, organizacja działa w allow_log albo /v1/embeddings jest zwolnione. Może wyłącznie wzmocnić ochronę, nigdy jej osłabić, i dlatego jest dopuszczona per żądanie tam, gdzie wycofany nagłówek x-sluis-dlp nie był. Wskazany termin nigdy nie dociera do dostawcy.
Błędy i audyt
- Wadliwa dyrektywa nigdy nie jest po cichu ignorowana. Nieznany rodzaj (kind), wpis poza limitami lub nieznane pole wewnątrz rozszerzenia są odrzucane z kodem
422. - To, co faktycznie zadziałało, jest ujawniane w zapieczętowanym wierszu audytu. Terminy podane przez wywołującego niosą warstwę żądania,
dlp:tokenize:person_name(request), odrębną od warstw(ner)i(directory), więc dziennik pokazuje, skąd wzięło się każde usunięcie. - Synchroniczny endpoint
/v1/documents/anonymizeprzyjmuje tę samą listę jako opcjęremove. Zadania asynchroniczne odrzucają ją z kodem422.
Wyjątki workloadu
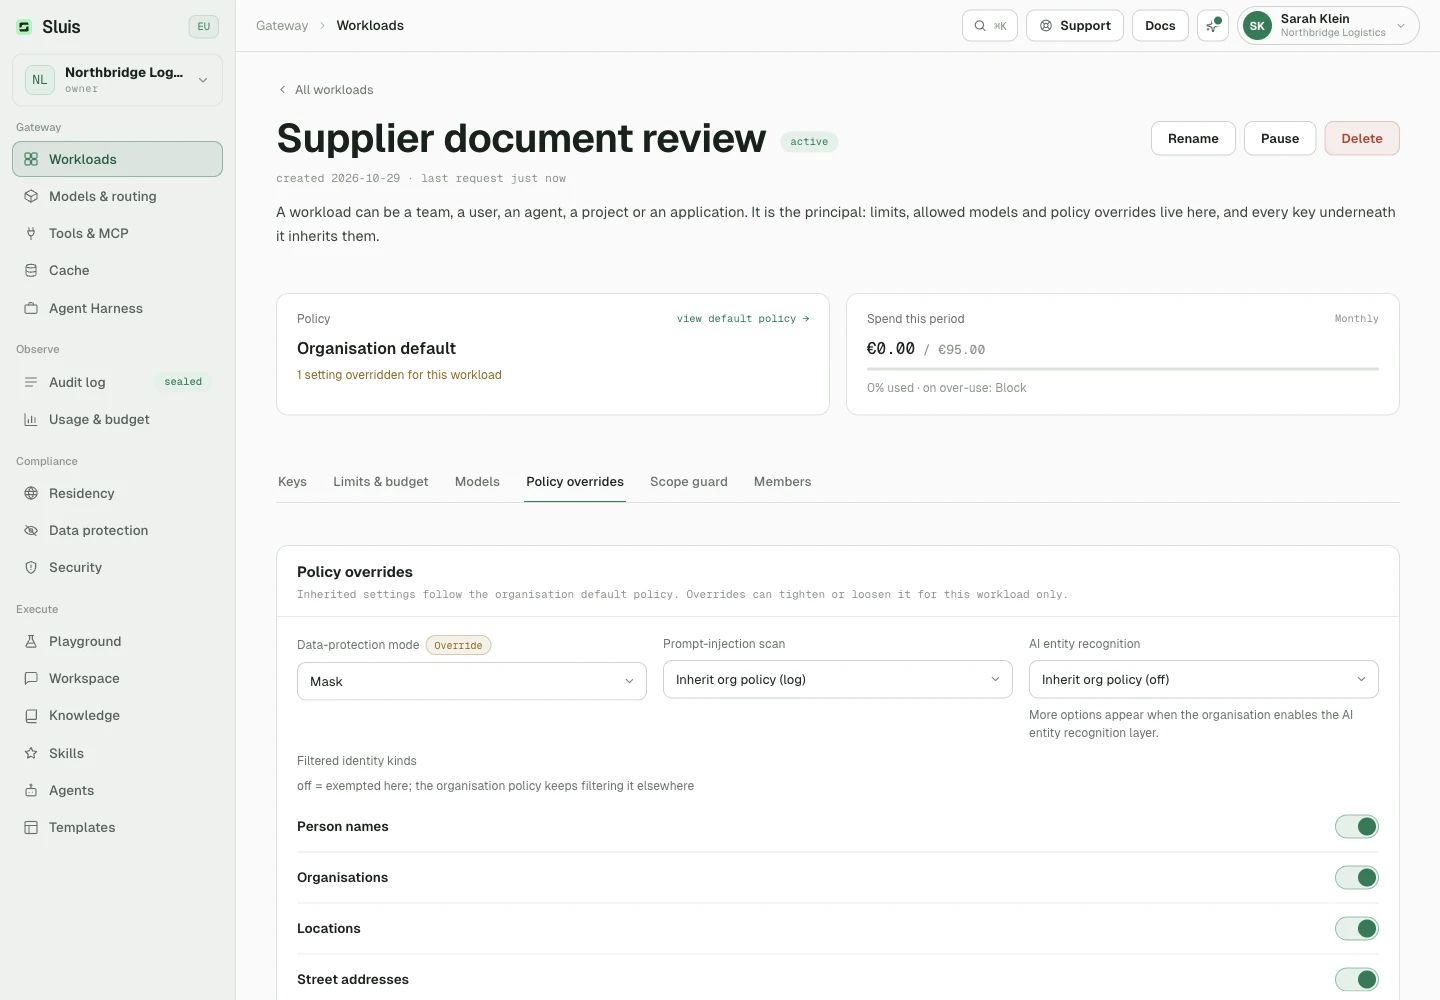
Wyjątki należą do workloadu i dotyczą wszystkich jego poświadczeń. Nieustawione opcje dziedziczą politykę organizacji.
Wybierz ner_model: off, swift lub deep. W dlp.entities ustaw rodzaje nazw, a w dlp.detectors wbudowane detektory, takie jak record_id lub vat_number. Pominięte ustawienia dziedziczą wartości organizacji. Dotyczą także dokumentów i obrazów, przy zachowaniu jej ustawienia i działania ochrony dokumentów. Inny detektor nadal może znaleźć tę samą wartość.
- W Console owner lub admin konfiguruje
option_overridesw Workloads. - Przez API ustaw
option_overridesprzezPOST /admin/workloadspodczas tworzenia workloadu.
Aby edytować istniejący workload, PATCH /admin/workloads/{workload_id} wymaga wszystkich jego edytowalnych ustawień, w tym nazwy, statusu, limitów i budżetu. Zastępuje je zamiast scalać poszczególne pola.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "entities": { "person": true }, "detectors": { "record_id": false } },
        "ner_model": "swift",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
Nagłówek żądania x-sluis-dlp został usunięty. Żądania z nim otrzymują 400, więc skonfiguruj workload. Obowiązujące wyjątki są zapisywane w zapieczętowanym dzienniku audytu.