Gegevensbescherming
Detectiemodi, de bibliotheek met 61 detectoren, entiteitsdetectie en kiesbare modellen, beveiligingsscans, de modelnotitie en retentie.
Gegevensbescherming draait op elk verzoek, vóór verzending. De standaardmodus is tokenize: elke gedetecteerde waarde zonder passende uitzondering wordt vervangen door een stabiele, getypeerde token zoals «EMAIL_1».
Beschermde waarden bereiken de provider alleen als tokens. Op de terugweg naar jou wordt het antwoord hersteld naar de echte waarden, gestreamd of niet.
De tokenmap staat in het geheugen zolang het verzoek duurt en wordt nooit opgeslagen. Pseudonimisering werkt één kant op: ze beschermt wat jij verstuurt.
In Sluis Workspace worden openbare webzoekresultaten en de eigen uitvoer van het model eerder in dezelfde beurt niet opnieuw getokeniseerd. Een waarde die het gesprek al heeft getokeniseerd, blijft vervangen door zijn token, en het auditlog registreert wanneer dit gold.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives: only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back: restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Vier modi bepalen wat er met een gedetecteerde waarde gebeurt:
tokenize(de standaard) vervangt de waarde door een omkeerbare token.maskherschrijft de waarde onomkeerbaar.blockweigert het verzoek met422.allow_loglaat de waarde door en markeert tegelijk de auditregel.
61 ingebouwde detectoren zijn er meteen: 29 voor persoonsgegevens, van het Amerikaanse Social Security-nummer tot nationale ID's die zijn gevalideerd met de checksum-, datum- of formaatregels van elk land, en 32 voor secrets en credentials. Elke detector is per organisatie in of uit te schakelen. Eigen termen (gewoon of regex) dekken alles wat specifiek is voor jouw bedrijf, en het label van een eigen term mag maximaal 32 tekens lang zijn:
Patroonuitzonderingen
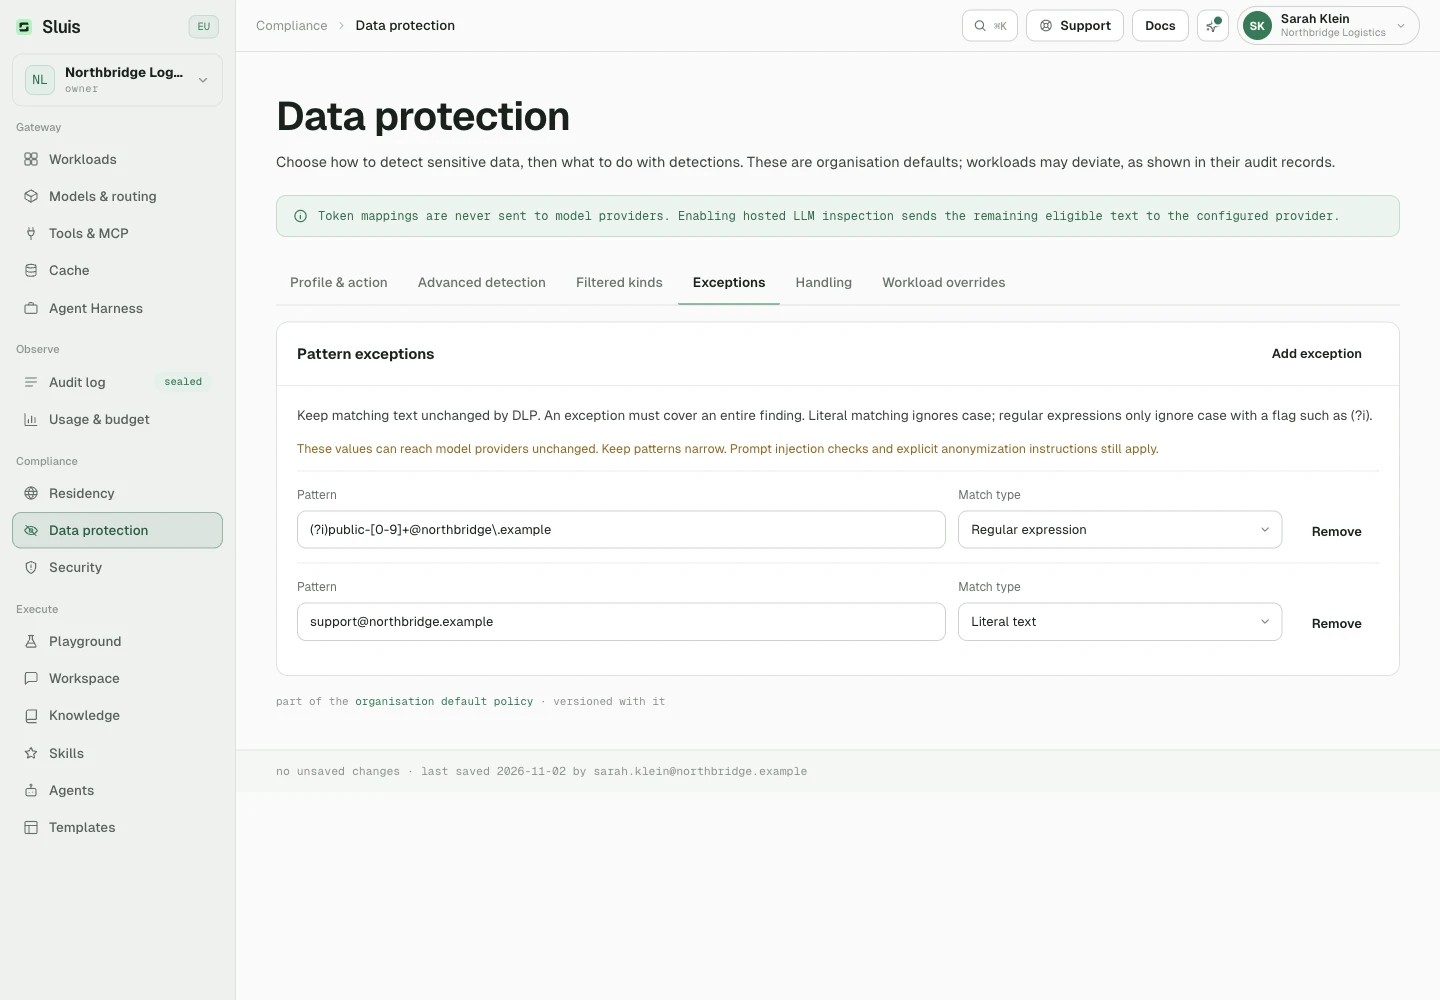
Voeg bij Console › Gegevensbescherming › Uitzonderingen letterlijke tekst of een reguliere expressie toe voor waarden die je bewust ongewijzigd wilt laten, zoals het openbare adres support@northbridge.example.
- Letterlijke patronen negeren hoofdletters en kleine letters, ook bij Unicode-letters.
- Reguliere expressies gebruiken Rust-regexsyntaxis en zijn hoofdlettergevoelig, tenzij je
(?i)toevoegt. - Eén uitzonderingsmatch in de oorspronkelijke tekst moet de hele gedetecteerde waarde bevatten. Een gedeeltelijke match volstaat niet; losse aangrenzende of overlappende matches worden nooit samengevoegd.
Gebruik gerichte patronen. Een uitgezonderde waarde wordt niet getokeniseerd, gemaskeerd of gebruikt om het verzoek te blokkeren. De oorspronkelijke tekst kan dus bij de modelprovider terechtkomen. Andere gedetecteerde waarden blijven beschermd.
Uitzonderingen gelden voor ingebouwde en eigen detectoren, namen, woordenboeken en lokale of gehoste entiteitherkenning, ook in beschermde documenttekst en embeddings. Promptinjectiescans en andere beveiligingscontroles blijven actief. Expliciete verwijdertermen in sluis.remove of een documentverzoek gaan altijd voor.
Entiteitsdetectie
Personen, organisaties en locaties zijn alleen met patronen moeilijk te herkennen. Sluis combineert daarom meerdere lagen:
- contextheuristieken
- e-mailcorrelatie
- een namenlijst per tenant
- meegeleverde woordenboeken
- optionele NER (herkenning van benoemde entiteiten)
Het NER-model draait als netwerkinterne sidecar, dus tekst blijft binnen de perimeter van de deployment. Deze lagen inspecteren ook geëxtraheerde document- en OCR-tekst wanneer documentbescherming aanstaat.
- Met NER aan kan één verzoek maximaal 100.000 verschillende entiteiten en 6,4 miljoen tekens tekst bevatten. Daarboven telt de scan als onvolledig.
- Een naam die het model één keer detecteert, wordt overal in het verzoek vervangen waar hij terugkomt: hetzelfde hele woord, met dezelfde hoofdletters en dezelfde token, ook in berichten waar het model hem niet meldde.
- Losse algemene woorden en korte acroniemen dekken alleen de plek die het model meldde.
Namenwoordenboek
Het namenwoordenboek is de deterministische tegenhanger van NER: voornamen en achternamen, samengesteld uit open overheidsdata tot een woordenboek dat in de gateway wordt meegeleverd.
- Het vangt volledige namen en namen na een aanspreektitel, zonder extra vertraging en zonder dat er iets je perimeter verlaat.
- Namen die ook gewone woorden zijn, worden alleen gevangen met naamvormige context eromheen.
- Zeldzame namen blijven het werk van de namenlijst of NER.
NER-modelopties
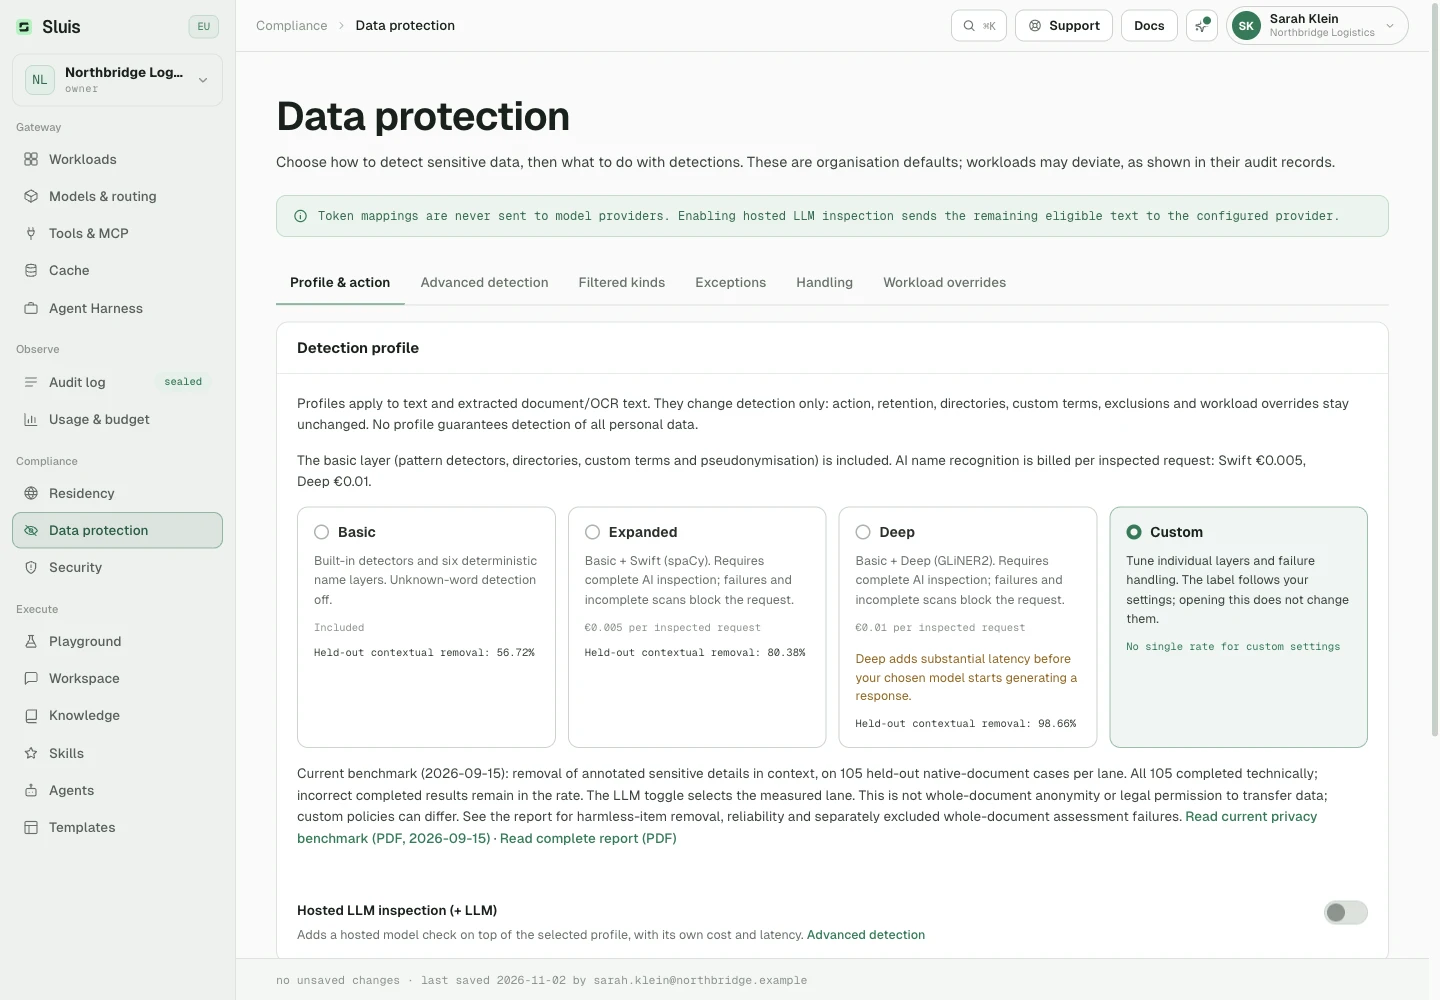
Kies Basis, Uitgebreid of Diepgaand in Gegevensbescherming.
- Basis is de standaard voor nieuwe organisaties. Het gebruikt ingebouwde detectoren en zes deterministische naamlagen, zonder modelaanroep.
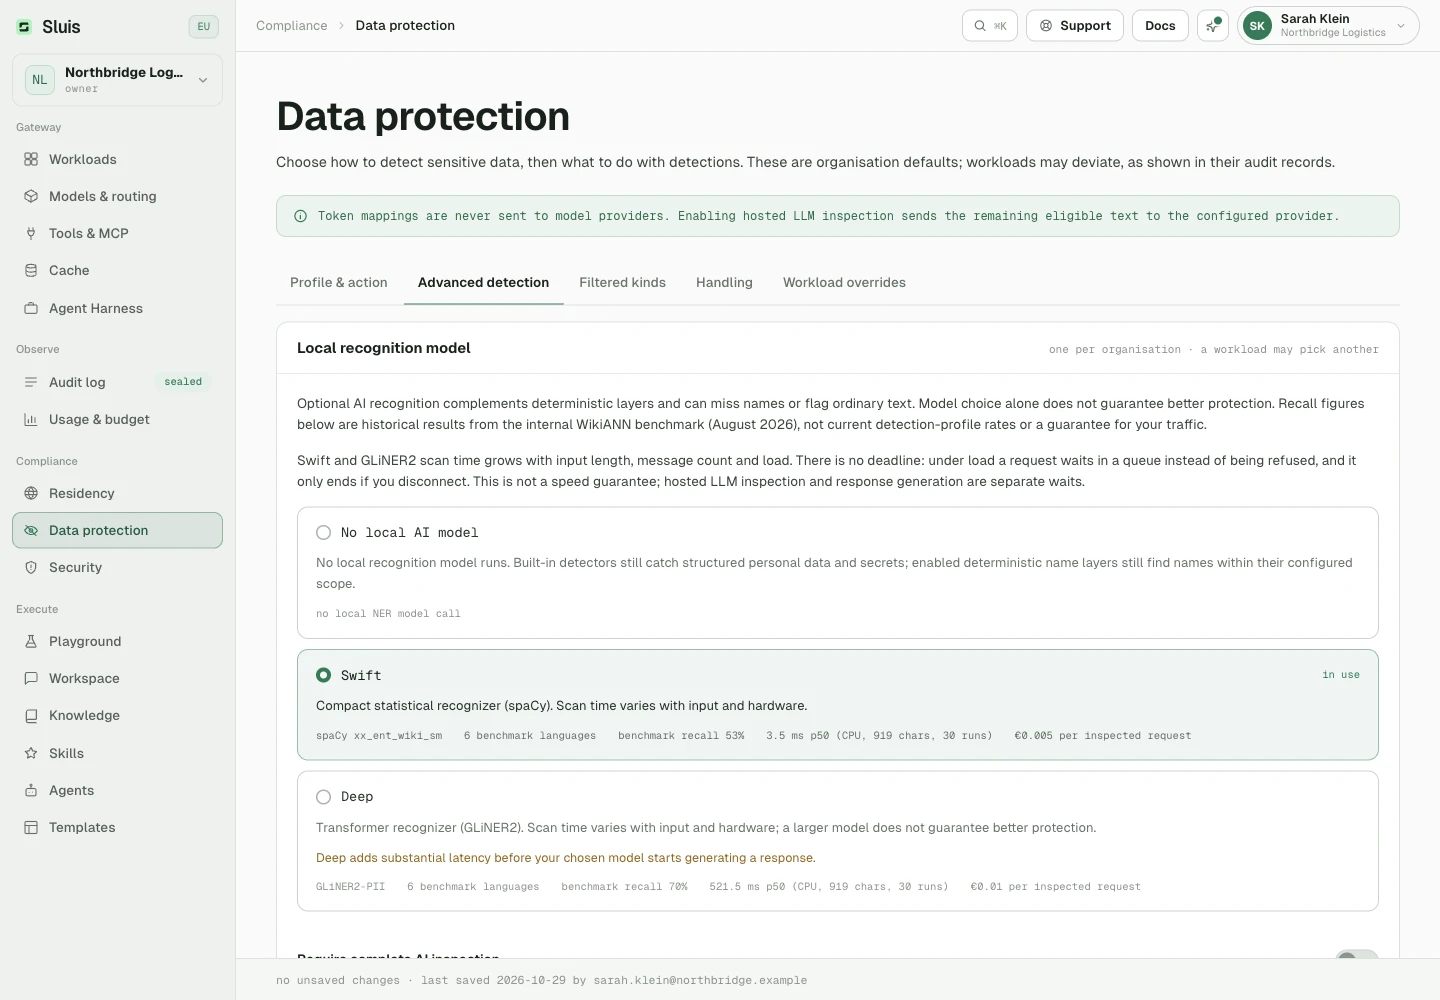
- Uitgebreid voegt Swift (spaCy) toe.
- Diepgaand voegt in plaats daarvan GLiNER2-PII toe. Het kost meer verwerkingstijd, maar garandeert geen hogere recall.
- Aangepast laat individuele verfijning toe.
Beide modelprofielen vereisen volledige inspectie en blokkeren modeluitval of onvolledige scans.
- Bestaand beleid, uitsluitingen, namenlijsten en workload-afwijkingen blijven ongewijzigd.
- Onbekendewoorddetectie staat in alle drie de profielen uit.
- Een workload kan een beschikbaar NER-model kiezen, ook als de organisatie het standaard uit heeft.
Facturatie
- AI-naamherkenning wordt één keer gefactureerd per klantverzoek dat het inspecteert: €0,005 met Swift (Uitgebreid), €0,01 met GLiNER2 (Diepgaand). Basis is inbegrepen.
- Vervolgaanroepen die Sluis binnen dat verzoek doet, worden niet opnieuw gefactureerd, en een onvolledige inspectie kost niets.
- Elke afschrijving is een gekoppeld auditbewijs en telt mee voor je budgetten.
Latency
- Diepgaand voegt aanzienlijke wachttijd toe voordat het model dat je koos een antwoord begint te genereren.
- De scantijd van Swift en GLiNER2 groeit met tekstlengte, aantal berichten en belasting.
- Er is geen tijdslimiet: onder belasting wacht een verzoek in een wachtrij in plaats van geweigerd te worden, en het eindigt alleen als je de verbinding verbreekt. Dit is geen snelheidsgarantie.
- Optionele gehoste LLM-inspectie voegt een aparte wachttijd toe vóór antwoordgeneratie, afhankelijk van tekstlengte, providerbelasting en nieuwe pogingen.
| Model | Dekking | Gemeten nauwkeurigheid | Latency |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Gemeten op 2026-08-12 in een interne benchmark: WikiANN-testzinnen in zes talen (NL, EN, DE, FR, ES, IT; 150 per taal), gescoord als micro-F1 over (label, tekst)-paren op tekstniveau, met het productiefilter tegen valse positieven toegepast, op een Apple Silicon-ontwikkelmachine in FP32. WikiANN is automatisch geannoteerd Wikipedia-materiaal en het thuisterrein van spaCy. Lees de cijfers als relatieve richtlijn tussen de niveaus, niet als absolute nauwkeurigheid in het veld.
Securityscanning
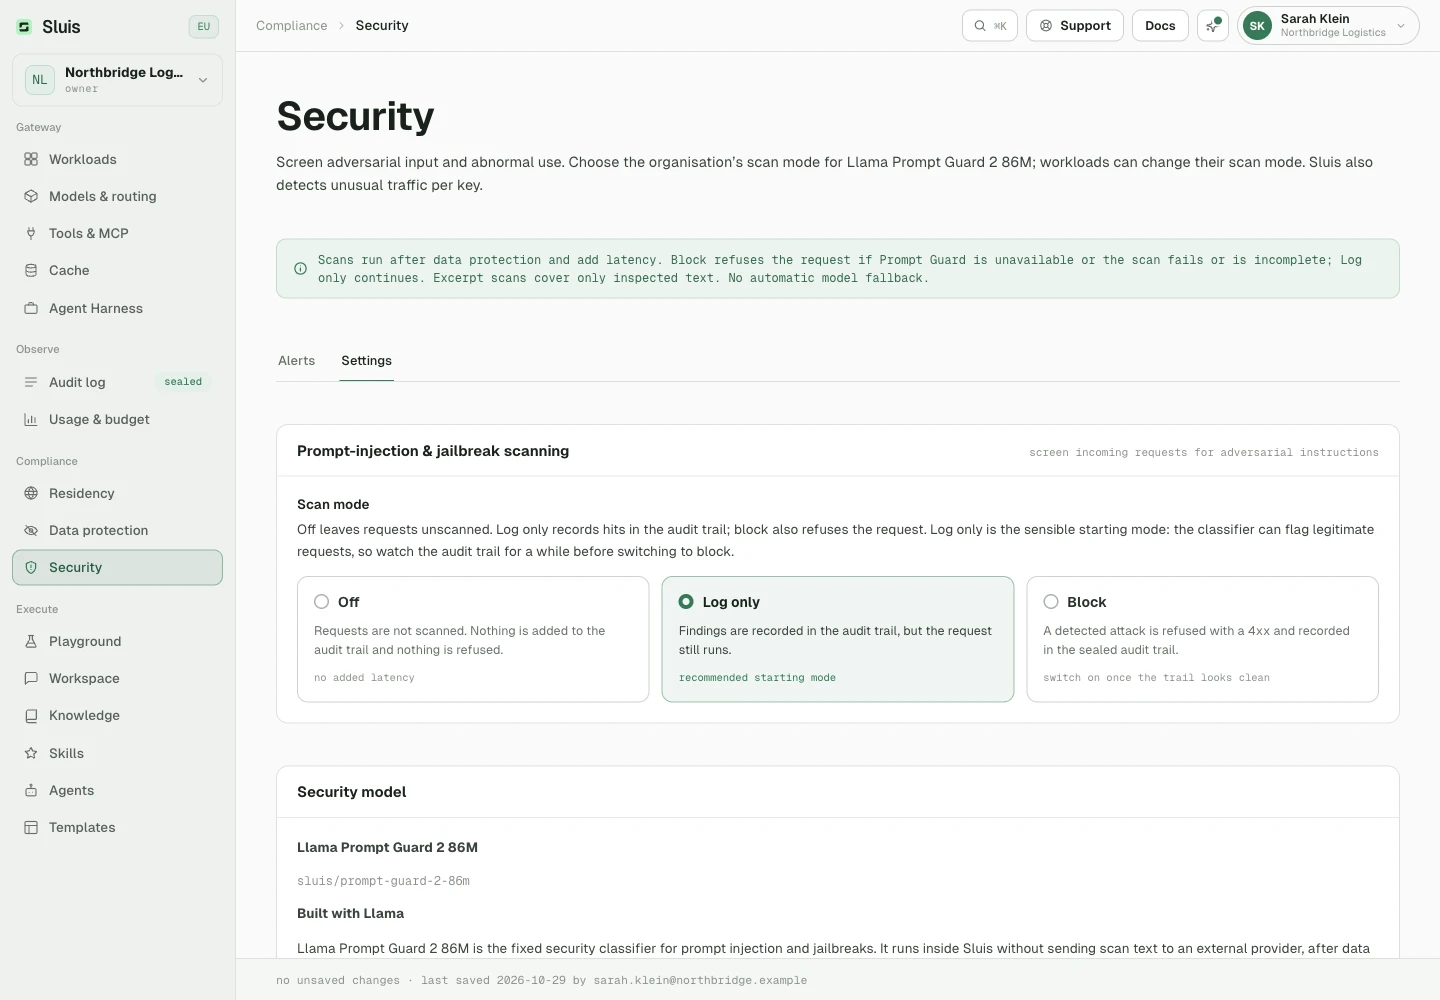
Detectie van prompt injection en jailbreaks is opt-in en draait bij de gate, vóór verzending. Er zijn drie modi: off | log | block.
offslaat de scan over.logregistreert bevindingen zonder verkeer te blokkeren.blockweigert gedetecteerde aanvallen. Het faalt gesloten als Prompt Guard niet beschikbaar is of de classificatie mislukt of onvolledig is. Er is geen automatische modelterugval.
Hoe scannen werkt
- Beveiliging gebruikt altijd Llama Prompt Guard 2 86M (
sluis/prompt-guard-2-86m), binnen Sluis, zonder externe overdracht van scantekst. - Overlappende vensters van maximaal 512 modeltokens behouden segmentgrenzen, binnen een totaal scanbudget van 4096 tot 65536 tokens (standaard 8192).
- De detectiedrempel ligt vast op 0,8.
- Lange invoer gebruikt gekozen fragmenten. Een veilig oordeel dekt alleen de geïnspecteerde tekst, niet de hele invoer. Het auditrecord bewaart de geïnspecteerde en de totale bytes.
- De scan volgt gegevensbescherming, die persoonsgegevens kan behouden als die uitstaat of alleen logt.
- Scans voegen wisselende latency toe. Ze wachten op de scanner tot die antwoordt of de aanroeper de verbinding verbreekt, en er is geen scantijdslimiet.
Kosten en audit
- €0,01 per afgeronde logische scan, één keer, ongeacht vensters of oordeel, ook bij veilige steekproeven. Geen tokentoeslag.
- Uit, vooraf geweigerde scans en technische fouten worden niet berekend.
- Elke scan heeft een aparte, gekoppelde factureerbare auditregel:
security.scan. Kosten kunnen ook ontstaan als het oorspronkelijke verzoek wordt geblokkeerd of uit de cache wordt beantwoord. - Workload-afwijkingen kunnen de scanmodus wijzigen.
- Los daarvan gebruikt de optionele Nemotron-privacyinspectie Nebul onder je residencybeleid en wordt per token afgerekend.
Built with Llama. Meta Llama 4 Community License.
Anomaliedetectie
Optionele anomaliedetectie op keygedrag draait als achtergrondjob zonder extra latency voor verzoeken: baselines per key uit robuuste statistiek met uur-van-de-week-seizoenspatroon, plus een multivariate isolation-forest-laag.
Meldingen zijn uitlegbaar, nooit een kale score. Ze verschijnen in de weergave Beveiliging van de Console, desgewenst ook per e-mail.
Modelnotitie
Als tokenisatie een verzoek heeft herschreven, injecteert Sluis vooraan een systeembericht dat het model vertelt dat de «…»-tokens ondoorzichtige placeholders zijn die het intact moet laten. Dat houdt het herstel betrouwbaar. Het staat standaard aan, en je kunt het per organisatie aanpassen of uitschakelen.
Retentie & auditgetrouwheid
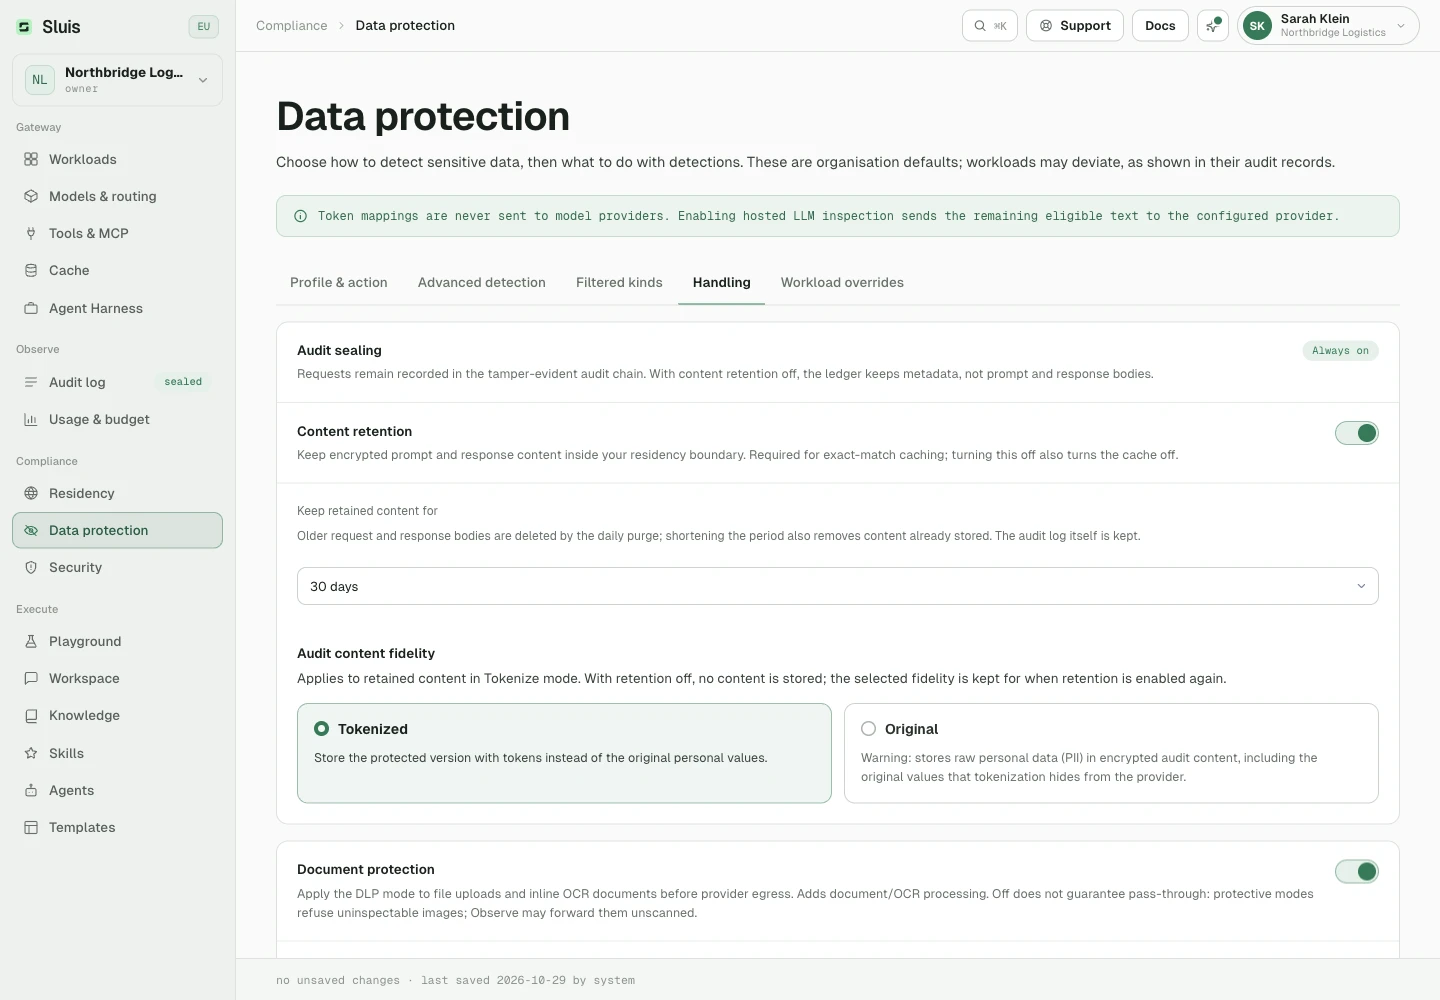
Contentretentie bewaart request- en response-bodies voor het auditlog. Ze staat standaard aan en is versleuteld in rust.
- Auditgetrouwheid bepaalt of bewaarde content de tokens of de originele waarden opslaat.
- Bewaarde content verloopt standaard na 30 dagen. In de weergave Gegevensbescherming van de Console stel je een andere termijn in dagen in (1 tot 36.500), of bewaar je alles onbeperkt.
- Een dagelijkse opschoning past de huidige termijn toe op content die al is opgeslagen, dus een kortere termijn verwijdert ook oudere content.
- Content uit Sluis Workspace-chats wordt verwijderd na de kortste van die termijn en de Workspace-termijn voor persoonlijke waarden in chats (standaard 7 dagen).
- Het grootboek met auditmetadata blijft bewaard en wordt nooit gewijzigd.
- Zet retentie uit voor een grootboek met alleen metadata. Dat schakelt ook de responscache uit.
Documentanonimisering
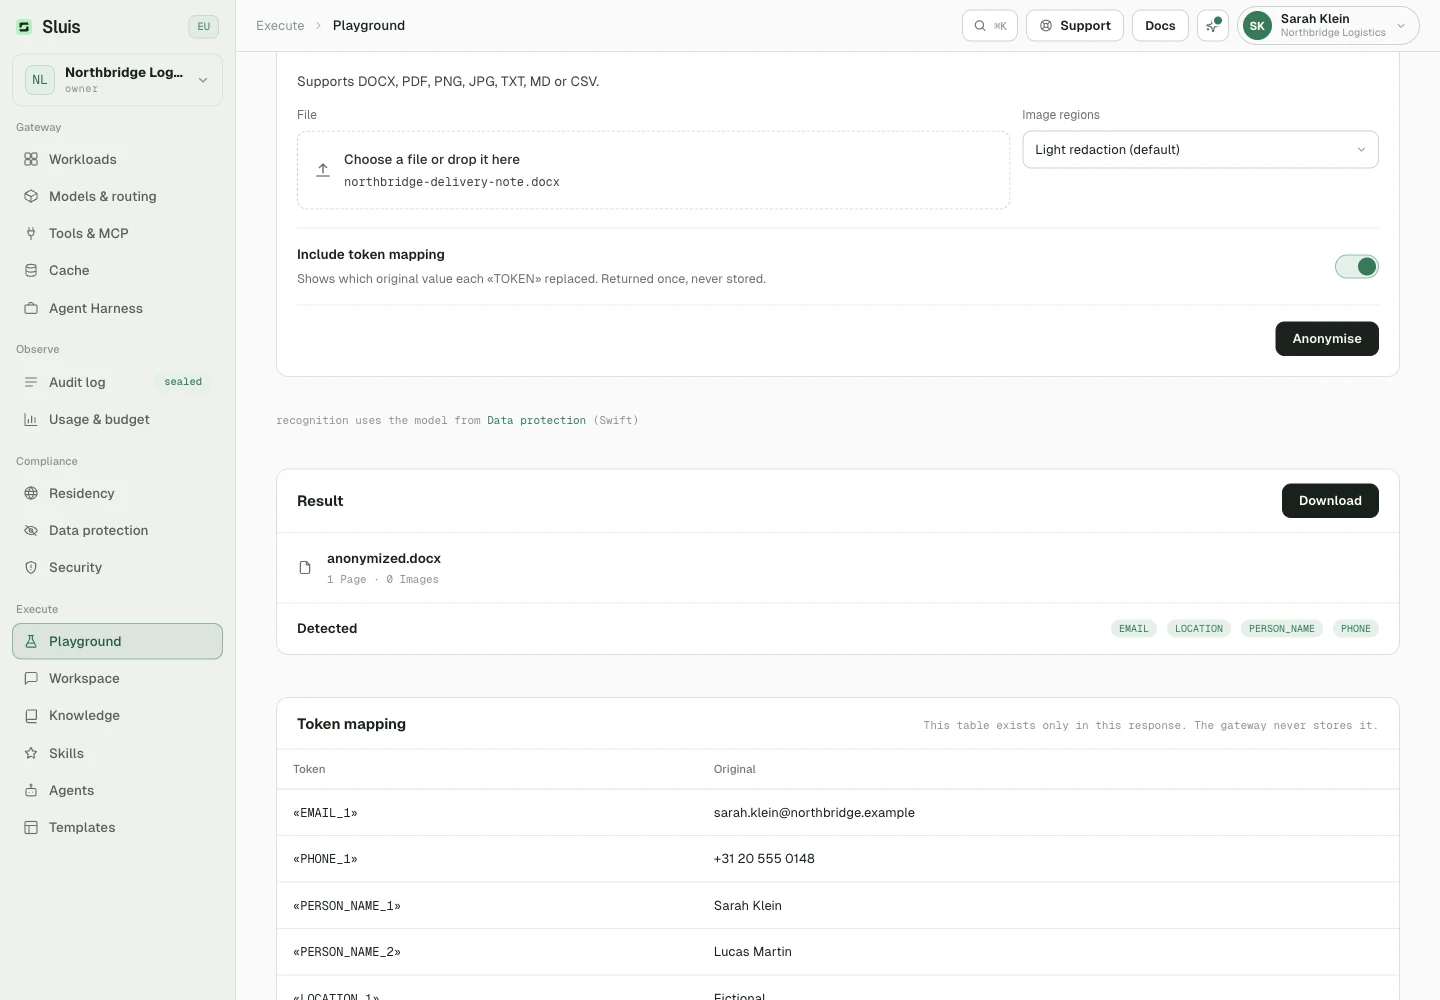
Stuur een docx-, pdf-, afbeeldings- of tekstbestand naar POST /v1/documents/anonymize en hetzelfde document komt terug met persoonsgegevens en secrets vervangen door merge tags zoals «PERSON_NAME_1» in tekst, en vervaagd in afbeeldingen en PDF-pagina's.
- De verwerking blijft lokaal in de gateway, OCR inbegrepen. De operatie wordt verzegeld in de auditketen en gemeten per pagina of afbeelding.
- Geredigeerde PDF's behouden een onzichtbare doorzoekbare tekstlaag, opgebouwd uit de geanonimiseerde tekst.
- Voor grote documenten zet je een asynchrone job in de wachtrij en haal je het resultaat later op via een tijdgebonden ondertekende URL.
- Op scans worden regels die de OCR niet betrouwbaar kan lezen (handtekeningen, onleesbaar handschrift) en inkt buiten elke herkende tekstregel (paraaf, stempels) vernietigd in plaats van geraden. Ze staan als
«UNREADABLE»in de tekstlaag, en het antwoord meldt de categorieUNREADABLE_REDACTED.
Tokenmapping
Het synchrone endpoint geeft de tokenmapping alleen terug als je erom vraagt (include_mapping: true) en de aanroeper daartoe gerechtigd is: een workload met documents en documents_reidentify, of een eigenaar of beheerder van de Console. De mapping wordt in de auditketen verzegeld als aantal en hash en nooit opgeslagen. Asynchrone jobs weigeren mappingverzoeken met 422.
Onderweg
Dezelfde bescherming werkt onderweg. Met het beleid dlp_documents aan worden bestanden die via /v1/files binnenkomen en inline OCR-documenten geanonimiseerd voordat ze naar een provider vertrekken, geweigerd onder block en gescand onder allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Gepseudonimiseerde tokens zijn stabiel binnen één verzoek, niet over verzoeken heen. Embeddings van getokeniseerde tekst komen daarom tussen aanroepen mogelijk niet overeen.
De beleidsinstelling dlp_embeddings bepaalt of de scan /v1/embeddings dekt. Ze staat standaard aan. Zet je haar op off, dan gaan embeddinginvoer ongescand naar de provider, en elke uitgezonderde aanroep wordt in de auditketen vastgelegd.
Verwijdertermen per verzoek
Elk JSON-verzoek op het datavlak (chat completions, completions, embeddings, responses en de native Anthropic-ingresses) mag een sluis-extensie op het hoogste niveau dragen, met een remove-lijst. Die noemt de termen die de gateway vóór verzending uit de prompt moet verwijderen.
- Elk item is een kale string, of een object met een
texten eenkinduitperson | organization | location | term. - Hoogstens 128 items. Elk is niet leeg na trimmen en maximaal 256 tekens lang.
- Matching gaat op woordgrenzen en negeert hoofdletters.
- De extensie is een constructie van de gateway. Ze wordt altijd vóór verzending verwijderd en bereikt nooit een provider, de cache of bewaarde content.
# name the terms the gateway must remove: the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out: the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Wat er met een match gebeurt
Elke match wordt een omkeerbare token zoals «PERSON_NAME_1» die meeloopt in de gewone pseudonimisering:
- Onder
tokenize, de standaard, worden de oorspronkelijke waarden in het antwoord hersteld, streaming inbegrepen. - Onder
maskvervangt[REDACTED:<kind>]de term. - Onder
blockwordt het verzoek geweigerd met422.
De instructie wordt altijd gehonoreerd, ook als de workload dlp: off zet, de organisatie in allow_log draait of /v1/embeddings is uitgezonderd. Ze kan de bescherming alleen versterken, nooit verzwakken, en daarom mag ze per verzoek waar de ingetrokken header x-sluis-dlp dat niet mocht. De genoemde term bereikt de provider nooit.
Fouten en audit
- Een misvormde instructie wordt nooit stil genegeerd. Een onbekend kind, een item boven de limieten of een onbekend veld binnen de extensie wordt geweigerd met
422. - Wat er werkelijk draaide, staat op de verzegelde auditregel. Door de aanroeper aangeleverde termen dragen de laag request,
dlp:tokenize:person_name(request), onderscheiden van de lagen(ner)en(directory), zodat het logboek toont waar elke verwijdering vandaan kwam. - Het synchrone endpoint
/v1/documents/anonymizeaccepteert dezelfde lijst alsremove-optie. Asynchrone jobs weigeren haar met422.
Workloadinstellingen overschrijven
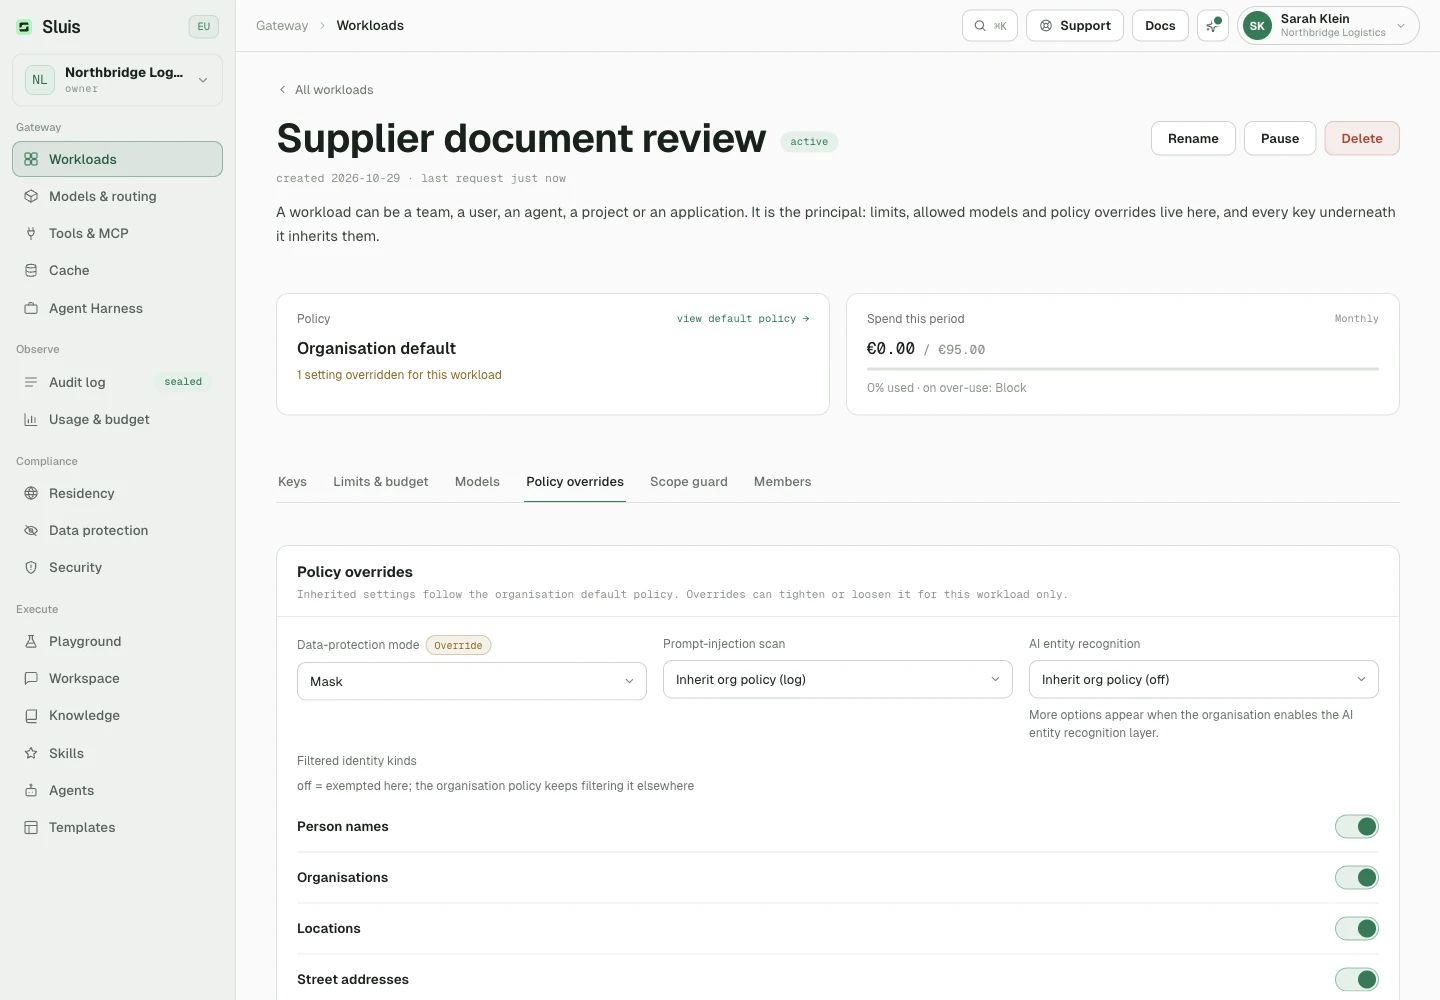
Afwijkingen horen bij de workload en gelden voor al zijn credentials. Opties die je niet instelt, erven het organisatiebeleid.
Kies bij ner_model voor off, swift of deep. Stel onder dlp.entities naamsoorten in en onder dlp.detectors ingebouwde detectoren zoals record_id of vat_number. Niet-ingestelde keuzes erven de organisatiestandaard. Dit geldt ook voor documenten en afbeeldingen; de documentschakelaar en actie van de organisatie blijven leidend. Een andere detector kan dezelfde waarde nog steeds vinden.
- In de Console configureert een eigenaar of beheerder
option_overridesonder Workloads. - Via de API stel je
option_overridesin metPOST /admin/workloadsbij het aanmaken van een workload.
Om een bestaande workload te wijzigen vereist PATCH /admin/workloads/{workload_id} alle wijzigbare instellingen, inclusief naam, status, limieten en budget. Ze worden vervangen en niet per veld samengevoegd.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "entities": { "person": true }, "detectors": { "record_id": false } },
        "ner_model": "swift",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
De requestheader x-sluis-dlp is verwijderd. Verzoeken die hem dragen, krijgen 400, dus configureer de workload. Effectieve afwijkingen worden vastgelegd in de verzegelde auditketen.