API-referentie
Authenticatie, endpoints, streaming, reasoning en fouten op het OpenAI-oppervlak, de native Anthropic-API's en de compatibiliteitsmatrix per endpoint.
Authenticatie
Elk verzoek naar /v1/* authenticeert met een virtuele key in de Authorization: Bearer-header. Maak keys aan onder Workloads in de Console.
- Het geheim wordt één keer getoond en alleen de hash wordt opgeslagen.
- Een key is een inlogcredential voor een workload. De workload bepaalt ratelimieten, budget, toegestane modellen en beleidsuitzonderingen. Het organisatiebeleid blijft gelden.
- Een key kan een optionele vervaldatum hebben. Daarna wordt de key geweigerd, precies als een onbekende key.
- Een model dat niet op de niet-lege toegestane lijst van de workload staat, wordt geweigerd met een verzegelde
403 permission_errorvoordat er iets wordt verzonden. De weigering zelf komt in de auditketen. - Een workload kan zijn keys beperken tot endpointfamilies, bijvoorbeeld chat en embeddings. Andere families krijgen een verzegelde
403 operation_not_allowedvoordat er iets wordt verzonden. - Voor een productiekey is een geverifieerd e-mailadres nodig.
- Eén uitzondering: de ondertekende downloadlinks voor geanonimiseerde documenten, die beperkt geldig zijn, hebben geen key nodig.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the workload's allow-list never dispatches:
# → 403 permission_error, and the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    {
      "id": "mistral/mistral-large-latest",
      "object": "model",
      "created": 1704067200,
      "owned_by": "mistral",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": 0.55,
        "output_eur_per_mtok": 1.65,
        "cached_input_eur_per_mtok": 0.055,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }],
        "eur_per_page": null,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    },
    {
      "id": "sluis/fast",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": "mistral/mistral-large-latest",
      "pricing": { "input_eur_per_mtok": 0.55, "output_eur_per_mtok": 1.65, "cached_input_eur_per_mtok": 0.055, "audio_input_eur_per_mtok": null, "audio_output_eur_per_mtok": null, "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }], "eur_per_page": null, "eur_per_minute": null, "eur_per_image": null, "estimated": false }
    },
    {
      "id": "sluis/auto",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": null,
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": null
    },
    {
      "id": "sluis/ocr",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "ocr",
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": null,
        "output_eur_per_mtok": null,
        "cached_input_eur_per_mtok": null,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [],
        "eur_per_page": 0.01,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    }
  ]
}
Endpoints
Sluis biedt hieronder het OpenAI-compatibele oppervlak, plus de native Anthropic-paden die verderop staan beschreven.
Endpoints zonder eigen handler worden ongewijzigd doorgestuurd naar de gerouteerde provider, streaming inbegrepen, zodat OpenAI-compatibele upstreams hun volledige getrouwheid houden.
Een browser die een pad opent dat de API niet bedient, zoals de kale API-host, wordt doorgestuurd naar deze docs. API-clients krijgen gewoon een 404.
| Endpoint | Doel |
|---|---|
| POST / | Chat completions, het hoofdoppervlak: routing, gegevensbescherming, caching, streaming. |
| POST / | Verouderde tekstcompletions. |
| POST / | Embeddings. |
| POST / | Moderatieclassificatie. |
| POST / | De OpenAI Responses API. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | Document-OCR (Mistral, of volledig lokaal met model sluis/ocr), gefactureerd per pagina. Met het beleid dlp_documents aan worden inline documenten geanonimiseerd voordat ze vertrekken. |
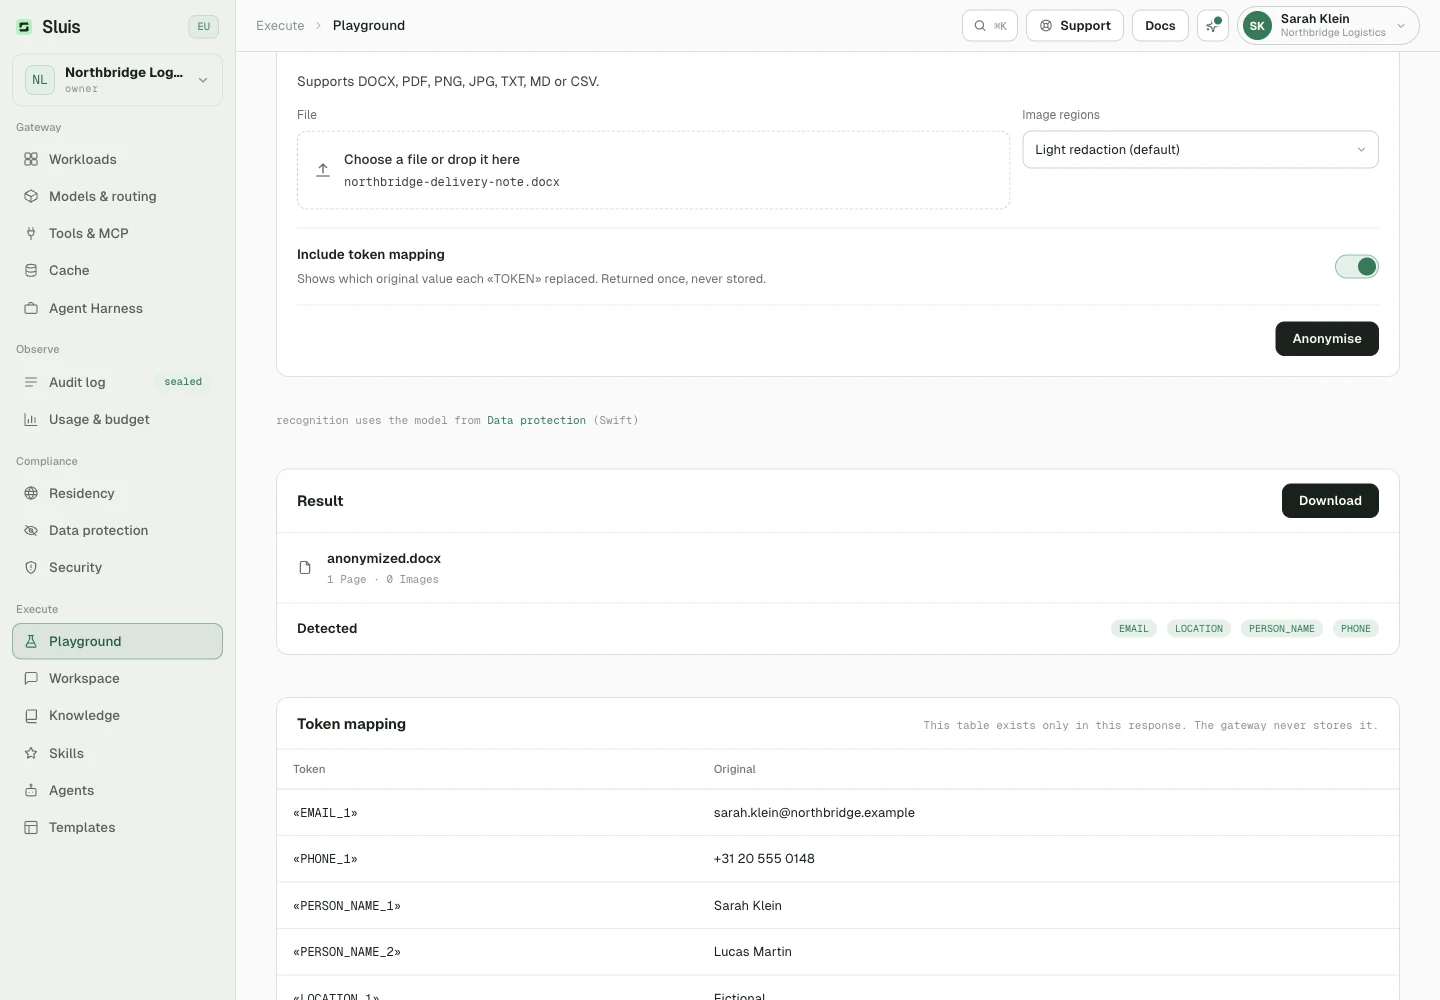
| POST / | Documentanonimisering: persoonsgegevens vervangen door «MERGE_TAG»s, afbeeldingen vervaagd. Gefactureerd per pagina of afbeelding. |
| POST / | Asynchrone anonimiseringsjobs: zet een groot document in de wachtrij, poll /jobs/{id} en haal /jobs/{id}/result op. De ondertekende downloadlink (/v1/documents/deliverables/{id}) is beperkt geldig en heeft geen API-key nodig. |
| GET / | Modellen toegestaan door je beleid, credentials en workload, met type, contextvenster, mogelijkheden, residency, aliasdoel en de uiteindelijke EUR-prijs van deze organisatie, exclusief btw. |
| GET / | Metadata en organisatiespecifieke prijs van één model, in dezelfde vorm als de lijst. |
| POST / | Transcriptie, vertaling en spraak, doorgestuurd naar de gerouteerde provider. Met model sluis/transcribe voert POST /v1/audio/transcriptions de eigen spraakherkenning van Sluis uit, met sprekerherkenning. Zie Spraak naar tekst. |
| POST / | Beeldgeneratie en bewerkingen, doorgestuurd. mistral/image-generation is de uitzondering: Mistral levert dit alleen via zijn agentconnector, dus de gateway vertaalt het OpenAI-verzoek en antwoordt met b64_json, gefactureerd per afbeelding. |
| POST / | Videogeneratie, doorgestuurd. |
| / | Bestandsbewerkingen, doorgestuurd op de eigen key van je organisatie (BYOK of een eigen provider). Bestanden met purpose=batch zijn de uitzondering: zij gaan via de eigen poort van de gateway en mogen beheerde keys gebruiken. |
| / | Batches in OpenAI-vorm: upload een JSONL-bestand met purpose=batch naar /v1/files, en maak, poll en annuleer ze hier. Elke regel doorloopt gegevensbescherming en residency als een live call. Resultaten komen binnen 24 uur, gefactureerd voor de helft van de live prijs. Mistral, Azure, OpenAI en Qwen. |
| POST / | Anthropic Message Batches: aanmaken, lijst, ophalen, resultaten en annuleren. Uit tenzij je uitrol ze inschakelt. Ze vereisen contentbewaring en draaien alleen op Anthropic-modellen. Anders geven deze routes 404. |
| POST / | Native Anthropic Messages-ingress: richt elke Anthropic-SDK-tool op Sluis, met elk verbonden model. |
| POST / | Lokale tokenschatting voor contextbeheer van de Anthropic SDK. Er wordt niets verzonden. |
| GET / | Native Anthropic-modelontdekking (lijst en ophalen), beantwoord vanuit de catalogus in het proces. Op /v1/models kiest de anthropic-version-header dezelfde vorm. |
| HEAD / | Warm-upprobe voor Anthropic-SDK-clients zoals Claude Code: 200 met een lege body. |
| GET / | OpenAI Realtime-compatibele WebSocket voor live spraak-naar-spraak met vertex/gemini-3.8-live, gehost in de EU-multiregio op Google Vertex AI. Ook beschikbaar op /openai/v1/realtime; de queryparameter model is verplicht. Authenticeer het upgrade-verzoek met Authorization: Bearer of x-api-key. Het spreekt de GA-eventnamen; de bètavormen OpenAI-Beta: realtime=v1, tijdelijke client secrets, browser-subprotocolsleutels en G.711-audio worden niet ondersteund. Server-side tools, sessiehervatting, stemreplicatie en avatar-uitvoer worden bij de setup geweigerd. Tekst wordt beschermd zoals op elk endpoint; audio- en videoframes worden ongeïnspecteerd doorgestuurd. Een sessie eindigt bij een bestedingsplafond van 2 EUR, en de provider sluit een verbinding na ongeveer 10 minuten; maak opnieuw verbinding om door te gaan. Gefactureerd per token tegen de tarieven per modaliteit van het model (tekst, audio, beeld- en videoframes), volgens het gebruiksrapport van de provider. Niet beschikbaar in Sluis Workspace, de Playground of sluis/*-aliassen. De volledige eventlijst staat in de agent skill. |
| GET / | Native Gemini Live-WebSocket (BidiGenerateContent), ook op /ws/google.cloud.aiplatform.v1.LlmBidiService/BidiGenerateContent; de versie in de servicenaam mag v1, v1beta, v1beta1 of v1alpha zijn. Een google-genai-SDK met de gateway-origin als basis-URL verbindt ongewijzigd. Authenticeer het upgrade-verzoek met x-goog-api-key, Authorization: Bearer of x-api-key; de queryparameter ?key= wordt niet geaccepteerd. Frames worden doorgegeven zoals het Gemini Live-protocol ze definieert, en setup.model is gemini-3.8-live. Weigeringen komen binnen als WebSocket-close-frame met de reden als tekst. Hetzelfde model, dezelfde limieten, dezelfde gegevensbescherming en dezelfde facturatie als /v1/realtime. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Elke JSON-body hierboven mag daarnaast de gateway-extensie sluis.remove dragen, die termen noemt die vóór verzending uit de prompt gepseudonimiseerd moeten worden. Ze wordt verwijderd voordat het verzoek de gateway verlaat; zie de Gegevensbeschermingsreferentie.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}
Spraak naar tekst met sprekerherkenning
Zet het model op sluis/transcribe en stuur POST /v1/audio/transcriptions. De gateway voert zijn eigen spraakherkenning uit, zonder uitstroom naar providers.
- Stuur een multipart
filevan maximaal 240 minuten. De taal wordt automatisch herkend. response_formatisjson(standaard),textofverbose_json(segmenten met een spreker).- Gefactureerd tegen €0,02 per minuut audio, per begonnen seconde.
- De DLP-modus van de organisatie geldt voor de transcriptie, zoals bij
sluis/ocr. - Het antwoordt
503waar de uitrol geen transcriptie draait.
# Speech to text with speaker detection, billed €0.02 per minute of audio (per started second).
# model "sluis/transcribe" runs in the gateway's own worker: no provider egress, language detected automatically.
curl https://api.sluis.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F model=sluis/transcribe \
  -F response_format=verbose_json \
  -F file=@meeting.m4a
{
  "task": "transcribe",
  "duration": 94.2,
  "text": "Goedemorgen allemaal.\nGoedemorgen, fijn dat jullie er zijn.",
  "segments": [
    { "id": 0, "start": 0.4, "end": 2.1, "text": "Goedemorgen allemaal.", "speaker": "speaker_1" },
    { "id": 1, "start": 2.6, "end": 5.0, "text": "Goedemorgen, fijn dat jullie er zijn.", "speaker": "speaker_2" }
  ],
  "usage": { "type": "duration", "seconds": 95 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"] }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local router contract (sluis/typed/router) | Behaviour |
|---|---|
| Model ids | sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. For your own questions, use a typesafe/jev-* model with your own TypeSafe key. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. The other rows describe sluis/typed/router only. |
| Availability | Every answer comes from verified model weights, reported as revision. If the router is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. |
| Response | JSON with model, answers, decision and revision (weights SHA256). Each answer has its type, its typed value (choice, score or noul), confidence, probabilities, legend and answer_confidence. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. |
| Data protection | Tenant DLP applies locally to the state: block refuses; tokenize or mask rewrites what the router is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The router reports no token count, so input is estimated at about 4 characters per token over the state it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local router. |
Documenten als invoer
Voeg een pdf-, Word-, afbeeldings- of tekstbestand toe aan een chatverzoek als contentonderdeel "type": "file" met een base64-file_data-data-URL.
Elk gerouteerd model accepteert het. Providers die bestandsonderdelen native begrijpen, ontvangen ze ongewijzigd. Voor elke andere provider zet de gateway het document om vóór het verzenden.
Hoe het model het document ontvangt
- Met een pdf-renderer krijgen modellen met beeldondersteuning elke pdf-pagina als
image_url-onderdeel. Het budget is 48 pagina's per verzoek, gedeeld over alle bijgevoegde documenten, en providerlimieten kunnen gelden. Zonder renderer haalt de fallback van de uitrol de tekst eruit of weigert het verzoek. - Modellen zonder beeldinvoer krijgen de uitleesbare tekst van het document als prompttekst. De scan van gegevensbescherming dekt die dan net als elke andere tekst.
- Langere of zwaardere documenten horen op
/v1/ocr. - De Responses API gebruikt
input_file-onderdelen in plaats van de genestefile-vorm van chat completions. - Sluis kan
file_id-verwijzingen aan providerzijde niet controleren of oplossen. Ze gaan alleen door naar een provider die ze ondersteunt, op je eigen providerkey, met documentcontrole uit. Zet anders de bytes inline alsfile_data.
Gegevensbescherming voor documenten
- Met het beleid
dlp_documentsaan wordt het document geanonimiseerd of geweigerd voordat er iets de gateway verlaat. - Met het beleid uit en een beschermende DLP-modus (
tokenize,maskofblock) worden documenten geweigerd die als niet-controleerbare afbeeldingen zouden reizen. Onderallow_loggaan ze door met een expliciete markering 'niet gescand' in het auditspoor. - Audio-onderdelen (
input_audio) kunnen niet worden gescand.block, of verplichte AI-herkenning met documentinspectie aan, weigert ze met422. Anders dragen zex-sluis-unscanned: audio.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Zet stream: true en het antwoord komt als server-sent events. Elk frame is een chat.completion.chunk-delta, en de stream eindigt met data: [DONE].
Streams worden nooit in de gateway gebufferd: ze lopen er doorheen, en de auditverzegeling en de meting gebeuren ook als de client vroegtijdig ophangt.
Vraag stream_options.include_usage aan en de gateway vraagt de provider om een laatste usage-frame. Stuurt de provider er geen, of wordt de stream afgebroken, dan schat de gateway het verbruik voor de meting.
Wil je zien wat een gestreamde call je organisatie kostte? Stuur dan x-sluis-include-cost: true mee, samen met stream_options.include_usage. Het laatste usage-object bevat dan sluis_cost_eur, zie Kosten van een call.
Bedrock houdt redeneringen apart van het antwoord in reasoning_content en reasoning_signature, ook in gestreamde delta’s. Weigeringen gebruiken finish_reason: content_filter, uitvoerlimieten length, ook bij gedeeltelijke toolaanroepen. Voer geen onvolledige toolargumenten uit. AWS-streaminguitzonderingen worden foutframes zonder gevoelige details.
Keepalive, headers en herstarts
- Na 15 seconden zonder frame schrijft de gateway een SSE-commentaarregel (
: keepalive) tussen de events, zodat proxy's met idle-timeouts de verbinding openhouden terwijl een model nadenkt. SSE-clients negeren die regel. - Streams dragen
Cache-Control: no-cacheenX-Accel-Buffering: no. - Als een gateway-replica herstart, blijft hij open streams tot vijf minuten bedienen. Een stream die daarna nog openstaat, eindigt met een foutevent met code
server_restarting, dus probeer het verzoek opnieuw. - Getokeniseerde streams accepteren losse events tot 4 MiB. Grotere events beëindigen de stream met een fout.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Redeneren
Geef de OpenAI-parameter reasoning_effort (minimal | low | medium | high) mee op elk model dat kan nadenken. Sluis vertaalt hem per provider (het denkniveau van Gemini, de adaptieve denkinspanning van Claude) en laat hem weg waar een model hem zou weigeren, zodat één parameter werkt voor de hele catalogus.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Prompt-caching
Herhaalde promptvoorvoegsels (systeemprompts, tools, gespreksgeschiedenis) kunnen bij de provider worden gecachet om kosten en latentie te verlagen. Sluis vertaalt cache_control-blokken in Anthropic-stijl (optionele TTL van 5m of 1h) en de top-level prompt_cache_key en prompt_cache_retention van OpenAI per provider.
Meerdere grenzen van systeem- of assistant-breakpoints kunnen tijdens de vertaling samenvallen, ook bij gemengde TTL's.
| Provider | Gedrag prompt-cache |
|---|---|
| Anthropic | Expliciete cache_control op systeemblokken, berichtinhoud en tools, inclusief TTL. Reads en writes worden apart gerapporteerd. |
| Bedrock | cache_control wordt vertaald naar Converse cachePoint-blokken in system, messages en toolConfig. |
| OpenAI · Azure | Automatische caching. Na opt-in blijven prompt_cache_key en prompt_cache_retention behouden bij chat en Responses; niet-ondersteunde opties en markers worden verwijderd. |
| Gemini · Vertex | Impliciete Gemini-caching en het gemelde cachegebruik werken; expliciete cachedContent-verwijzingen worden niet ondersteund. Claude op Vertex vertaalt cache_control en TTL zoals Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Automatische caching waar beschikbaar; alle expliciete directives worden verwijderd. Moonshots native usage.cached_tokens wordt herkend. |
| Scaleway | Automatische caching waar beschikbaar; alle expliciete directives worden verwijderd. Reads gebruiken Scaleways officiële EUR-tarief voor gecachte input waar beschikbaar, niet LiteLLM. |
| Nebul | Automatische caching waar beschikbaar; alle expliciete directives worden verwijderd. Reads gebruiken het officiële EUR-tarief voor gecachte input waar beschikbaar. |
| Nebius · nebius-eu | Automatische caching waar beschikbaar; alle expliciete directives worden verwijderd. Officiële liveprijzen gebruiken geen LiteLLM-cachekorting; de LiteLLM-fallback kan een cachetarief leveren als een officiële modelprijs ontbreekt. |
| Custom | Na opt-in door de organisatie gaan directives ongewijzigd door; ondersteuning is het contract van de operator. |
Expliciete promptcaching is opt-in
Expliciete promptcaching is een instelling op organisatieniveau (provider_prompt_cache). Hij staat standaard uit en staat los van contentbewaring door Sluis en exacte antwoordcaching. Zet hem aan in Console › Data protection.
- Gecachete voorvoegsels blijven bij de provider nadat gegevensbescherming van Sluis ze heeft gefilterd.
- Als hij uit staat, verwijdert de gate
prompt_cache_key,prompt_cache_retention,prompt_cache_options,cache_controlenprompt_cache_breakpoint. Hij schakelt de eigen automatische caching van de provider niet uit. - Zonder eigen key voor een provider draaien calls op een Sluis-credential die andere organisaties delen. Bij OpenAI en Azure zet Sluis een van je organisatie afgeleide
prompt_cache_keyin plaats van de jouwe. Bij elke andere provider tonen de gecachete tokens in je verbruik 0. De facturering past nog steeds de echte cachekorting toe.
Facturering en limieten
- Cache-reads en -writes zijn deelverzamelingen van het totaal aantal prompttokens, geen extra invoer. Reads gebruiken het beschikbare cachetarief.
- Anthropic 1h-writes gebruiken het TTL-specifieke tarief als de verbruiksopsplitsing en het tarief beschikbaar zijn. Anders geldt het standaard aanmaaktarief.
- Een ontbrekend cachetarief betekent gewone invoerprijzen, nooit nul facturering.
- Cacheverbruik staat in de auditlade en in Usage & budget.
- Lange prompts worden gefactureerd tegen het long-contexttarief van de provider. Zodra de prompt (gecachete tokens inbegrepen) de drempel van het model overschrijdt, wordt de hele call tegen dat tarief gefactureerd. Het staat onder de prijs in de Models-tabel.
Op een door Sluis beheerde key weigert Sluis een verzoek met 400, voordat er iets wordt verzonden, als het een toeslag kiest die Sluis niet kan meten:
- een
cache_control-ttlanders dan5m, waar de provider die honoreert (Anthropic, Bedrock, Claude op Vertex) - een
service_tieranders danauto,default,flexofstandard_only - de Anthropic long-context-bèta (
context-1m) op een model waarvoor Sluis geen long-contexttarief heeft
Je eigen providerkey stuurt alle drie ongewijzigd door.
Foutcodes
Fouten gebruiken de OpenAI-foutenvelop; de waarde error.type weerspiegelt de HTTP-status, zodat de foutafhandeling van je SDK ongewijzigd blijft werken.
| Code | Wanneer |
|---|---|
| 400 invalid_request_error | Ongeldige requestbody of parameters. |
| 400 invalid_request_error | Model-id zonder providerprefix. Elke aanroepbare id is provider/model, bijvoorbeeld mistral/mistral-large-latest. De melding luidt: model must be provider-prefixed. |
| 400 invalid_request_error | Het verzoek bevat de verwijderde x-sluis-dlp-header. Overrides per verzoek zijn vervangen door optie-overrides per workload: stel ze in via Console › Workloads. |
| 401 authentication_error | Ontbrekende of onbekende API-key. |
| 402 insufficient_quota | Geen actief plan, of het budget is bereikt. Activeer een plan of verhoog het budget. Het verzoek bereikt nooit een provider. |
| 403 permission_error | De key mist toestemming, bijvoorbeeld omdat het model niet op de toegestane lijst van de workload staat. |
| 422 invalid_request_error | Geweigerd vóór het verzenden, bijvoorbeeld omdat gegevensbescherming in blokmodus het verzoek heeft herkend. |
| 422 document_too_large_to_scan | Een document is te groot voor het pad dat het nam: een pagina die op de minimale scanresolutie nog boven de pixellimiet van de render ligt, of een bestand boven de bytelimiet voor tekstextractie. Pagina's in groot formaat (tekeningen op A0 en A1) worden automatisch verkleind. Verklein of splits het document en verstuur opnieuw. |
| 429 rate_limit_error | Ratelimiet bereikt. Afgedwongen in de gateway, dus het verzoek raakt nooit een provider. |
| 403 permission_error | Geblokkeerd door residency-beleid: geen toegestane jurisdictie bedient het verzoek. De body bevat de reden. |
| 403 scope_violation | Geweigerd door de scopebewaking van de workload in blokmodus: de call valt buiten de scope die voor die workload is geschreven. De melding bevat de reden van de bewaking en het verzoek bereikt nooit een provider. |
| 422 malware_detected | Het geüploade bestand kwam overeen met een malwaresignatuur en is geweigerd voordat het werd opgeslagen of verwerkt. De naam van de signatuur wordt nooit teruggegeven. |
| 503 pdf_renderer_unavailable | Een inline pdf moest als paginabeelden worden verzonden omdat het gerouteerde model beeldinvoer leest, maar deze uitrol heeft geen pdf-renderer. Het wordt geweigerd in plaats van beantwoord vanuit uitgelezen tekst, want die zou weglaten wat een tekening of scan toont. |
| 503 malware_scan_unavailable | Het geüploade bestand kon niet op malware worden gescand (scanner uit of traag, of het bestand is groter dan de scanlimiet van 100 MiB), dus het is niet geaccepteerd. Er is niets opgeslagen. Probeer opnieuw met backoff. |
| 503 scope_guard_unavailable | De scopebewaking van de workload staat in blokmodus maar kon geen oordeel vellen, dus de call wordt geweigerd in plaats van doorgelaten. Probeer opnieuw met backoff. |
| 503 auth_unavailable | De gateway kon zijn keystore niet lezen en kon de key dus niet verifiëren. Het is niet bekend dat de key ongeldig is. Probeer opnieuw met backoff en respecteer Retry-After. |
| 504 api_error | De provider antwoordde niet binnen de antwoordtermijn van de workload: standaard 300 seconden, 10 tot 600 als de workload dat instelt, korter als het verzoek x-sluis-upstream-timeout meestuurde. error.sluis.cause is timeout. De gateway heeft de call niet opnieuw afgespeeld, omdat de provider hem mogelijk nog uitvoert. Verkort de prompt of vraag een langere termijn aan voordat je opnieuw verstuurt. |
| 5xx api_error | Upstream-providerstoring na pogingen opnieuw. De circuit breaker stuurt verkeer om ongezonde providers heen. De body bevat de eigen melding van de provider en een error.sluis-object met de oorzaak en elke poging, met de upstreamstatus of transportfout en hoe lang het duurde. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. \"mistral/mistral-large-latest\"",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model not permitted for this API key",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}Anthropic Messages API
Sluis spreekt de Anthropic Messages API native. Richt Claude Code of een Anthropic-SDK op de gateway en roep POST /v1/messages aan. /anthropic/v1/messages is het ondubbelzinnige pad met prefix naar dezelfde handler.
Het verzoek wordt vertaald naar de interne vorm, doorloopt dezelfde pijplijn Inspect, Route, Seal en Meter als elke andere call, en komt terug in het formaat van Anthropic, streaming inbegrepen.
Authenticatie
- Stuur je Sluis-key mee in de
x-api-key-header van Anthropic of in de gebruikelijkeAuthorization: Bearer-header. Beide worden geaccepteerd. - De
anthropic-version-header wordt met elke waarde geaccepteerd en is nooit verplicht. OpGET /v1/modelskiest zijn aanwezigheid de Anthropic-vorm. - Parsen is bewust open: onbekende bodyvelden, onbekende contentblocktypen, onbekende
anthropic-beta-waarden en de?beta=true-query die Claude Code stuurt worden getolereerd, niet geweigerd. - Beta-flags reizen byte voor byte naar upstreams uit de Anthropic-familie en worden elders genegeerd.
Endpoints
| Endpoint | Doel |
|---|---|
| POST / | Messages, gebufferd of streaming. Ondersteunt systeemprompts (string of blokken), tools en toolresultaten (inclusief foutresultaten en afbeeldingen daarin), afbeeldingen, documentblokken, thinking- en redacted_thinking-blokken in de geschiedenis, en cache_control-markeringen op elke cachebare positie. |
| POST / | Lokale tokenschatting voor contextbeheer van de SDK. Er wordt niets verzonden, bewaard of gemeten. |
| GET / | Native modelontdekking in de vorm van Anthropic, beantwoord vanuit de catalogus in het proces. Op het rootpad kiest de anthropic-version-header deze vorm, en zonder header krijg je de OpenAI-vorm. Onder /anthropic geldt hij altijd. De cursors before_id, after_id en limit zijn best effort, en created_at is een vaste placeholder omdat de catalogus geen releasedatum per model heeft. |
| HEAD / | De warm-upprobe die Claude Code vóór een sessie stuurt: alleen HEAD, beantwoord met 200 en een lege body. |
Modelroutering
Het wireformaat beperkt het model nooit: de ingress is een codec, en de model-id bepaalt de route.
- Een kale id zoals
claude-sonnet-5wordt opgelost via de standaardprovider van deze ingress,anthropic, tenzij je organisatie die elders naartoe wijst (bijvoorbeeld naarvertexvoor Claude gehost in de EU). De residency-gate beslist nog steeds of dat doel het verzoek mag bedienen. - Leg een doel expliciet vast met een id met providerprefix, zoals
vertex/claude-opus-4-8. - Of geef een
sluis/*-alias mee. Een Anthropic-SDK-tool draait dan op elke verbonden provider, binnen je beleid.
Streaming
Met "stream": true is het antwoord de volledige eventgrammatica van Anthropic:
message_start, dancontent_block_start,content_block_deltaencontent_block_stopvoor elk blok, danmessage_deltamet cumulatief verbruik (inclusief cache-read- en aanmaaktokens), danmessage_stop.- Tekst komt als
text_delta, toolargumenten alsinput_json_delta, en redenering alsthinking_deltaplussignature_deltawanneer de gerouteerde provider die produceerde. message_startbevat het aantal invoertokens als de provider dat in zijn eerste chunk meldt. Anders begint het op nul, enmessage_deltameldt het bijgewerkte verbruik.- Een
ping-event volgt opmessage_starten herhaalt zich na ongeveer 15 seconden upstreamstilte, zodat een lange denkbeurt nooit de watchdog van een client activeert. - Een fout midden in de stream wordt opnieuw gecodeerd als een
error-event in plaats van een afgebroken stream. stop_sequencebevat de herkende reeks wanneer het antwoord van een provider uit de Anthropic-familie kwam, en is anders null.- Stuur
x-sluis-include-cost: truemee en het verbruik inmessage_deltabevat ooksluis_cost_eur, de prijs van de call voor je organisatie in EUR, plus alleen bij een schattingsluis_cost_estimated: true. Zie Kosten van een call.
# native Anthropic Messages: the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true: the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Fouten
Fouten van de Messages-handlers gebruiken de envelop van Anthropic: een top-level "type": "error" met het fouttype van de leverancier. Dat geldt ook voor weigeringen die nooit een model bereiken, zoals een onbekende key of een blokkade door gegevensbescherming.
De leverancierstypen zijn invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error en overloaded_error.
- Het antwoord bevat een
request-id-header en eenrequest_id-bodyveld, de correlatie-id voor je client. - Waar de call een auditrij opleverde, identificeert de header
x-sluis-request-iddie rij. Een authenticatiefout heeft geen auditrij. - HTTP 5xx-antwoorden die de gateway afhandelt bevatten ook een aparte diagnostische
x-request-id. Een veilige id van de client wordt ook bij andere antwoorden teruggestuurd. Fouten van een proxy vóór de gateway vallen buiten deze garantie. - Weigeringen op gatewayniveau die vóór de handler plaatsvinden, zoals ledger-backpressure of overbelasting, kunnen terugkomen in de OpenAI-foutvorm.
# failures from the Messages handlers are Anthropic-shaped: auth and
# data-protection refusals included
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "`mcp_servers` is not supported: an external MCP server reached from the model would bypass the Sluis tool gate. Register the server with Sluis and call it through the compliance-native MCP gateway (`/v1/mcp`), which audits and meters every tool call."
  },
  "request_id": "req_4c81…"
}
Een niet-lege mcp_servers-array wordt geweigerd met 400 invalid_request_error in plaats van doorgestuurd. Een model dat zelf een externe MCP-server aanroept, zou buiten de Sluis-gate vallen. Registreer de server in de Console en roep zijn tools aan via de MCP-gateway, waar elke uitgevoerde toolcall wordt gecontroleerd, gerouteerd, verzegeld en gemeten.
Compatibiliteitsmatrix
Wat de native ingangen vandaag dekken, endpoint voor endpoint. Deze tabel ís de claim: wat hier niet als ondersteund staat, is roadmap, wordt bewust geweigerd of is een ander productoppervlak, nooit stilzwijgend gesuggereerd.
| Anthropic | Status | Toelichting |
|---|---|---|
| POST / | ✓ native | Gebufferd en streaming, tools, afbeeldingen, documentblokken, thinking-round-trip en promptcache-markeringen. |
| POST / | ✓ lokale schatting | Lokaal beantwoord. Er wordt niets verzonden. |
| GET / | ✓ native | Native lijst- en ophaalvorm uit de catalogus in het proces. Via header onderhandeld op het rootpad, onvoorwaardelijk onder /anthropic. |
| HEAD / | ✓ | De warm-upprobe van Claude Code, alleen HEAD. |
| Message Batches | ✓ opt-in | Beschikbaar als je uitrol het inschakelt: aanmaken, lijst, ophalen, resultaten en annuleren, voor modellen die naar Anthropic oplossen. Anders 404. Gebruik voor andere providers de /v1/batches in OpenAI-vorm. |
| Files | ✗ roadmap | De Files API wordt niet overgebrugd. Inline documentblokken en file_data dekken het gangbare pad. |
| mcp_servers | ✗ geweigerd | Een niet-lege array wordt geweigerd met 400 in plaats van doorgestuurd. Registreer de server en gebruik de Sluis MCP-gateway. |
| Skills · Agents · Admin | ✗ buiten scope | Skills, managed agents en de admin-, verbruiks- en kosten-API's zijn een ander productoppervlak, geen inferentiecompatibiliteit. |
Routing tussen protocollen
Leverancierspecifieke velden blijven behouden zolang het verzoek terechtkomt bij een provider die hetzelfde protocol spreekt. Een Anthropic-verzoek dat door een provider uit de Anthropic-familie wordt bediend, behoudt zijn thinking-blokken, cachemarkeringen, beta-flags en herkende stop_sequence.
Bij routing tussen protocollen worden die velden bij het verzenden weggelaten en nooit bij de ingress geweigerd. De auditrij legt zowel het wireformaat als de opgeloste provider vast, zodat elke achteruitgang is toe te schrijven.
Ondoorzichtige waarden worden nooit herschreven: thinking-signatures en redacted_thinking-payloads worden letterlijk doorgestuurd of helemaal niet. Daarom wordt een geparkeerd thinking-blok dat de scan van gegevensbescherming markeert, weggelaten in plaats van gemaskeerd: een herschreven blok zou een ongeldige signature dragen.