Riferimento API
Autenticazione, endpoint, streaming, reasoning ed errori sulla superficie OpenAI, API native Anthropic e matrice di compatibilità per endpoint.
Autenticazione
Ogni richiesta a /v1/* si autentica con una chiave virtuale nell'header Authorization: Bearer. Crea le chiavi in Workload nella Console.
- Il segreto viene mostrato una sola volta e ne viene memorizzato solo l'hash.
- Una chiave è una credenziale per un workload. Il workload gestisce limiti di frequenza, budget, modelli consentiti e deroghe alle policy. La policy dell'organizzazione continua ad applicarsi.
- Una chiave può avere una scadenza facoltativa. Dopo di essa, la chiave viene rifiutata esattamente come una chiave sconosciuta.
- Un modello che non è nella lista di consentiti non vuota del workload viene rifiutato con un
403 permission_errorsigillato, prima che venga inoltrato alcunché. Il rifiuto stesso finisce nella catena di audit. - Un workload può limitare le sue chiavi a famiglie di endpoint, per esempio chat ed embeddings. Le altre famiglie ricevono un
403 operation_not_allowedsigillato, prima che venga inoltrato alcunché. - Per creare una chiave di produzione serve un indirizzo email verificato.
- Un'eccezione: i link di download firmati e a tempo per i documenti anonimizzati non richiedono alcuna chiave.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the workload's allow-list never dispatches:
# → 403 permission_error, and the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    {
      "id": "mistral/mistral-large-latest",
      "object": "model",
      "created": 1704067200,
      "owned_by": "mistral",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": 0.55,
        "output_eur_per_mtok": 1.65,
        "cached_input_eur_per_mtok": 0.055,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }],
        "eur_per_page": null,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    },
    {
      "id": "sluis/fast",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": "mistral/mistral-large-latest",
      "pricing": { "input_eur_per_mtok": 0.55, "output_eur_per_mtok": 1.65, "cached_input_eur_per_mtok": 0.055, "audio_input_eur_per_mtok": null, "audio_output_eur_per_mtok": null, "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }], "eur_per_page": null, "eur_per_minute": null, "eur_per_image": null, "estimated": false }
    },
    {
      "id": "sluis/auto",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": null,
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": null
    },
    {
      "id": "sluis/ocr",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "ocr",
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": null,
        "output_eur_per_mtok": null,
        "cached_input_eur_per_mtok": null,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [],
        "eur_per_page": 0.01,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    }
  ]
}
Endpoint
Sluis espone la superficie compatibile con OpenAI qui sotto, più i percorsi Anthropic nativi descritti più avanti.
Gli endpoint senza un handler dedicato vengono inoltrati tali e quali al provider instradato, streaming compreso, così gli upstream compatibili con OpenAI mantengono piena fedeltà.
Un browser che apre un percorso che l'API non serve, come l'host API nudo, viene reindirizzato a questa documentazione. I client API ricevono invece un semplice 404.
| Endpoint | Scopo |
|---|---|
| POST / | Chat completions, la superficie principale: instradamento, protezione dei dati, caching, streaming. |
| POST / | Completamenti di testo legacy. |
| POST / | Embeddings. |
| POST / | Classificazione di moderazione. |
| POST / | L'API OpenAI Responses. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | OCR dei documenti (Mistral, oppure completamente locale con il modello sluis/ocr), fatturato per pagina. Con la policy dlp_documents attiva, i documenti inline vengono anonimizzati prima di uscire. |
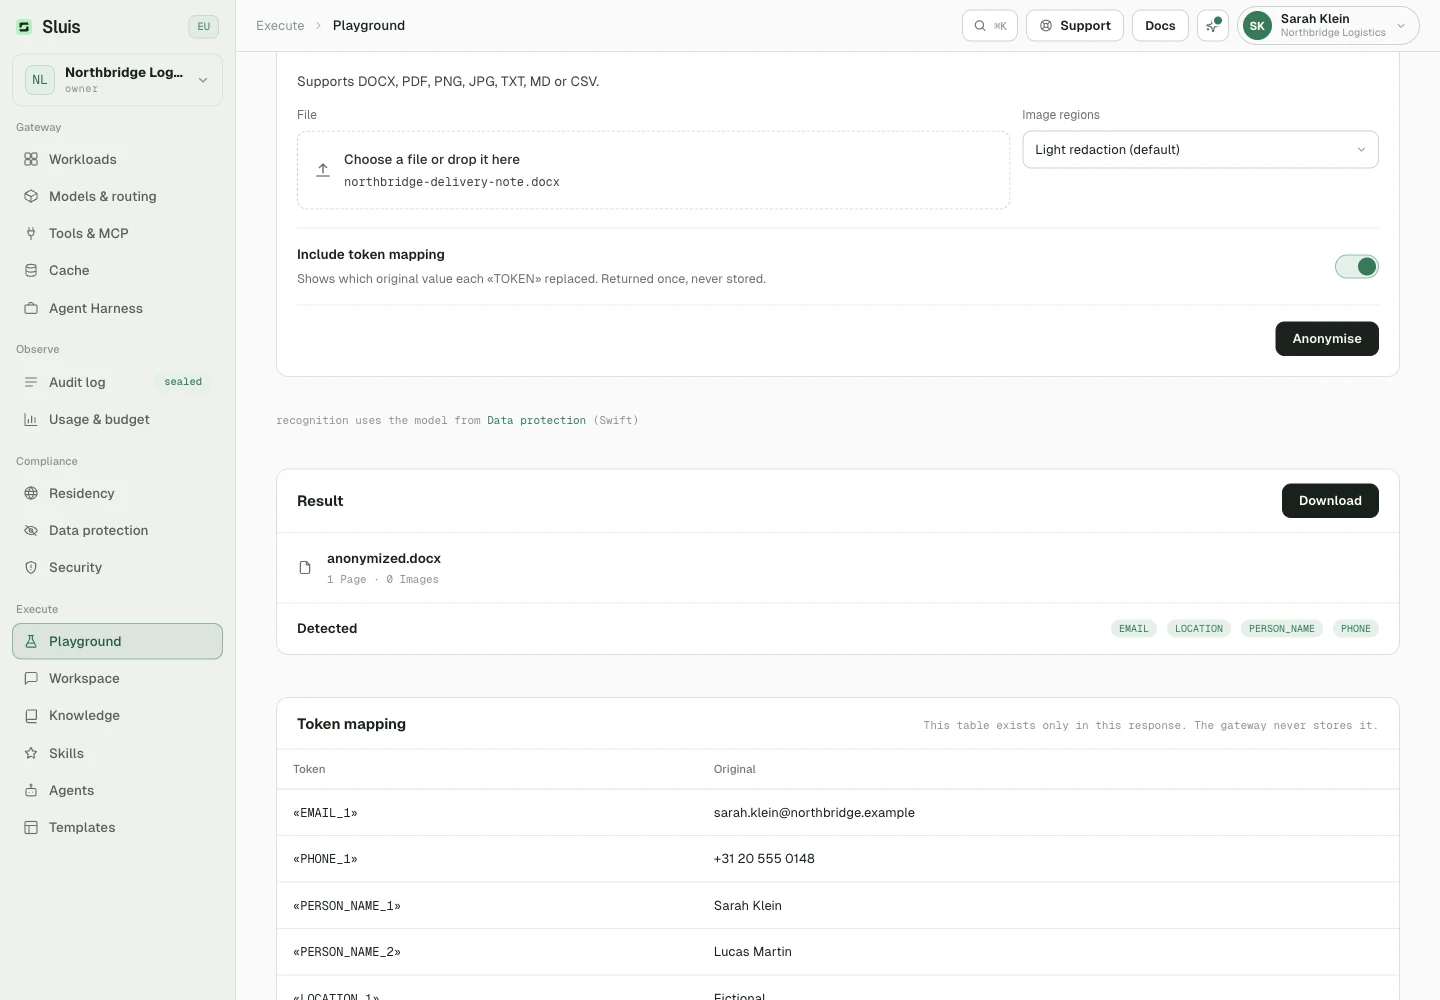
| POST / | Anonimizzazione dei documenti: i dati personali sostituiti da «MERGE_TAG», le immagini sfocate. Fatturata per pagina o immagine. |
| POST / | Job di anonimizzazione asincroni: metti in coda un documento grande, controlla /jobs/{id} e recupera /jobs/{id}/result. Il link di download firmato (/v1/documents/deliverables/{id}) è a tempo e non richiede chiave API. |
| GET / | Modelli consentiti dalla tua policy, credenziali e workload, con tipo, finestra di contesto, capacità, residenza, destinazione dell'alias e prezzo finale di questa organizzazione in EUR, IVA esclusa. |
| GET / | Metadati e prezzo specifico dell'organizzazione per un modello, nello stesso formato della lista. |
| POST / | Trascrizione, traduzione e voce, inoltrate al provider instradato. Con il modello sluis/transcribe, POST /v1/audio/transcriptions esegue il riconoscimento vocale proprio di Sluis con rilevamento dei parlanti. Vedi Voce in testo. |
| POST / | Generazione e modifica di immagini, inoltrate. mistral/image-generation è l'eccezione: Mistral la serve solo tramite il suo connettore agent, quindi il gateway traduce la richiesta OpenAI e risponde con b64_json, fatturata per immagine. |
| POST / | Generazione di video, inoltrata. |
| / | Operazioni sui file, inoltrate con la chiave propria della tua organizzazione (BYOK o provider personalizzato). I file con purpose=batch sono l'eccezione: passano dal gate del gateway e possono usare chiavi gestite. |
| / | Batch in formato OpenAI: carica un file JSONL con purpose=batch su /v1/files, poi crea, controlla e annulla qui. Ogni riga passa protezione dei dati e residenza come una chiamata live. I risultati arrivano entro 24 ore, fatturati a metà del prezzo live. Mistral, Azure, OpenAI e Qwen. |
| POST / | Anthropic Message Batches: create, list, get, results e cancel. Disattivate a meno che la tua installazione non le abiliti. Richiedono la conservazione dei contenuti e girano solo su modelli Anthropic. Altrimenti queste rotte restituiscono 404. |
| POST / | Ingresso nativo Anthropic Messages: punta qualsiasi strumento con SDK Anthropic su Sluis, con qualsiasi modello connesso. |
| POST / | Stima locale dei token per la gestione del contesto degli SDK Anthropic. Non viene inviato nulla. |
| GET / | Individuazione nativa dei modelli Anthropic (list e get), servita dal catalogo in-process. Su /v1/models l'header anthropic-version seleziona la stessa forma. |
| HEAD / | Sonda di riscaldamento per i client SDK Anthropic come Claude Code: 200 con corpo vuoto. |
| GET / | WebSocket compatibile con OpenAI Realtime per la voce dal vivo (speech to speech) con vertex/gemini-3.8-live, ospitato nella multi-regione UE su Google Vertex AI. Disponibile anche su /openai/v1/realtime; il parametro di query model è obbligatorio. Autentica la richiesta di upgrade con Authorization: Bearer o x-api-key. Parla i nomi di evento GA; i formati beta OpenAI-Beta: realtime=v1, i segreti client effimeri, le chiavi via sotto-protocollo del browser e l'audio G.711 non sono supportati. Strumenti lato server, ripresa della sessione, replica della voce e output avatar vengono rifiutati in fase di setup. Il testo è protetto come su ogni endpoint; i frame audio e video vengono inoltrati senza ispezione. Una sessione termina al tetto di spesa di 2 EUR, e il provider chiude una connessione dopo circa 10 minuti; riconnettiti per continuare. Fatturazione per token alle tariffe per modalità del modello (testo, audio, frame immagine e video), dal report di utilizzo del provider. Non disponibile in Sluis Workspace, nel Playground né negli alias sluis/*. L'elenco completo degli eventi è nell'agent skill. |
| GET / | WebSocket Gemini Live nativo (BidiGenerateContent), anche su /ws/google.cloud.aiplatform.v1.LlmBidiService/BidiGenerateContent; la versione nel nome del servizio può essere v1, v1beta, v1beta1 o v1alpha. Un SDK google-genai con l'origine della gateway come URL base si connette senza modifiche. Autentica la richiesta di upgrade con x-goog-api-key, Authorization: Bearer o x-api-key; il parametro di query ?key= non è accettato. I frame vengono inoltrati come li definisce il protocollo Gemini Live, e setup.model è gemini-3.8-live. I rifiuti arrivano come frame di chiusura WebSocket con il motivo in testo. Stesso modello, stessi limiti, stessa protezione dei dati e stessa fatturazione di /v1/realtime. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Ogni body JSON qui sopra può portare anche l'estensione della gateway sluis.remove, che nomina i termini da pseudonimizzare nel prompt prima dell'invio. Viene rimossa prima che la richiesta lasci la gateway; vedi il riferimento Protezione dei dati.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}
Voce in testo con rilevamento dei parlanti
Imposta il modello su sluis/transcribe e invia POST /v1/audio/transcriptions. Il gateway esegue il proprio riconoscimento vocale, senza uscita verso provider.
- Invia un
filemultipart fino a 240 minuti. La lingua viene rilevata automaticamente. response_formatèjson(il default),textoppureverbose_json(segmenti con un parlante).- Fatturato a 0,02 € al minuto di audio, per secondo iniziato.
- La modalità DLP dell'organizzazione si applica alla trascrizione, come per
sluis/ocr. - Risponde
503dove l'installazione non esegue la trascrizione.
# Speech to text with speaker detection, billed €0.02 per minute of audio (per started second).
# model "sluis/transcribe" runs in the gateway's own worker: no provider egress, language detected automatically.
curl https://api.sluis.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F model=sluis/transcribe \
  -F response_format=verbose_json \
  -F file=@meeting.m4a
{
  "task": "transcribe",
  "duration": 94.2,
  "text": "Goedemorgen allemaal.\nGoedemorgen, fijn dat jullie er zijn.",
  "segments": [
    { "id": 0, "start": 0.4, "end": 2.1, "text": "Goedemorgen allemaal.", "speaker": "speaker_1" },
    { "id": 1, "start": 2.6, "end": 5.0, "text": "Goedemorgen, fijn dat jullie er zijn.", "speaker": "speaker_2" }
  ],
  "usage": { "type": "duration", "seconds": 95 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"] }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local router contract (sluis/typed/router) | Behaviour |
|---|---|
| Model ids | sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. For your own questions, use a typesafe/jev-* model with your own TypeSafe key. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. The other rows describe sluis/typed/router only. |
| Availability | Every answer comes from verified model weights, reported as revision. If the router is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. |
| Response | JSON with model, answers, decision and revision (weights SHA256). Each answer has its type, its typed value (choice, score or noul), confidence, probabilities, legend and answer_confidence. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. |
| Data protection | Tenant DLP applies locally to the state: block refuses; tokenize or mask rewrites what the router is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The router reports no token count, so input is estimated at about 4 characters per token over the state it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local router. |
Documenti in input
Allega un file PDF, Word, immagine o di testo semplice a una richiesta chat come parte di contenuto "type": "file" con un data URL base64 in file_data.
Qualsiasi modello instradato lo accetta. I provider che capiscono nativamente le parti file le ricevono invariate. Per tutti gli altri provider il gateway converte il documento prima del dispatch.
Come il modello riceve il documento
- Con un renderer PDF, i modelli con visione ricevono ogni pagina del PDF come parte
image_url. Il budget è di 48 pagine per richiesta, condiviso tra tutti i documenti allegati, e possono valere i limiti del provider. Senza renderer, il fallback dell'installazione estrae il testo oppure rifiuta. - I modelli senza input immagine ricevono il testo estraibile del documento come testo del prompt. La scansione di protezione dei dati lo copre poi come ogni altro testo.
- I documenti più lunghi o più pesanti vanno su
/v1/ocr. - La Responses API usa parti
input_fileinvece della formafileannidata delle chat completions. - Sluis non può ispezionare né risolvere i riferimenti
file_idlato provider. Passano solo a un provider che li supporta, con la tua chiave provider e con l'ispezione dei documenti disattivata. Altrimenti inserisci i byte inline comefile_data.
Protezione dei dati per i documenti
- Con la policy
dlp_documentsattiva, il documento viene anonimizzato o rifiutato prima che qualcosa lasci il gateway. - Se è disattivata e la modalità DLP è protettiva (
tokenize,maskoblock), i documenti che viaggerebbero come immagini non ispezionabili vengono rifiutati. Conallow_logpassano con un marcatore esplicito di non analizzato nel registro di audit. - Le parti audio (
input_audio) non possono essere analizzate.blocko il riconoscimento IA obbligatorio con ispezione documenti attiva le rifiuta con422. Altrimenti riportanox-sluis-unscanned: audio.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Imposta stream: true e la risposta arriva come server-sent events. Ogni frame è un delta chat.completion.chunk e lo stream termina con data: [DONE].
Gli stream non vengono mai bufferizzati nel gateway: lo attraversano in tee, e il sigillo di audit e la misurazione avvengono anche se il client si disconnette in anticipo.
Chiedi stream_options.include_usage e il gateway richiede al provider un frame finale di consumo. Se il provider non ne invia nessuno, o lo stream viene interrotto, il gateway stima il consumo per la misurazione.
Vuoi vedere quanto è costata alla tua organizzazione una chiamata in streaming? Invia x-sluis-include-cost: true insieme a stream_options.include_usage. L'oggetto usage finale contiene allora sluis_cost_eur, vedi Costo di una chiamata.
Bedrock separa il ragionamento dalla risposta in reasoning_content e reasoning_signature, anche nei delta dello stream. I rifiuti usano finish_reason: content_filter, i limiti di output length, anche con chiamate parziali agli strumenti. Non eseguire argomenti incompleti degli strumenti. Le eccezioni di streaming AWS diventano frame di errore senza dettagli sensibili.
Keepalive, header e riavvii
- Dopo 15 secondi senza frame il gateway scrive una riga di commento SSE (
: keepalive) tra gli eventi, così i proxy con timeout di inattività tengono aperta la connessione mentre un modello ragiona. I client SSE la ignorano. - Gli stream portano
Cache-Control: no-cacheeX-Accel-Buffering: no. - Quando una replica del gateway si riavvia, continua a servire gli stream aperti fino a cinque minuti. Uno stream ancora aperto dopo quel tempo termina con un evento di errore con codice
server_restarting: ripeti la richiesta. - Gli stream tokenizzati accettano singoli eventi fino a 4 MiB. Eventi più grandi chiudono lo stream con un errore.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Ragionamento
Passa il parametro OpenAI reasoning_effort (minimal | low | medium | high) su qualsiasi modello capace di ragionare. Sluis lo traduce per ciascun provider (il livello di thinking di Gemini, l'effort di adaptive thinking di Claude) e lo omette dove un modello lo rifiuterebbe, così un solo parametro funziona su tutto il catalogo.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Cache dei prompt
I prefissi di prompt ripetuti (prompt di sistema, strumenti, cronologia della conversazione) possono essere messi in cache presso il provider per ridurre costi e latenza. Sluis traduce per ciascun provider i blocchi cache_control in stile Anthropic (TTL facoltativo di 5m o 1h) e i campi di primo livello OpenAI prompt_cache_key e prompt_cache_retention.
Più confini di breakpoint system o assistant possono fondersi nella traduzione, anche con TTL diversi.
| Provider | Comportamento della cache dei prompt |
|---|---|
| Anthropic | cache_control esplicito su blocchi di sistema, contenuto e strumenti, TTL incluso. Letture e scritture sono riportate separatamente. |
| Bedrock | cache_control diventa blocchi cachePoint di Converse in system, messages e toolConfig. |
| OpenAI · Azure | Cache automatica. Dopo l'attivazione, prompt_cache_key e prompt_cache_retention restano su chat e Responses; opzioni e marcatori non supportati vengono rimossi. |
| Gemini · Vertex | Funzionano la cache implicita Gemini e i relativi consumi; i riferimenti espliciti cachedContent non sono supportati. Claude su Vertex traduce cache_control e TTL come Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Cache automatica se disponibile; tutte le direttive esplicite vengono rimosse. Il campo nativo usage.cached_tokens di Moonshot è riconosciuto. |
| Scaleway | Cache automatica se disponibile; tutte le direttive esplicite vengono rimosse. Le letture usano la tariffa ufficiale Scaleway in EUR per input in cache, se disponibile, non LiteLLM. |
| Nebul | Cache automatica se disponibile; tutte le direttive esplicite vengono rimosse. Le letture usano la tariffa ufficiale in EUR per input in cache, se disponibile. |
| Nebius · nebius-eu | Cache automatica se disponibile; tutte le direttive esplicite vengono rimosse. I prezzi ufficiali non usano sconti cache LiteLLM; il fallback LiteLLM può fornire una tariffa cache in assenza del prezzo ufficiale del modello. |
| Custom | Dopo l'attivazione dell'organizzazione, le direttive passano inalterate; il supporto dipende dal contratto dell'operatore. |
La cache esplicita dei prompt è opt-in
La cache esplicita dei prompt è un'impostazione a livello di organizzazione (provider_prompt_cache). È disattivata per default e indipendente dalla conservazione dei contenuti Sluis e dalla cache delle risposte esatte. Attivala in Console › Protezione dei dati.
- I prefissi in cache restano presso il provider dopo che la protezione dei dati Sluis li ha filtrati.
- Quando è disattivata, il gate rimuove
prompt_cache_key,prompt_cache_retention,prompt_cache_options,cache_controleprompt_cache_breakpoint. Non disattiva la cache automatica propria del provider. - Senza una tua chiave per un provider, le chiamate usano una credenziale Sluis condivisa con altre organizzazioni. Su OpenAI e Azure, Sluis imposta un
prompt_cache_keyderivato dalla tua organizzazione al posto del tuo. Su ogni altro provider, i conteggi dei token in cache nei tuoi consumi mostrano 0. La fatturazione applica comunque il reale sconto cache.
Fatturazione e limiti
- Letture e scritture della cache sono sottoinsiemi dei token di prompt totali, non input aggiuntivo. Le letture usano la tariffa cache disponibile.
- Le scritture Anthropic 1h usano la tariffa specifica per TTL quando sono disponibili dettaglio dei consumi e tariffa. Altrimenti si applica la tariffa di creazione predefinita.
- Una tariffa cache mancante significa prezzo di input ordinario, mai fatturazione zero.
- I consumi della cache compaiono nel pannello di audit e in Utilizzo e budget.
- I prompt lunghi sono fatturati alla tariffa a contesto lungo del provider. Quando il prompt (token in cache compresi) supera la soglia del modello, l'intera chiamata è fatturata a quella tariffa. Viene mostrata sotto il prezzo nella tabella dei modelli.
Con una chiave gestita da Sluis, Sluis rifiuta con 400 una richiesta, prima di inviare qualsiasi cosa, quando seleziona un sovrapprezzo che Sluis non può misurare:
- un
cache_controlconttldiverso da5m, dove il provider lo rispetta (Anthropic, Bedrock, Claude su Vertex) - un
service_tierdiverso daauto,default,flexostandard_only - la beta Anthropic a contesto lungo (
context-1m) su un modello per cui Sluis non ha una tariffa a contesto lungo
Con la tua chiave provider, tutti e tre vengono inoltrati invariati.
Codici di errore
Gli errori usano l'envelope di errore di OpenAI; il valore error.type rispecchia lo stato HTTP, così la gestione degli errori del tuo SDK continua a funzionare invariata.
| Codice | Quando |
|---|---|
| 400 invalid_request_error | Corpo o parametri della richiesta malformati. |
| 400 invalid_request_error | All'id del modello manca il prefisso del provider. Ogni id richiamabile è provider/model, per esempio mistral/mistral-large-latest. Il messaggio dice: model must be provider-prefixed. |
| 400 invalid_request_error | La richiesta contiene l'header rimosso x-sluis-dlp. Le deroghe per singola richiesta sono state sostituite dalle deroghe di opzione del workload: configurale in Console › Workload. |
| 401 authentication_error | Chiave API mancante o sconosciuta. |
| 402 insufficient_quota | Nessun piano attivo, oppure il budget è esaurito. Attiva un piano o aumenta il budget. La richiesta non raggiunge mai un provider. |
| 403 permission_error | La chiave non ha il permesso, per esempio il modello non è nella lista di consentiti del workload. |
| 422 invalid_request_error | Rifiutata prima del dispatch, per esempio la protezione dei dati in modalità block ha riconosciuto la richiesta. |
| 422 document_too_large_to_scan | Un documento è troppo grande per il percorso che ha preso: una pagina ancora oltre il limite di pixel di rendering alla risoluzione minima di scansione, oppure un file oltre il limite di byte per l'estrazione del testo. Le pagine di grande formato (disegni A0 e A1) vengono ridotte automaticamente. Riduci o dividi il documento e reinvia. |
| 429 rate_limit_error | Limite di frequenza raggiunto. Applicato al gateway, quindi la richiesta non arriva mai a un provider. |
| 403 permission_error | Bloccata dalla policy di residenza: nessuna giurisdizione consentita serve la richiesta. Il corpo include il motivo. |
| 403 scope_violation | Rifiutata dal controllo del perimetro del workload in modalità block: la chiamata esce dal perimetro scritto per quel workload. Il messaggio riporta il motivo del controllo e la richiesta non raggiunge mai un provider. |
| 422 malware_detected | Il file caricato corrispondeva a una firma di malware ed è stato rifiutato prima di essere salvato o analizzato. Il nome della firma non viene mai restituito. |
| 503 pdf_renderer_unavailable | Un PDF inline doveva essere inviato come immagini delle pagine perché il modello instradato legge input immagine, ma questa installazione non ha un renderer PDF. Viene rifiutato invece di rispondere dal testo estratto, che scarterebbe ciò che mostra un disegno o una scansione. |
| 503 malware_scan_unavailable | Il file caricato non ha potuto essere analizzato per malware (scanner non disponibile o lento, oppure il file supera il limite di scansione di 100 MiB), quindi non è stato accettato. Non è stato salvato nulla. Riprova con backoff. |
| 503 scope_guard_unavailable | Il controllo del perimetro del workload è in modalità block ma non ha raggiunto un verdetto, quindi la chiamata viene rifiutata invece di essere lasciata passare. Riprova con backoff. |
| 503 auth_unavailable | Il gateway non ha potuto leggere il proprio archivio delle chiavi, quindi non ha potuto verificare la chiave. Non si sa che la chiave non sia valida. Riprova con backoff e rispetta Retry-After. |
| 504 api_error | Il provider non ha risposto entro il timeout di risposta del workload: 300 secondi per default, da 10 a 600 se il workload lo imposta, meno se la richiesta ha inviato x-sluis-upstream-timeout. error.sluis.cause è timeout. Il gateway non ha ripetuto la chiamata, perché il provider potrebbe ancora eseguirla. Accorcia il prompt o chiedi un timeout più lungo prima di reinviare. |
| 5xx api_error | Errore del provider upstream dopo i tentativi. Il circuit breaker devia il traffico dai provider non sani. Il corpo riporta il messaggio del provider stesso e un oggetto error.sluis che indica la causa e ogni tentativo, con il suo stato upstream o errore di trasporto e la durata. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. \"mistral/mistral-large-latest\"",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model not permitted for this API key",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}Anthropic Messages API
Sluis parla nativamente l'API Anthropic Messages. Punta Claude Code o qualsiasi SDK Anthropic sul gateway e chiama POST /v1/messages. /anthropic/v1/messages è il percorso con prefisso, non ambiguo, verso lo stesso handler.
La richiesta viene tradotta nella forma interna, passa dalla stessa pipeline Inspect, Route, Seal e Meter di ogni altra chiamata e torna nel formato Anthropic, streaming compreso.
Autenticazione
- Invia la tua chiave Sluis nell'header
x-api-keydi Anthropic oppure nel solito headerAuthorization: Bearer. Entrambi sono accettati. - L'header
anthropic-versionè accettato con qualsiasi valore e non è mai obbligatorio. SuGET /v1/modelsla sua presenza seleziona la forma Anthropic. - Il parsing è volutamente aperto: campi del corpo sconosciuti, tipi di blocco di contenuto sconosciuti, valori
anthropic-betasconosciuti e la query?beta=trueche Claude Code invia sono tollerati, non rifiutati. - I flag beta viaggiano byte per byte verso gli upstream della famiglia Anthropic e sono ignorati ovunque altrove.
Endpoint
| Endpoint | Scopo |
|---|---|
| POST / | Messages, in buffer o in streaming. Supporta prompt di sistema (stringa o blocchi), strumenti e risultati degli strumenti (compresi risultati di errore e immagini al loro interno), immagini, blocchi documento, blocchi thinking e redacted_thinking nella cronologia e marcatori cache_control in ogni posizione memorizzabile in cache. |
| POST / | Stima locale dei token per la gestione del contesto degli SDK. Non viene inviato, conservato né misurato nulla. |
| GET / | Individuazione nativa dei modelli nella forma Anthropic, servita dal catalogo in-process. Sul percorso radice l'header anthropic-version seleziona questa forma e senza di esso ottieni la forma OpenAI. Sotto /anthropic si applica sempre. I cursori before_id, after_id e limit sono best effort e created_at è un segnaposto fisso perché il catalogo non ha una data di rilascio per modello. |
| HEAD / | La sonda di riscaldamento che Claude Code invia prima di una sessione: solo HEAD, con risposta 200 e corpo vuoto. |
Instradamento del modello
Il formato di trasporto non limita mai il modello: l'ingresso è un codec e l'id del modello decide la rotta.
- Un id semplice come
claude-sonnet-5si risolve tramite il provider predefinito di questo ingresso,anthropic, a meno che la tua organizzazione non lo punti altrove (per esempio avertexper Claude ospitato nell'UE). Il gate di residenza decide comunque se quel target può servire la richiesta. - Fissa un target esplicitamente con un id con prefisso del provider, come
vertex/claude-opus-4-8. - Oppure passa un alias
sluis/*. Uno strumento con SDK Anthropic gira allora su qualsiasi provider connesso, dentro la tua policy.
Streaming
Con "stream": true la risposta usa la grammatica completa degli eventi Anthropic:
message_start, poicontent_block_start,content_block_deltaecontent_block_stopper ogni blocco, poimessage_deltacon il consumo cumulativo (compresi i token di lettura e creazione della cache), poimessage_stop.- Il testo arriva come
text_delta, gli argomenti degli strumenti comeinput_json_deltae il ragionamento comethinking_deltapiùsignature_deltaquando il provider instradato l'ha prodotto. message_startporta il conteggio dei token di input quando il provider lo riporta nel primo chunk. Altrimenti parte da zero emessage_deltariporta il consumo aggiornato.- Un evento
pingseguemessage_starte si ripete dopo circa 15 secondi di silenzio dell'upstream, così un lungo turno di ragionamento non fa mai scattare il watchdog di un client. - Un errore a metà stream viene ricodificato come evento
errorinvece di uno stream troncato. stop_sequenceporta la sequenza corrispondente quando la risposta viene da un provider della famiglia Anthropic, ed è null altrimenti.- Invia
x-sluis-include-cost: truee l'uso inmessage_deltacontiene anchesluis_cost_eur, il prezzo della chiamata per la tua organizzazione in EUR, piùsluis_cost_estimated: truesolo in caso di stima. Vedi Costo di una chiamata.
# native Anthropic Messages: the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true: the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Errori
Gli errori degli handler Messages usano l'envelope di Anthropic: un "type": "error" di primo livello con il tipo di errore del produttore. Questo include i rifiuti che non raggiungono mai un modello, come una chiave sconosciuta o un blocco della protezione dei dati.
I tipi del produttore sono invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error e overloaded_error.
- La risposta porta un header
request-ide un camporequest_idnel corpo, l'id di correlazione per il tuo client. - Dove la chiamata ha prodotto una riga di audit, l'header
x-sluis-request-ididentifica quella riga. Un errore di autenticazione non ha riga di audit. - Le risposte HTTP 5xx gestite dal gateway portano anche un
x-request-iddiagnostico distinto. Un id sicuro fornito dal client viene restituito anche nelle altre risposte. Gli errori generati da un proxy prima del gateway non sono coperti. - I rifiuti a livello di gateway che avvengono prima dell'handler, come la backpressure del ledger o il sovraccarico, possono tornare nella forma di errore OpenAI.
# failures from the Messages handlers are Anthropic-shaped: auth and
# data-protection refusals included
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "`mcp_servers` is not supported: an external MCP server reached from the model would bypass the Sluis tool gate. Register the server with Sluis and call it through the compliance-native MCP gateway (`/v1/mcp`), which audits and meters every tool call."
  },
  "request_id": "req_4c81…"
}
Un array mcp_servers non vuoto viene rifiutato con 400 invalid_request_error invece di essere inoltrato. Un modello che chiama da sé un server MCP esterno starebbe fuori dal gate Sluis. Registra invece il server nella Console e chiama i suoi strumenti tramite il gateway MCP, dove ogni chiamata di strumento eseguita viene ispezionata, instradata, sigillata e misurata.
Matrice di compatibilità
Ciò che gli ingressi nativi coprono oggi, endpoint per endpoint. Questa tabella è la dichiarazione: quello che qui non risulta supportato è in roadmap, rifiutato di proposito o appartiene a un'altra superficie di prodotto, mai sottinteso.
| Anthropic | Stato | Note |
|---|---|---|
| POST / | ✓ nativo | In buffer e in streaming, strumenti, immagini, blocchi documento, round-trip del thinking e marcatori di cache dei prompt. |
| POST / | ✓ stima locale | Risposta locale. Non viene inviato nulla. |
| GET / | ✓ nativo | Forma nativa di list e get dal catalogo in-process. Negoziata dall'header sul percorso radice, incondizionata sotto /anthropic. |
| HEAD / | ✓ | La sonda di riscaldamento di Claude Code, solo HEAD. |
| Message Batches | ✓ opt-in | Disponibili quando la tua installazione le abilita: create, list, get, results e cancel, per i modelli che si risolvono su Anthropic. Altrimenti 404. Per gli altri provider usa /v1/batches in formato OpenAI. |
| Files | ✗ roadmap | L'API Files non è collegata. I blocchi documento inline e file_data coprono il percorso comune. |
| mcp_servers | ✗ rifiutato | Un array non vuoto viene rifiutato con 400 invece di essere inoltrato. Registra il server e usa il gateway MCP di Sluis. |
| Skills · Agents · Admin | ✗ fuori perimetro | Skills, agenti gestiti e le API di amministrazione, uso e costi sono un'altra superficie di prodotto, non compatibilità di inferenza. |
Instradamento tra protocolli
I campi specifici del produttore sopravvivono finché la richiesta atterra su un provider che parla lo stesso protocollo. Una richiesta Anthropic servita da un provider della famiglia Anthropic conserva i blocchi thinking, i marcatori di cache, i flag beta e la stop_sequence corrispondente.
Instradati tra protocolli diversi, quei campi cadono al dispatch e non vengono mai rifiutati all'ingresso. La riga di audit registra sia il formato di trasporto sia il provider risolto, così ogni perdita è attribuibile.
I valori opachi non vengono mai riscritti: le firme del thinking e i payload redacted_thinking sono inoltrati alla lettera o non del tutto. È anche il motivo per cui un blocco thinking parcheggiato che la scansione di protezione dei dati segnala viene scartato invece che mascherato: un blocco riscritto porterebbe una firma non valida.