Protezione dei dati
Modalità di rilevamento, 61 rilevatori, rilevamento delle entità con modelli selezionabili, scansione di sicurezza, avviso al modello e conservazione.
La protezione dei dati gira su ogni richiesta prima dell’inoltro. La modalità predefinita è tokenize: ogni valore rilevato senza un’eccezione corrispondente viene sostituito da un token tipizzato stabile come «EMAIL_1».
I valori protetti raggiungono il provider solo come token, e la risposta viene ripristinata ai valori reali sulla via del ritorno verso di te, in streaming o no.
La mappa dei token vive in memoria per la durata della richiesta e non viene mai conservata. La pseudonimizzazione è a senso unico: protegge ciò che invii.
In Sluis Workspace, i risultati pubblici della ricerca web e l’output del modello prodotto prima nello stesso turno non vengono tokenizzati di nuovo. Un valore già tokenizzato nella conversazione resta sostituito dal suo token, e il registro di audit indica quando è successo.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives: only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back: restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Quattro modalità decidono cosa succede a un valore rilevato:
tokenize(la predefinita) lo sostituisce con un token reversibile.masklo riscrive in modo irreversibile.blockrifiuta la richiesta con422.allow_loglo lascia passare segnalando la riga di audit.
61 rilevatori integrati sono inclusi da subito: 29 per i dati personali, dal numero di Social Security USA agli identificativi nazionali validati con le regole di checksum, data o formato di ciascun paese, e 32 per segreti e credenziali. Ciascuno è attivabile per organizzazione. I termini personalizzati (testo semplice o regex) coprono qualsiasi cosa specifica della tua attività, e l’etichetta di un termine personalizzato può avere fino a 32 caratteri:
Eccezioni per pattern
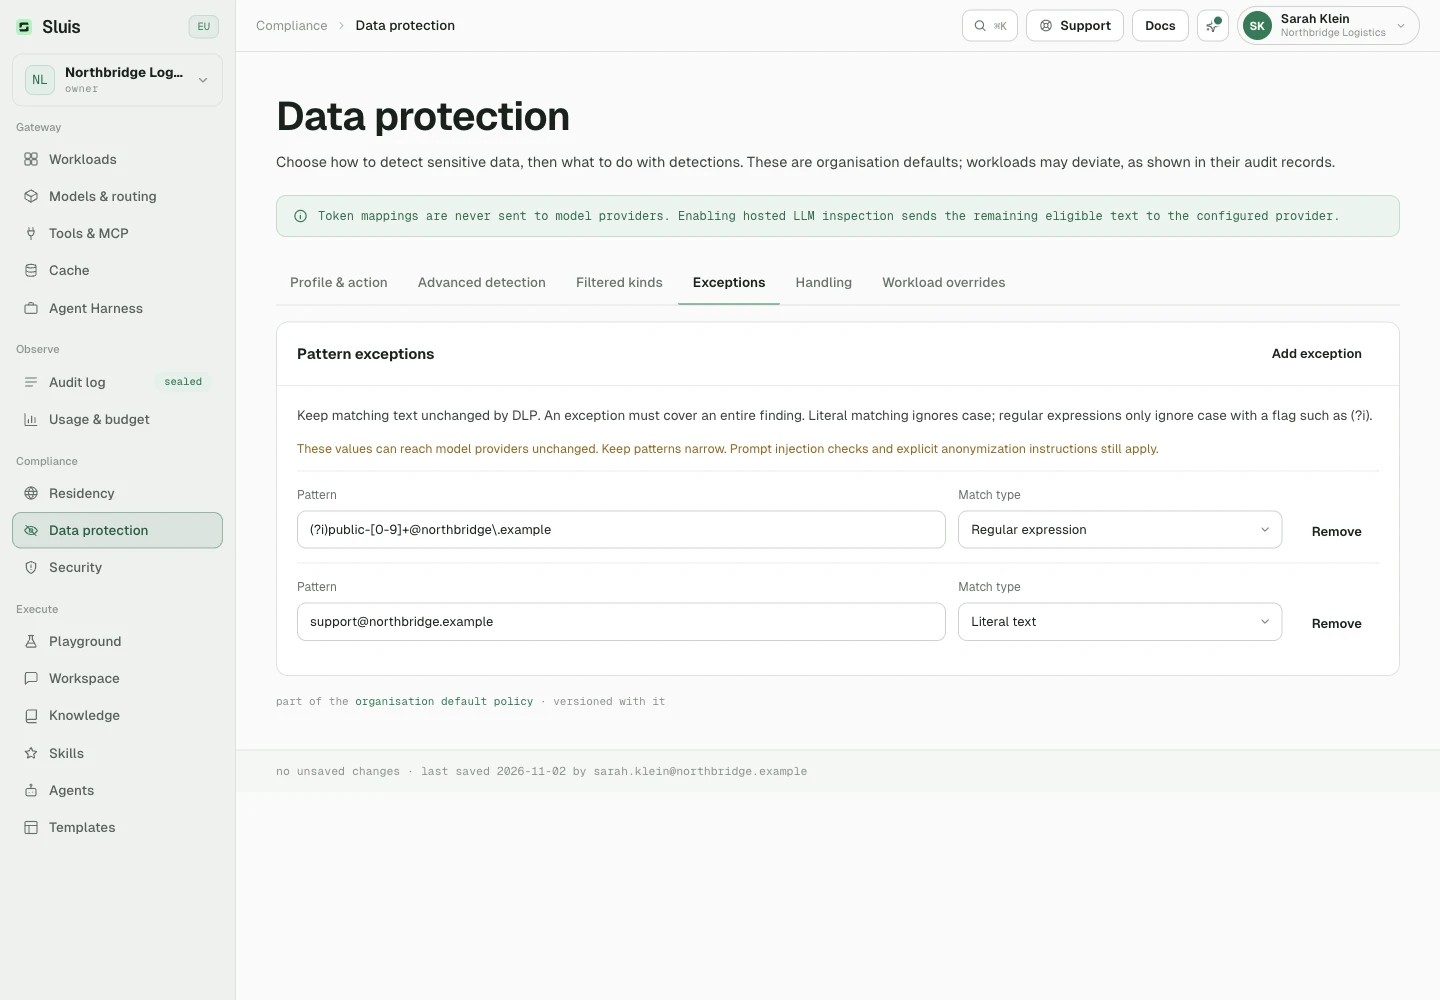
In Console › Protezione dati › Eccezioni, aggiungi testo letterale o un’espressione regolare per i valori che vuoi lasciare invariati, come la casella pubblica support@northbridge.example.
- I pattern letterali ignorano maiuscole e minuscole, anche per le lettere Unicode.
- Le espressioni regolari usano la sintassi Rust regex e distinguono maiuscole e minuscole, a meno che tu non aggiunga
(?i). - Una singola corrispondenza dell’eccezione nel testo originale deve contenere l’intero valore rilevato. Una corrispondenza parziale non basta; corrispondenze distinte, adiacenti o sovrapposte non vengono mai unite.
Usa pattern circoscritti. Un valore escluso non viene pseudonimizzato, mascherato né usato per bloccare la richiesta, quindi il suo testo originale può raggiungere il provider del modello. Gli altri valori rilevati restano protetti.
Le eccezioni si applicano a rilevatori integrati e personalizzati, nomi, dizionari e riconoscimento di entità locale o ospitato, anche nel testo protetto di documenti ed embedding. Non disattivano la scansione delle prompt injection né gli altri controlli di sicurezza. I termini da rimuovere esplicitamente tramite sluis.remove o una richiesta di documento hanno sempre la precedenza.
Rilevazione entità
Persone, organizzazioni e luoghi sono difficili da rilevare solo con pattern. Sluis combina più livelli:
- euristiche di contesto
- correlazione email
- rubrica dei nomi del tenant
- dizionari inclusi
- NER (riconoscimento di entità nominate) opzionale
Il modello NER opera come sidecar interno alla rete, quindi il testo resta nel perimetro dell’installazione. Questi livelli analizzano anche il testo estratto dai documenti e tramite OCR quando la protezione dei documenti è attiva.
- Con il NER attivo, una richiesta può nominare fino a 100.000 entità distinte e 6,4 milioni di caratteri di testo. Oltre questo limite la scansione conta come incompleta.
- Un nome che il modello rileva una volta viene sostituito ovunque ricompaia nella richiesta: la stessa parola intera, con le stesse maiuscole e lo stesso token, anche nei messaggi in cui il modello non l’ha segnalato.
- Le parole generiche isolate e gli acronimi brevi coprono solo il punto in cui il modello li ha segnalati.
Dizionario dei nomi
Il dizionario dei nomi è la controparte deterministica del NER: nomi propri e cognomi compilati da dati aperti della pubblica amministrazione in un dizionario fornito dentro il gateway.
- Coglie i nomi completi e i nomi preceduti da un titolo onorifico, senza latenza aggiunta e senza che nulla lasci il tuo perimetro.
- I nomi che sono anche parole comuni vengono colti solo con un contesto di forma nominale.
- I nomi rari restano compito della rubrica o del NER.
Modelli NER selezionabili
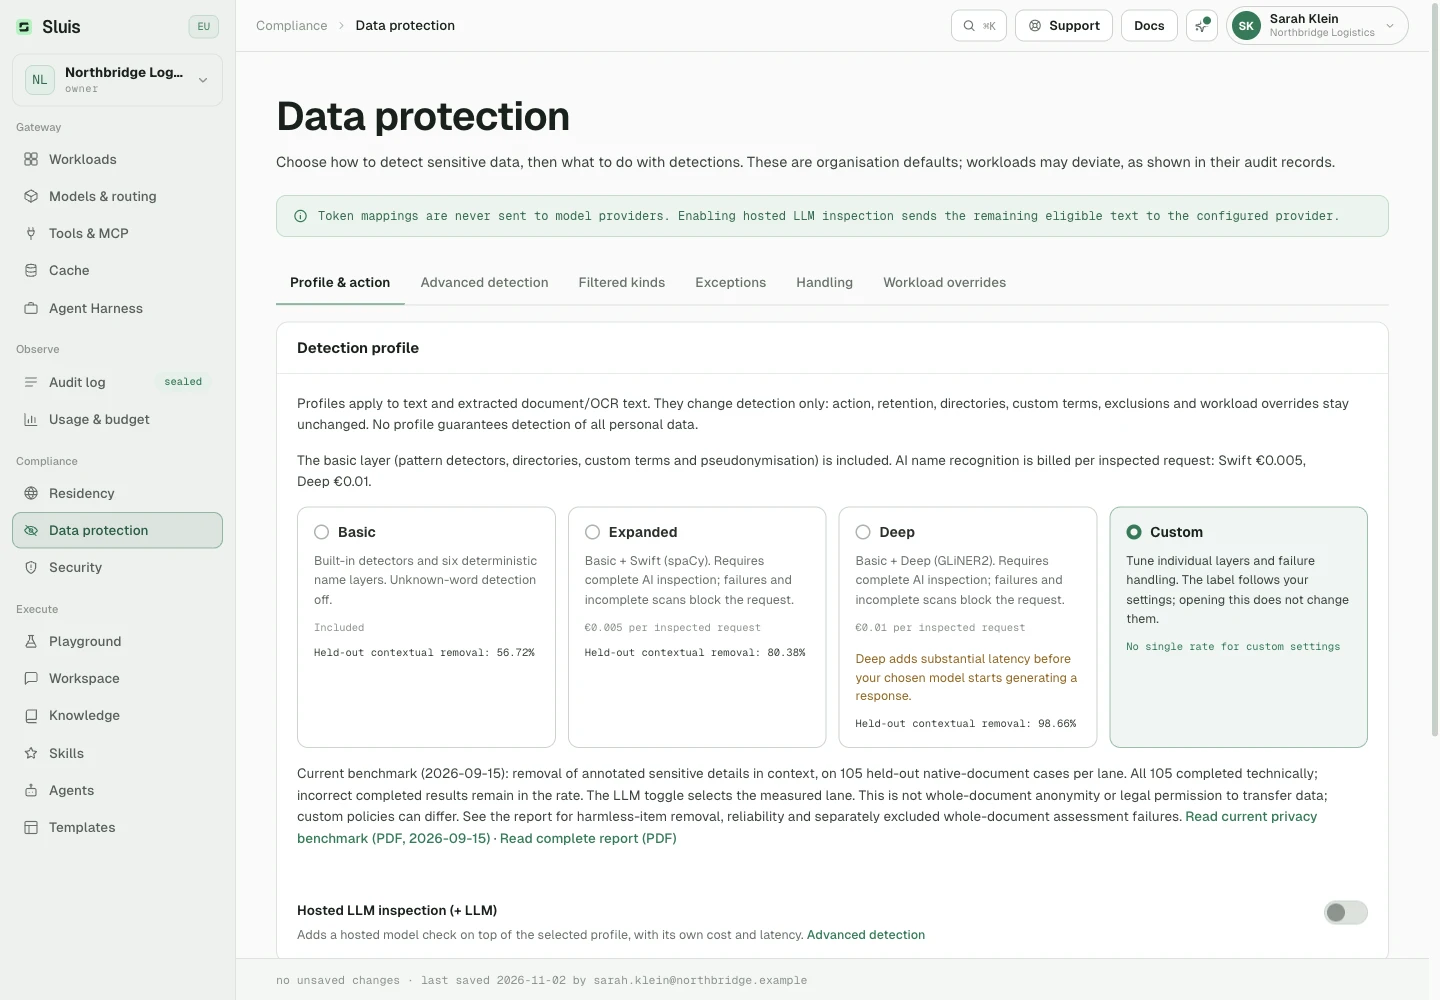
Scegli Base, Esteso o Approfondito in Protezione dei dati.
- Base è il valore predefinito delle nuove organizzazioni. Usa rilevatori integrati e sei livelli deterministici dei nomi, senza chiamate a un modello.
- Esteso aggiunge Swift (spaCy).
- Approfondito aggiunge invece GLiNER2-PII. Richiede più tempo di elaborazione, senza garantire un richiamo superiore.
- Personalizzato permette regolazioni individuali.
Entrambi i profili con modello richiedono un’ispezione completa e bloccano errori del modello o scansioni incomplete.
- Policy esistenti, esclusioni, rubriche e deroghe dei workload restano invariate.
- Il rilevamento delle parole sconosciute resta disattivato in tutti e tre i profili.
- Un workload può scegliere un modello NER disponibile anche se l’organizzazione lo ha disattivato per impostazione predefinita.
Fatturazione
- Il riconoscimento dei nomi con IA è fatturato una volta per ogni richiesta del cliente che ispeziona: 0,005 EUR con Swift (Esteso), 0,01 EUR con GLiNER2 (Approfondito). Base è incluso.
- Le chiamate successive che Sluis effettua nell’ambito di quella richiesta non vengono fatturate di nuovo, e un’ispezione incompleta non costa nulla.
- Ogni addebito è una ricevuta di audit collegata che conta nei tuoi budget.
Latenza
- Approfondito aggiunge una latenza significativa prima che il modello scelto inizi a generare una risposta.
- Il tempo di scansione di Swift e GLiNER2 cresce con la lunghezza del testo, il numero di messaggi e il carico.
- Non esiste un limite di tempo: sotto carico una richiesta attende in coda invece di essere rifiutata, e termina solo se ti disconnetti. Non è una garanzia di velocità.
- L’ispezione LLM ospitata facoltativa aggiunge un’attesa separata prima della generazione della risposta, in base alla lunghezza del testo, al carico del provider e ai nuovi tentativi.
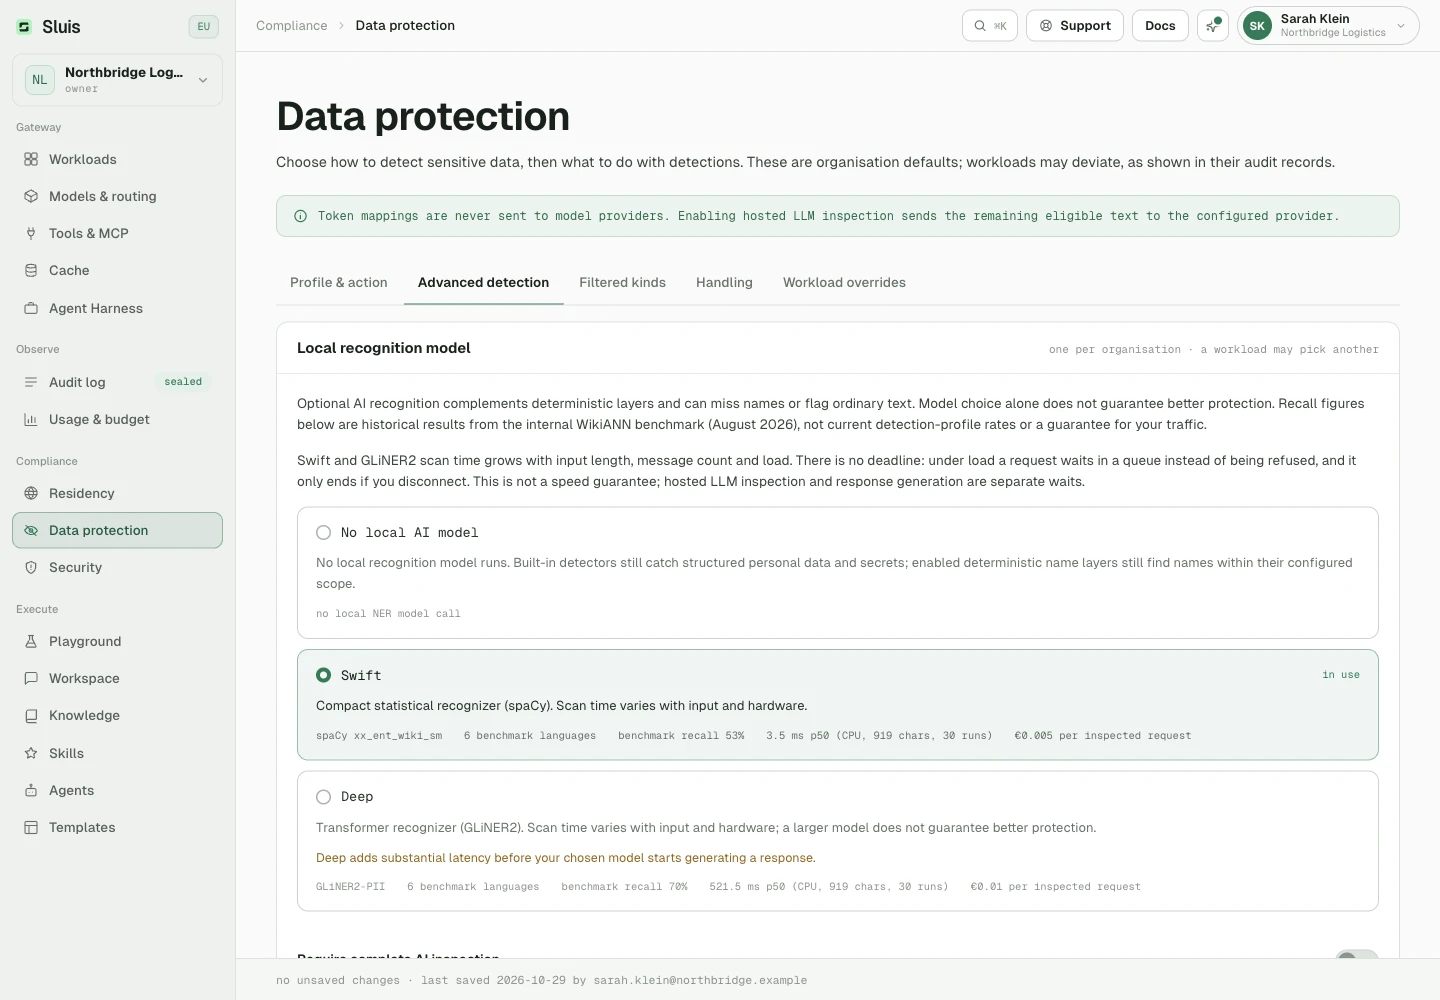
| Modello | Copertura | Accuratezza misurata | Latenza |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Misurato il 2026-08-12 su un benchmark interno: frasi di test WikiANN in sei lingue (NL, EN, DE, FR, ES, IT; 150 per lingua), valutate come micro-F1 su coppie (etichetta, testo) a livello di testo con il filtro anti falsi positivi di produzione applicato, su una macchina di sviluppo Apple Silicon in FP32. WikiANN è materiale di dominio Wikipedia annotato automaticamente ed è il terreno di casa di spaCy. Leggi i numeri come indicazione relativa tra i livelli, non come accuratezza assoluta sul campo.
Scansione di sicurezza
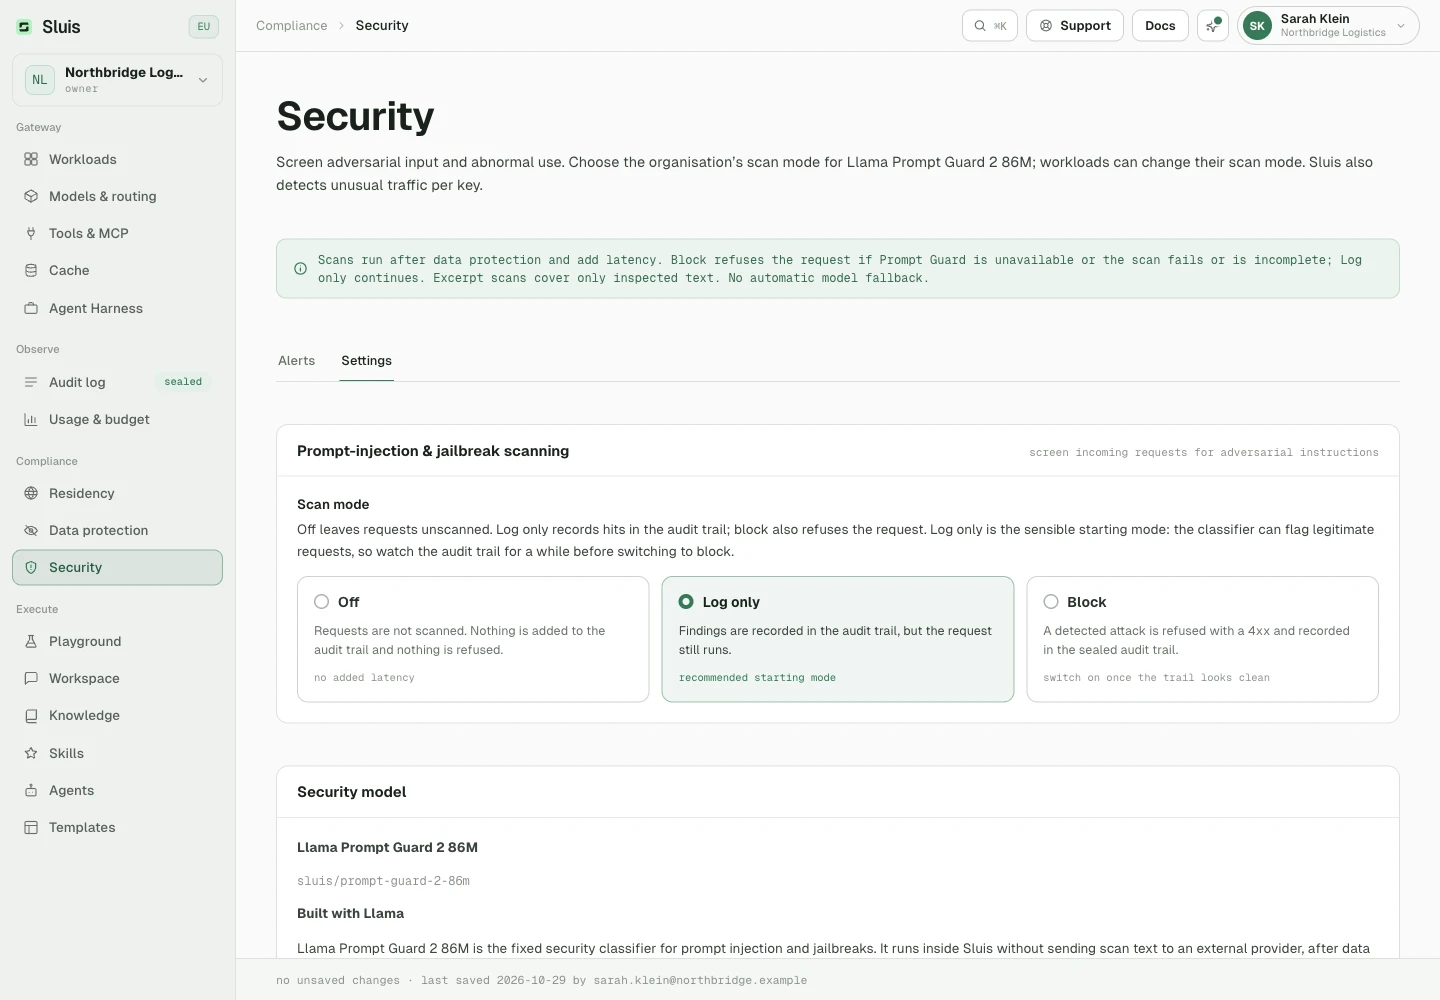
Il rilevamento di prompt injection e jailbreak è opzionale e gira alla chiusa, prima dell’inoltro. Ha tre modalità: off | log | block.
offsalta l’analisi.logregistra i rilevamenti senza bloccare il traffico.blockrifiuta gli attacchi rilevati. Blocca per sicurezza se Prompt Guard non è disponibile o se la classificazione fallisce o è incompleta. Nessun cambio automatico di modello.
Come funziona la scansione
- La sicurezza usa sempre Llama Prompt Guard 2 86M (
sluis/prompt-guard-2-86m), all’interno di Sluis, senza trasferire all’esterno il testo analizzato. - Finestre sovrapposte di al massimo 512 token del modello mantengono i confini dei segmenti, entro un budget totale di scansione da 4096 a 65536 token (8192 per impostazione predefinita).
- La soglia di rilevamento è fissa a 0,8.
- Gli input lunghi usano estratti selezionati. Un esito sicuro copre solo il testo ispezionato, non l’intero input. Il record di audit conserva i byte ispezionati e quelli totali.
- La scansione segue la protezione dei dati, che può conservare dati personali se è disattivata o limitata al registro.
- Le scansioni aggiungono una latenza variabile. Attendono lo scanner finché non risponde o il chiamante si disconnette, e non esiste un limite di tempo per la scansione.
Costo e audit
- 0,01 EUR per scansione logica completata, una sola volta indipendentemente da finestre e verdetto, inclusi gli esiti sicuri su estratti. Nessun supplemento a token.
- Disattivato, rifiuti preliminari ed errori tecnici non sono fatturati.
- Ogni scansione ha una voce di audit fatturabile separata e collegata:
security.scan. Gli addebiti possono applicarsi anche se la richiesta originale è bloccata o servita dalla cache. - Le deroghe del workload possono cambiare la modalità di scansione.
- Separatamente, l’ispezione della privacy Nemotron opzionale usa Nebul secondo la tua policy di residenza ed è fatturata a token.
Built with Llama. Meta Llama 4 Community License.
Rilevamento di anomalie
Il rilevamento opzionale di anomalie nel comportamento delle chiavi gira come job in background, senza alcuna latenza sulle richieste: baseline per chiave da statistiche robuste con stagionalità ora-della-settimana, più un livello multivariato a isolation forest.
Gli alert sono spiegabili, mai un punteggio nudo. Compaiono nella vista Sicurezza della Console, con email opzionale.
Avviso al modello
Quando la tokenizzazione ha riscritto una richiesta, Sluis inietta un messaggio di sistema iniziale che dice al modello che i token «…» sono segnaposto opachi da mantenere intatti. È questo a rendere affidabile il ripristino. È attivo per impostazione predefinita, e puoi personalizzarlo o disattivarlo per organizzazione.
Conservazione e fedeltà dell'audit
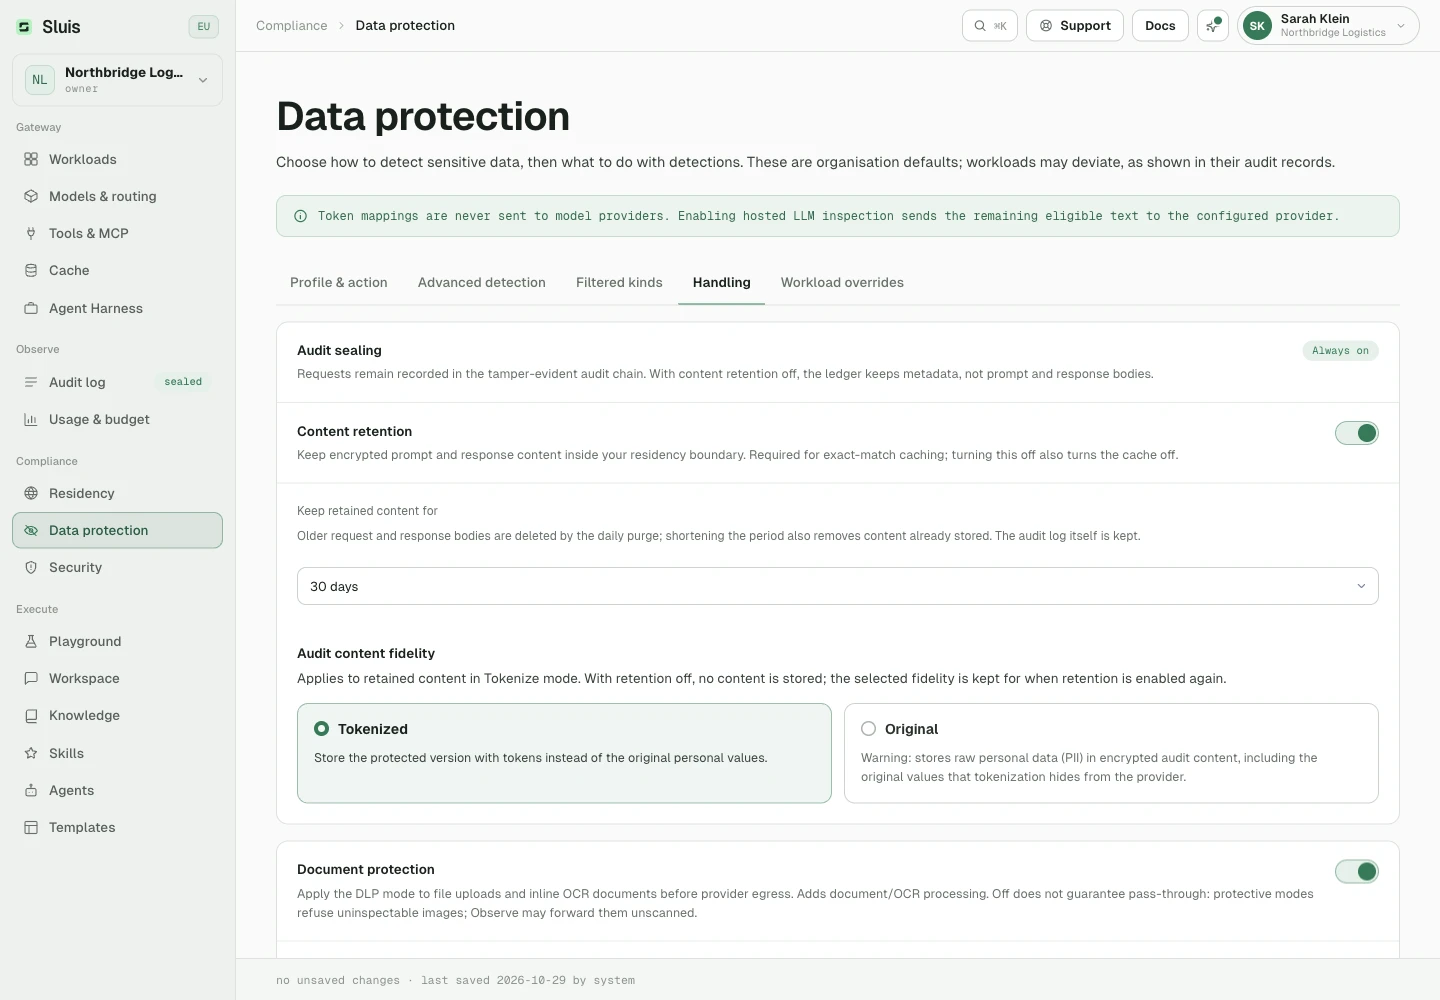
La conservazione dei contenuti mantiene i body di richiesta e risposta per il registro di audit. È attiva per impostazione predefinita e cifrata a riposo.
- La fedeltà dell’audit sceglie se il contenuto conservato memorizza i token o i valori originali.
- Il contenuto conservato scade dopo 30 giorni per impostazione predefinita. Nella vista Protezione dei dati della Console puoi impostare un altro periodo in giorni (da 1 a 36.500) o conservarlo senza scadenza.
- Una pulizia giornaliera applica il periodo in vigore al contenuto già memorizzato, quindi accorciarlo rimuove anche il contenuto più vecchio.
- Il contenuto delle chat di Sluis Workspace viene eliminato dopo il più breve tra quel periodo e il periodo di Workspace per i valori personali nelle chat (7 giorni per impostazione predefinita).
- Il registro dei metadati di audit viene conservato e non viene mai modificato.
- Disattiva la conservazione per avere un registro con soli metadati. Questo disattiva anche la cache delle risposte.
Anonimizzazione di documenti
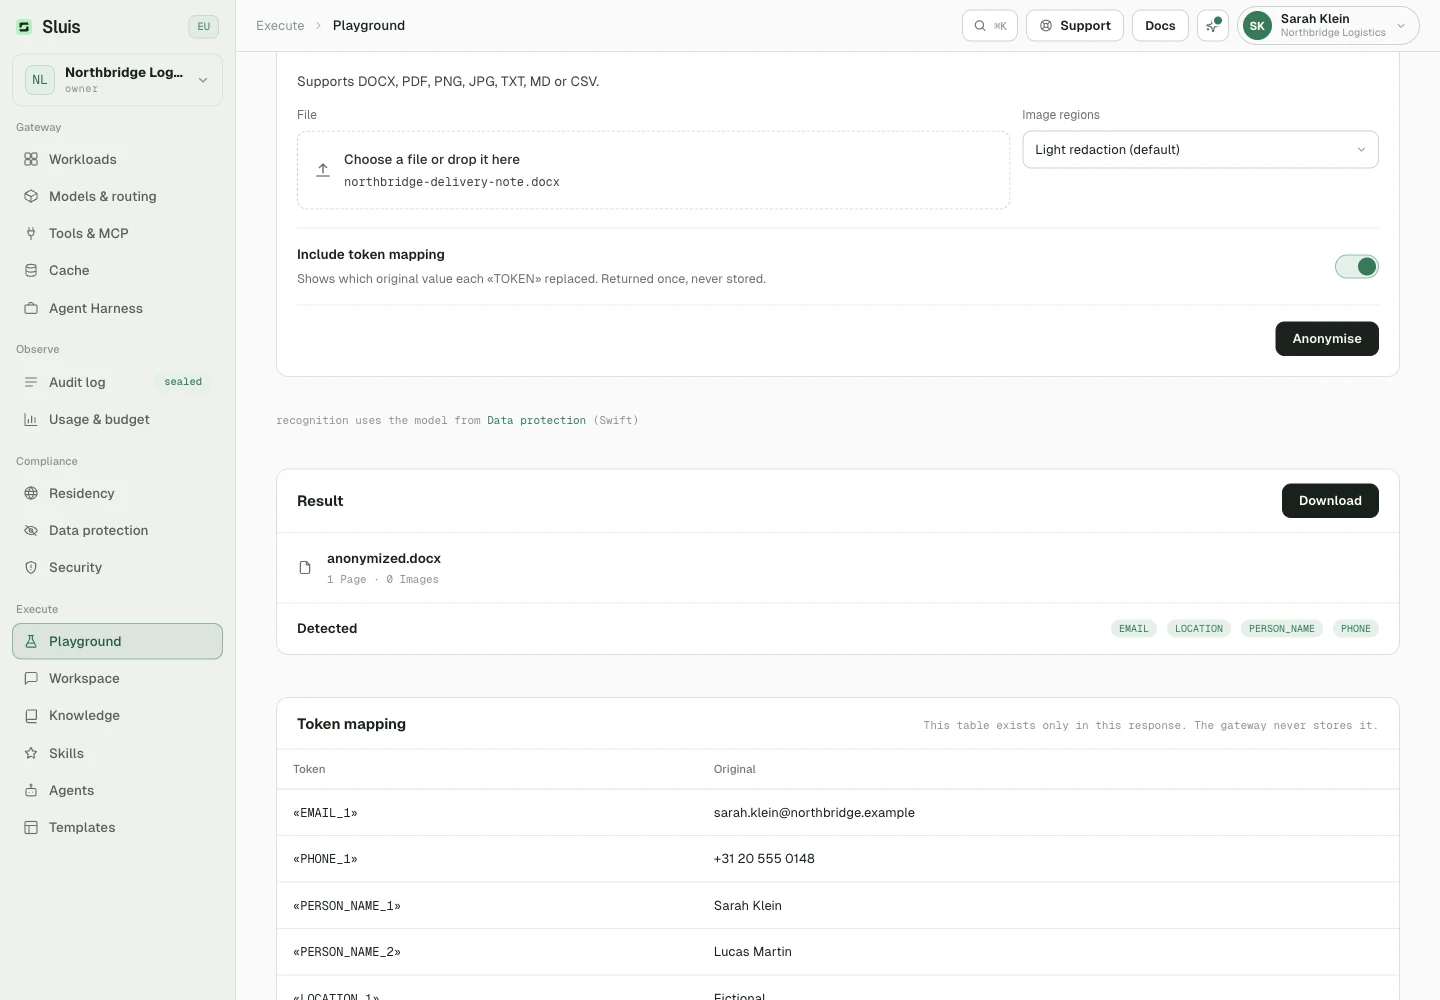
Invia un file docx, pdf, immagine o testo a POST /v1/documents/anonymize e lo stesso documento torna con dati personali e segreti sostituiti da tag come «PERSON_NAME_1» nel testo, e sfocati in immagini e pagine PDF.
- L’elaborazione è locale al gateway, OCR incluso. L’operazione viene sigillata nella catena di audit e fatturata per pagina o immagine.
- I PDF oscurati mantengono uno strato di testo invisibile e ricercabile costruito dal testo anonimizzato.
- Per i documenti grandi, accoda un job asincrono e recupera il risultato in seguito con un URL firmato a tempo.
- Nelle scansioni, le righe che l’OCR non riesce a leggere in modo affidabile (firme, grafia illeggibile) e l’inchiostro fuori da ogni riga di testo riconosciuta (sigle, timbri) vengono distrutti invece di essere indovinati. Nello strato di testo compaiono come
«UNREADABLE», e la risposta riporta la categoriaUNREADABLE_REDACTED.
Mappa dei token
L’endpoint sincrono restituisce la mappa dei token solo se la richiedi (include_mapping: true) e il chiamante ne ha il diritto: un workload con documents e documents_reidentify, oppure un owner o admin della console. La mappa viene sigillata nella catena di audit come conteggi e impronta, e non viene mai salvata. I job asincroni rifiutano le richieste di mappa con 422.
In transito
La stessa protezione vale in transito. Con la policy dlp_documents attiva, i file caricati via /v1/files e i documenti OCR inline vengono anonimizzati prima di uscire verso un provider, rifiutati in modalità block e analizzati in modalità allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
I token pseudonimizzati sono stabili all’interno di una richiesta, non tra richieste, quindi gli embedding di testo tokenizzato possono non coincidere tra le chiamate.
L’impostazione di policy dlp_embeddings controlla se la scansione copre /v1/embeddings. È attiva per impostazione predefinita. Impostarla su off invia gli input di embedding al provider senza scansione, e ogni chiamata esente è registrata nel registro di audit.
Termini da rimuovere per richiesta
Ogni richiesta JSON del piano dati (chat completions, completions, embeddings, responses e gli ingress nativi Anthropic) può portare un’estensione sluis di primo livello con una lista remove. Nomina i termini che il gateway deve rimuovere dal prompt prima dell’inoltro.
- Ogni voce è una stringa semplice, oppure un oggetto con un
texte unkindtraperson | organization | location | term. - Al massimo 128 voci. Ciascuna deve essere non vuota dopo il trim e lunga al massimo 256 caratteri.
- Il confronto avviene ai confini di parola e ignora maiuscole e minuscole.
- L’estensione è un costrutto del gateway. Viene sempre rimossa prima dell’inoltro e non raggiunge mai un provider, la cache o il contenuto conservato.
# name the terms the gateway must remove: the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out: the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Cosa succede a una corrispondenza
Ogni corrispondenza diventa un token reversibile come «PERSON_NAME_1» che si unisce alla normale pseudonimizzazione:
- In modalità
tokenize, quella predefinita, i valori originali sono ripristinati nella risposta, streaming incluso. - In modalità
maskil termine è sostituito da[REDACTED:<kind>]. - In modalità
blockla richiesta è rifiutata con422.
L’istruzione è sempre rispettata, anche se il workload imposta dlp: off, l’organizzazione gira in allow_log o /v1/embeddings è esentato. Può solo rafforzare la protezione, mai indebolirla, ed è per questo che è ammessa per richiesta dove l’header ritirato x-sluis-dlp non lo era. Il termine elencato non raggiunge mai il provider.
Errori e audit
- Una direttiva malformata non viene mai ignorata in silenzio. Un kind sconosciuto, una voce oltre i limiti o un campo sconosciuto dentro l’estensione vengono rifiutati con
422. - Ciò che è stato realmente eseguito è indicato sulla riga di audit sigillata. I termini forniti dal chiamante portano il livello request,
dlp:tokenize:person_name(request), distinto dai livelli(ner)e(directory), così il registro mostra da dove è arrivata ogni rimozione. - L’endpoint sincrono
/v1/documents/anonymizeaccetta la stessa lista come opzioneremove. I job asincroni la rifiutano con422.
Deroghe del workload
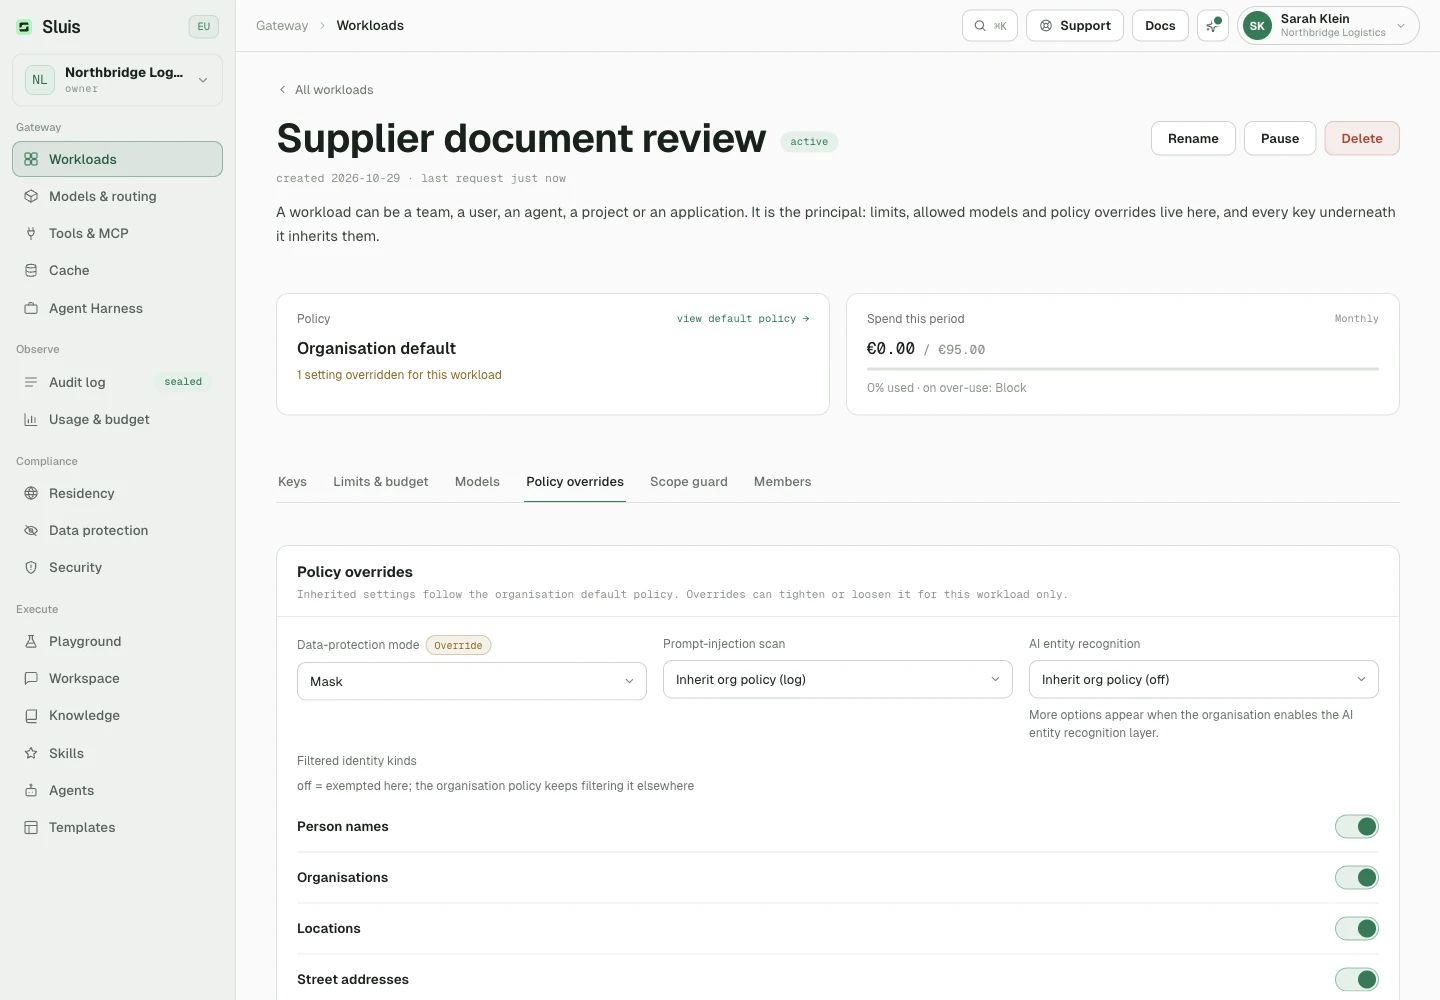
Le deroghe appartengono al workload e si applicano a tutte le sue credenziali. Le opzioni che non imposti ereditano la policy dell’organizzazione.
Scegli ner_model tra off, swift e deep. In dlp.entities imposta i tipi di nomi e in dlp.detectors i rilevatori integrati come record_id o vat_number. Le scelte assenti ereditano le impostazioni dell’organizzazione. Valgono anche per documenti e immagini, rispettando l’attivazione e l’azione di protezione dell’organizzazione. Un altro rilevatore può trovare lo stesso valore.
- Nella Console, un owner o admin configura
option_overridesin Workloads. - Via API, imposta
option_overridesconPOST /admin/workloadsquando crei un workload.
Per modificare un workload esistente, PATCH /admin/workloads/{workload_id} richiede tutte le sue impostazioni modificabili, inclusi nome, stato, limiti e budget. Le sostituisce invece di unire i singoli campi.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "entities": { "person": true }, "detectors": { "record_id": false } },
        "ner_model": "swift",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
L’header di richiesta x-sluis-dlp è stato rimosso. Le richieste che lo includono ricevono 400, quindi configura invece il workload. Le deroghe effettive sono registrate nel registro di audit sigillato.