Datenschutz
Erkennungsmodi, die Bibliothek mit 61 Detektoren, Entitätserkennung mit wählbaren Modellen, Security-Scanning, Modell-Hinweis und Aufbewahrung.
Der Datenschutz läuft bei jeder Anfrage vor dem Versand. Der Standardmodus ist tokenize: Jeder erkannte Wert ohne passende Ausnahme wird durch ein stabiles, typisiertes Token wie «EMAIL_1» ersetzt.
Geschützte Werte erreichen den Anbieter nur als Tokens. Die Antwort wird auf dem Rückweg zu Ihnen wieder auf die echten Werte zurückgesetzt, gestreamt oder nicht.
Die Token-Zuordnung lebt für die Dauer der Anfrage im Speicher und wird niemals gespeichert. Die Pseudonymisierung wirkt in eine Richtung: Sie schützt, was Sie senden.
In Sluis Workspace werden öffentliche Websuchergebnisse und die eigene Ausgabe des Modells aus derselben Runde nicht neu tokenisiert. Ein Wert, den die Unterhaltung bereits tokenisiert hat, bleibt durch sein Token ersetzt, und das Audit-Log vermerkt, wann dies galt.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives: only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back: restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Vier Modi bestimmen, was mit einem erkannten Wert geschieht:
tokenize(Standard) ersetzt ihn durch ein umkehrbares Token.maskschreibt ihn irreversibel um.blockweist die Anfrage mit422ab.allow_loglässt ihn durch und markiert dabei die Audit-Zeile.
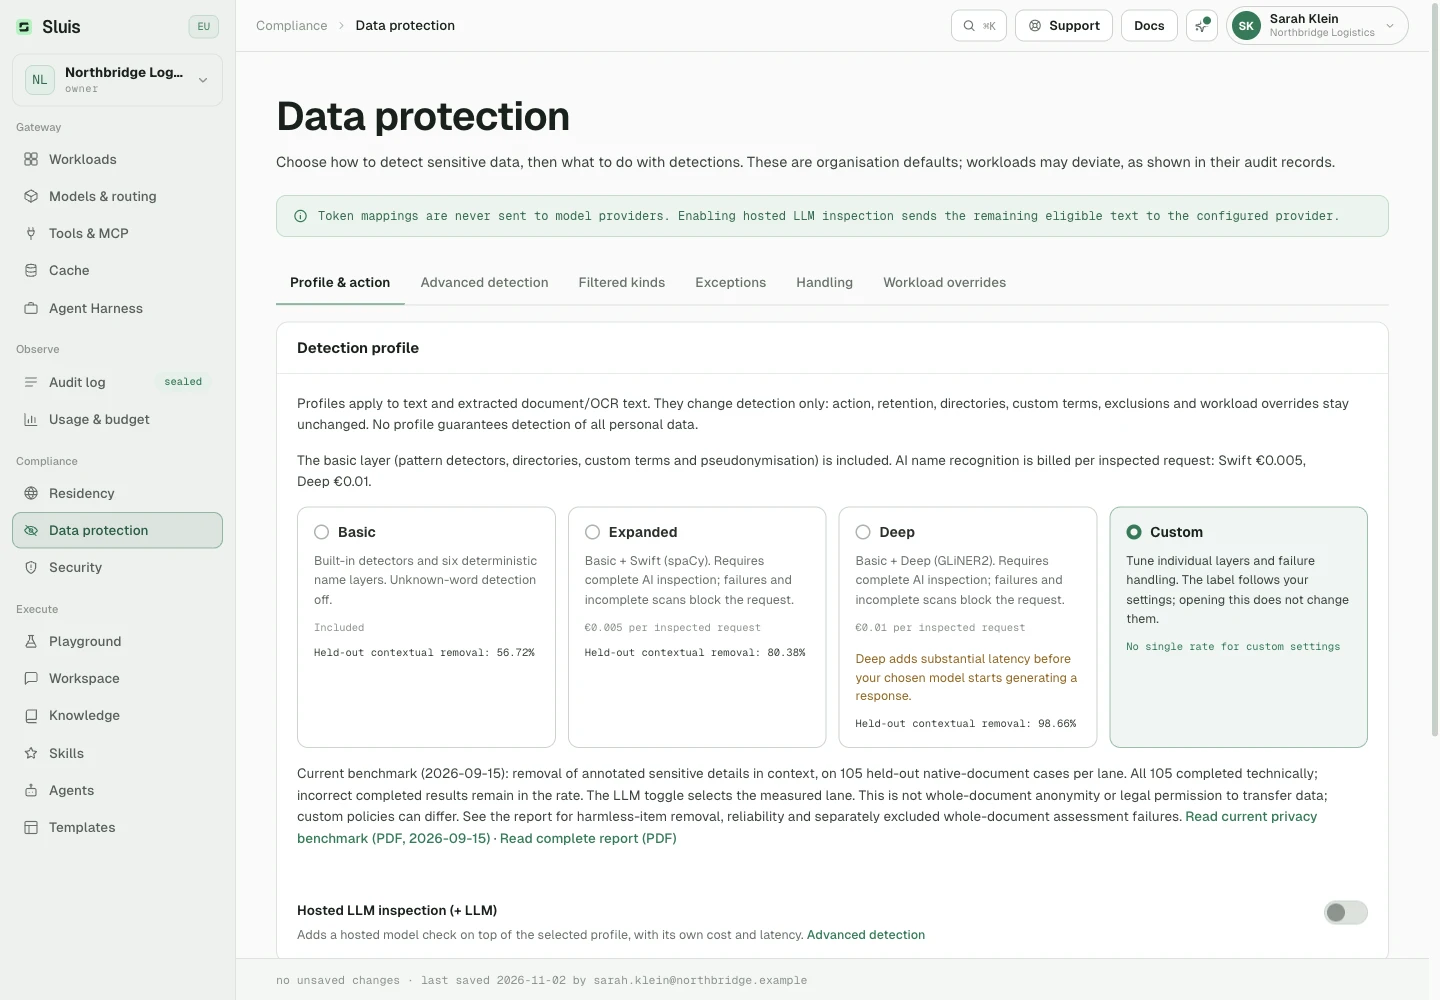
61 integrierte Detektoren sind von Haus aus dabei: 29 für personenbezogene Daten, von der US Social Security Number bis zu nationalen IDs, die per Prüfsumme, Datums- oder Formatregeln des jeweiligen Landes validiert werden, und 32 für Secrets und Zugangsdaten. Jeder lässt sich pro Organisation schalten. Eigene Begriffe (Klartext oder Regex) decken alles ab, was für Ihr Geschäft spezifisch ist. Die Bezeichnung eines eigenen Begriffs darf bis zu 32 Zeichen lang sein:
Musterausnahmen
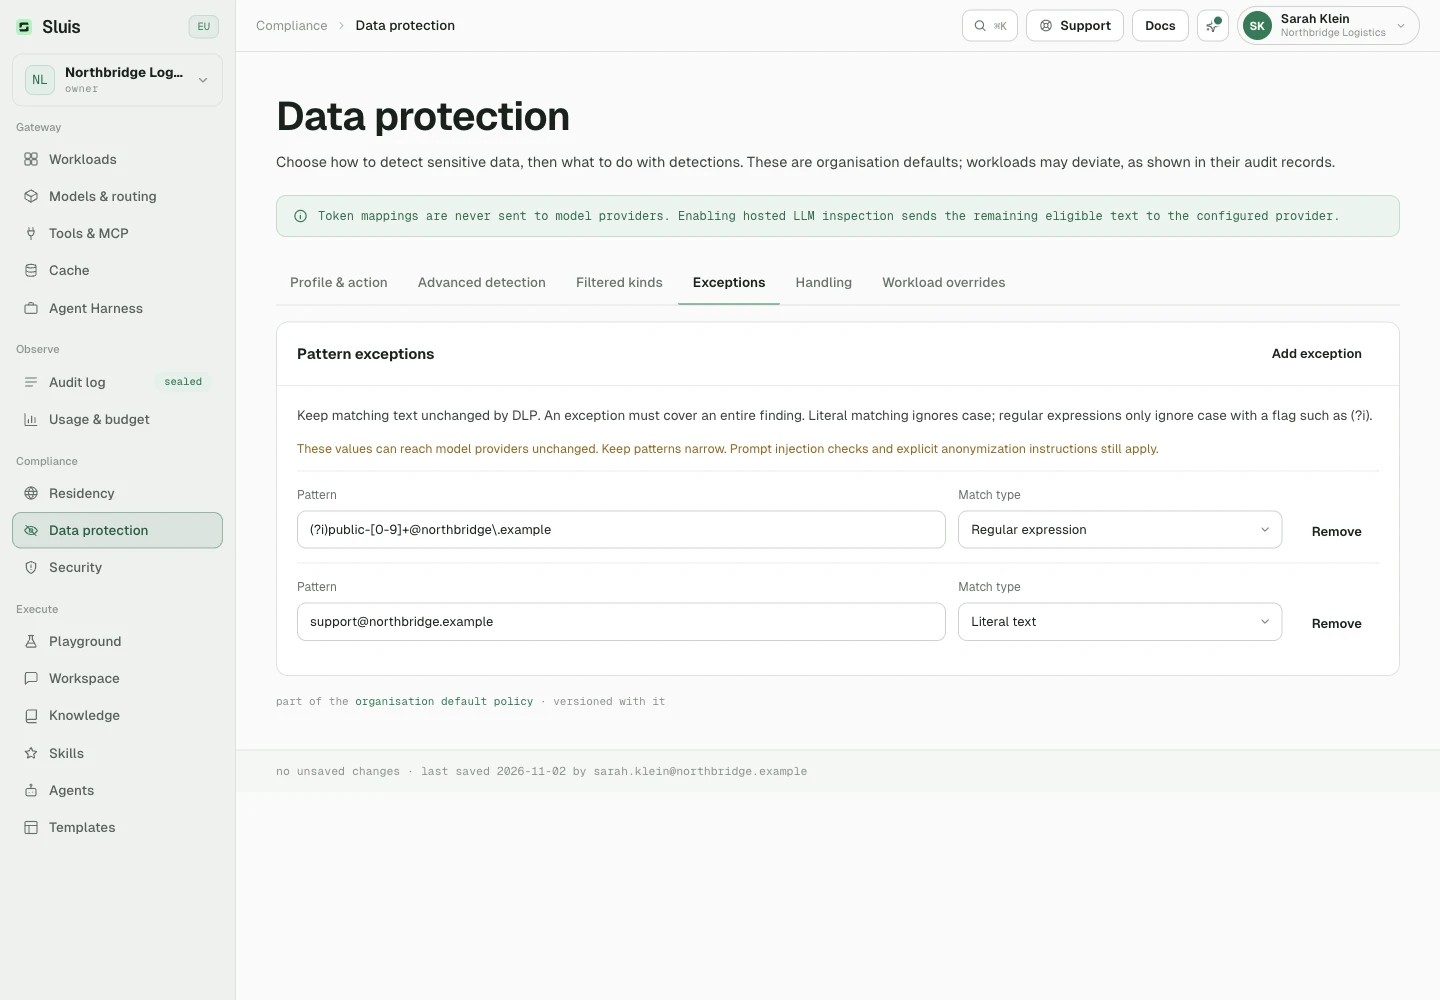
Fügen Sie unter Konsole › Datenschutz › Ausnahmen einen wörtlichen Text oder einen regulären Ausdruck für Werte hinzu, die unverändert bleiben sollen, etwa das öffentliche Postfach support@northbridge.example.
- Wörtliche Muster ignorieren Groß- und Kleinschreibung, auch bei Unicode-Buchstaben.
- Reguläre Ausdrücke verwenden die Rust-regex-Syntax und beachten Groß- und Kleinschreibung, sofern Sie nicht
(?i)ergänzen. - Ein einzelner Ausnahmetreffer im Originaltext muss den gesamten erkannten Wert enthalten. Ein Teiltreffer reicht nicht; getrennte benachbarte oder überlappende Treffer werden nie zusammengefasst.
Verwenden Sie eng gefasste Muster. Ein ausgenommener Wert wird weder tokenisiert noch maskiert und löst keine Sperre der Anfrage aus. Sein Originaltext kann daher den Modellanbieter erreichen. Andere erkannte Werte bleiben geschützt.
Ausnahmen gelten für integrierte und eigene Detektoren, Namen, Wörterbücher sowie lokale oder gehostete Entitätserkennung, auch im geschützten Text von Dokumenten und Embeddings. Die Prüfung auf Prompt-Injection und andere Sicherheitsprüfungen bleiben aktiv. Explizite Entfernungsbegriffe in sluis.remove oder einer Dokumentanfrage haben immer Vorrang.
Entitätserkennung
Personen, Organisationen und Orte lassen sich allein per Muster schwer erkennen. Sluis kombiniert mehrere Schichten:
- Kontextheuristiken
- E-Mail-Korrelation
- ein Mandantenverzeichnis für Namen
- mitgelieferte Wörterbücher
- optionales NER (Named Entity Recognition)
Das NER-Modell läuft als netzwerkinterner Sidecar, der Text bleibt also innerhalb des Deployments. Diese Schichten prüfen auch extrahierten Dokument- und OCR-Text, wenn der Dokumentenschutz aktiviert ist.
- Mit aktivem NER darf eine Anfrage bis zu 100.000 verschiedene Entitäten und 6,4 Millionen Zeichen Text enthalten. Oberhalb dieser Grenze gilt der Scan als unvollständig.
- Ein Name, den das Modell einmal erkennt, wird überall in der Anfrage ersetzt, wo er wieder vorkommt: als dasselbe ganze Wort, in gleicher Groß- und Kleinschreibung und mit demselben Token, auch in Nachrichten, in denen das Modell ihn nicht gemeldet hat.
- Einzelne allgemeine Wörter und kurze Akronyme werden nur an der Stelle ersetzt, die das Modell gemeldet hat.
Namenswörterbuch
Das Namenswörterbuch ist das deterministische Gegenstück zu NER: Vor- und Nachnamen, aus offenen Behördendaten zu einem Wörterbuch kompiliert, das im Gateway mitgeliefert wird.
- Es erkennt vollständige Namen und Namen nach einer Anrede, ohne zusätzliche Latenz und ohne dass etwas Ihren Perimeter verlässt.
- Namen, die zugleich gewöhnliche Wörter sind, werden nur mit namensartigem Kontext erkannt.
- Seltene Namen bleiben Sache des Verzeichnisses oder des NER.
NER-Modelloptionen
Wählen Sie Basis, Erweitert oder Tiefgehend unter Datenschutz.
- Basis ist der Standard für neue Organisationen. Es verwendet eingebaute Detektoren und sechs deterministische Namensschichten, ohne Modellaufruf.
- Erweitert ergänzt Swift (spaCy).
- Tiefgehend ergänzt stattdessen GLiNER2-PII. Es braucht mehr Rechenzeit, garantiert aber keine höhere Trefferquote.
- Benutzerdefiniert erlaubt einzelne Anpassungen.
Beide KI-Profile verlangen eine vollständige Prüfung und blockieren Modellfehler oder unvollständige Scans.
- Bestehende Richtlinien, Ausschlüsse, Verzeichnisse und Workload-Abweichungen bleiben unverändert.
- Die Erkennung unbekannter Wörter bleibt in allen drei Profilen aus.
- Ein Workload kann ein verfügbares NER-Modell wählen, auch wenn die Organisation es standardmäßig ausgeschaltet hat.
Abrechnung
- Die KI-Namenserkennung wird einmal pro geprüfter Kundenanfrage abgerechnet: 0,005 € mit Swift (Erweitert), 0,01 € mit GLiNER2 (Tiefgehend). Basis ist inklusive.
- Folgeaufrufe, die Sluis innerhalb dieser Anfrage macht, werden nicht erneut berechnet, und eine unvollständige Prüfung kostet nichts.
- Jede Belastung ist ein verknüpfter Audit-Beleg, der auf Ihre Budgets angerechnet wird.
Latenz
- Tiefgehend verursacht erhebliche zusätzliche Latenz, bevor Ihr gewähltes Modell eine Antwort erzeugt.
- Die Scanzeit von Swift und GLiNER2 wächst mit Eingabelänge, Nachrichtenanzahl und Auslastung.
- Es gibt keine Frist: Unter Last wartet eine Anfrage in einer Warteschlange, statt abgelehnt zu werden, und endet nur, wenn Sie die Verbindung trennen. Das ist keine Geschwindigkeitsgarantie.
- Die optionale gehostete LLM-Prüfung fügt vor der Antwortgenerierung eine weitere Wartezeit hinzu, abhängig von Eingabelänge, Anbieterauslastung und Wiederholungen.
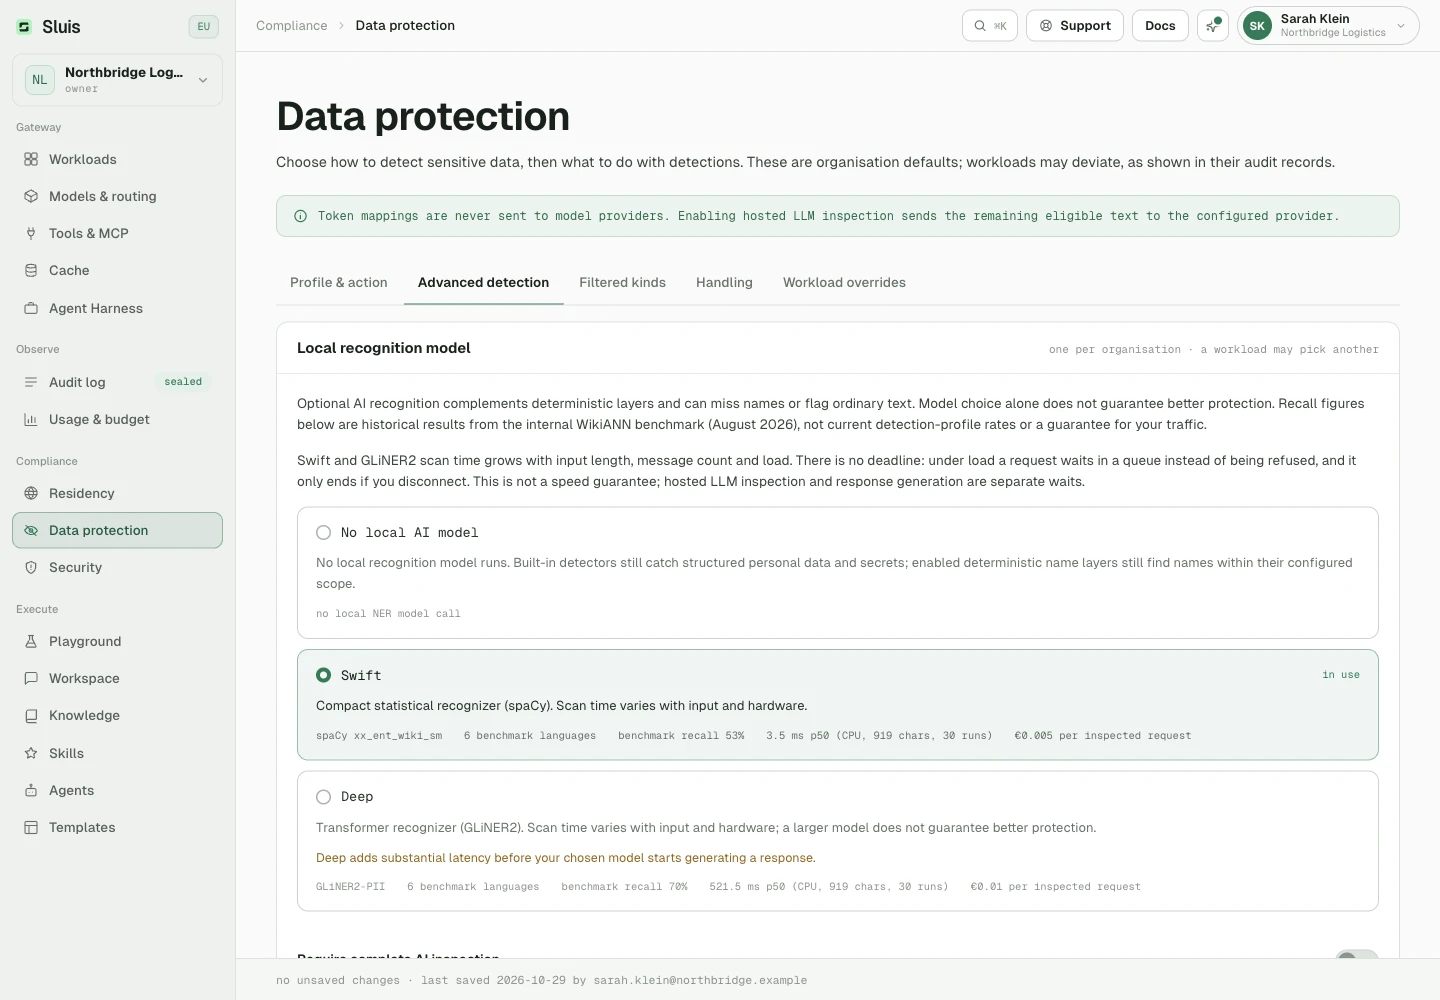
| Modell | Abdeckung | Gemessene Genauigkeit | Latenz |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Gemessen am 12.08.2026 mit einem internen Benchmark: WikiANN-Testsätze in sechs Sprachen (NL, EN, DE, FR, ES, IT; je 150 pro Sprache), bewertet als Micro-F1 über (Label, Text)-Paare auf Textebene, mit dem produktiven Falsch-Positiv-Filter, auf einem Entwicklungsrechner mit Apple Silicon bei FP32. WikiANN sind Wikipedia-Daten mit Silver-Standard und spaCys Heimspiel. Lesen Sie die Zahlen als relative Orientierung zwischen den Stufen, nicht als absolute Genauigkeit im Einsatz.
Security-Scanning
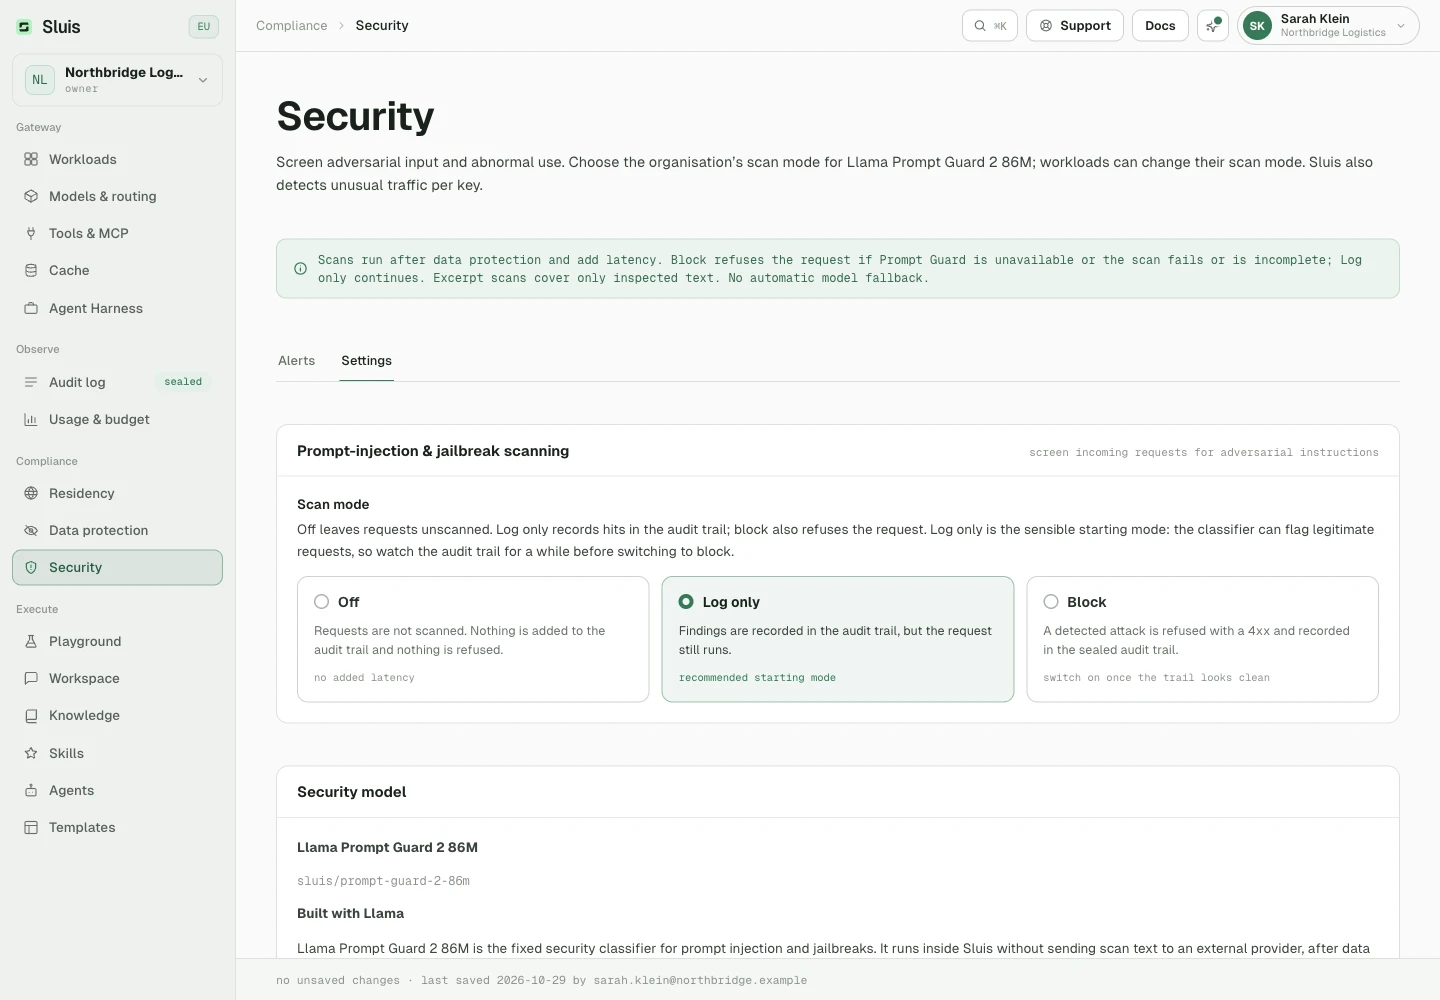
Die Erkennung von Prompt-Injection und Jailbreaks ist optional und läuft an der Schleuse, vor dem Versand. Es gibt drei Modi: off | log | block.
offüberspringt den Scan.logprotokolliert Funde, ohne den Verkehr zu blockieren.blockweist erkannte Angriffe ab. Der Modus schlägt geschlossen fehl (fail closed), wenn Prompt Guard nicht verfügbar ist oder die Klassifizierung fehlschlägt oder unvollständig bleibt. Es gibt keinen automatischen Modellwechsel.
So funktioniert der Scan
- Die Sicherheit verwendet immer Llama Prompt Guard 2 86M (
sluis/prompt-guard-2-86m), innerhalb von Sluis und ohne externe Übertragung des Prüftexts. - Überlappende Fenster mit höchstens 512 Modelltokens erhalten die Segmentgrenzen, innerhalb eines Gesamtbudgets von 4096 bis 65536 Tokens (standardmäßig 8192).
- Die Erkennungsschwelle ist fest auf 0,8 gesetzt.
- Lange Eingaben werden über ausgewählte Auszüge geprüft. Ein sicheres Ergebnis gilt nur für den geprüften Text, nicht für die ganze Eingabe. Der Audit-Eintrag hält die geprüften und die gesamten Bytes fest.
- Der Scan folgt dem Datenschutz, der bei Aus oder reinem Protokollieren personenbezogene Daten behalten kann.
- Scans erhöhen die Latenz in wechselndem Maß. Sie warten auf den Scanner, bis er antwortet oder der Aufrufer die Verbindung trennt, und es gibt keine Scanfrist.
Kosten und Audit
- 0,01 € pro abgeschlossenem logischem Scan, einmalig, unabhängig von Fenstern und Urteil, auch bei sicheren Stichproben. Kein Token-Aufschlag.
- Aus, Vorabverweigerungen und technische Fehler werden nicht berechnet.
- Jeder Scan hat einen eigenen, verknüpften abrechenbaren Audit-Eintrag:
security.scan. Kosten können auch anfallen, wenn die übergeordnete Anfrage blockiert oder aus dem Cache bedient wird. - Workload-Overrides können den Scanmodus ändern.
- Getrennt davon nutzt die optionale Nemotron-Datenschutzprüfung Nebul gemäß Ihrer Residency-Policy und wird nach Tokens abgerechnet.
Built with Llama. Meta Llama 4 Community License.
Anomalieerkennung
Die optionale Anomalieerkennung für das Verhalten von Keys läuft als Hintergrundjob ohne zusätzliche Latenz für Anfragen: Baselines pro Key aus robuster Statistik mit Wochenrhythmus nach Stunde, dazu eine multivariate Isolation-Forest-Schicht.
Alarme sind nachvollziehbar und nie ein bloßer Score. Sie erscheinen in der Sicherheitsansicht der Console, optional auch per E-Mail.
Modell-Hinweis
Wenn die Tokenisierung eine Anfrage umgeschrieben hat, fügt Sluis eine vorangestellte System-Nachricht ein. Sie teilt dem Modell mit, dass die «…»-Tokens undurchsichtige Platzhalter sind, die es unversehrt lassen muss. Genau das hält die Wiederherstellung zuverlässig. Der Hinweis ist standardmäßig aktiv und lässt sich pro Organisation anpassen oder abschalten.
Aufbewahrung & Audit-Fidelität
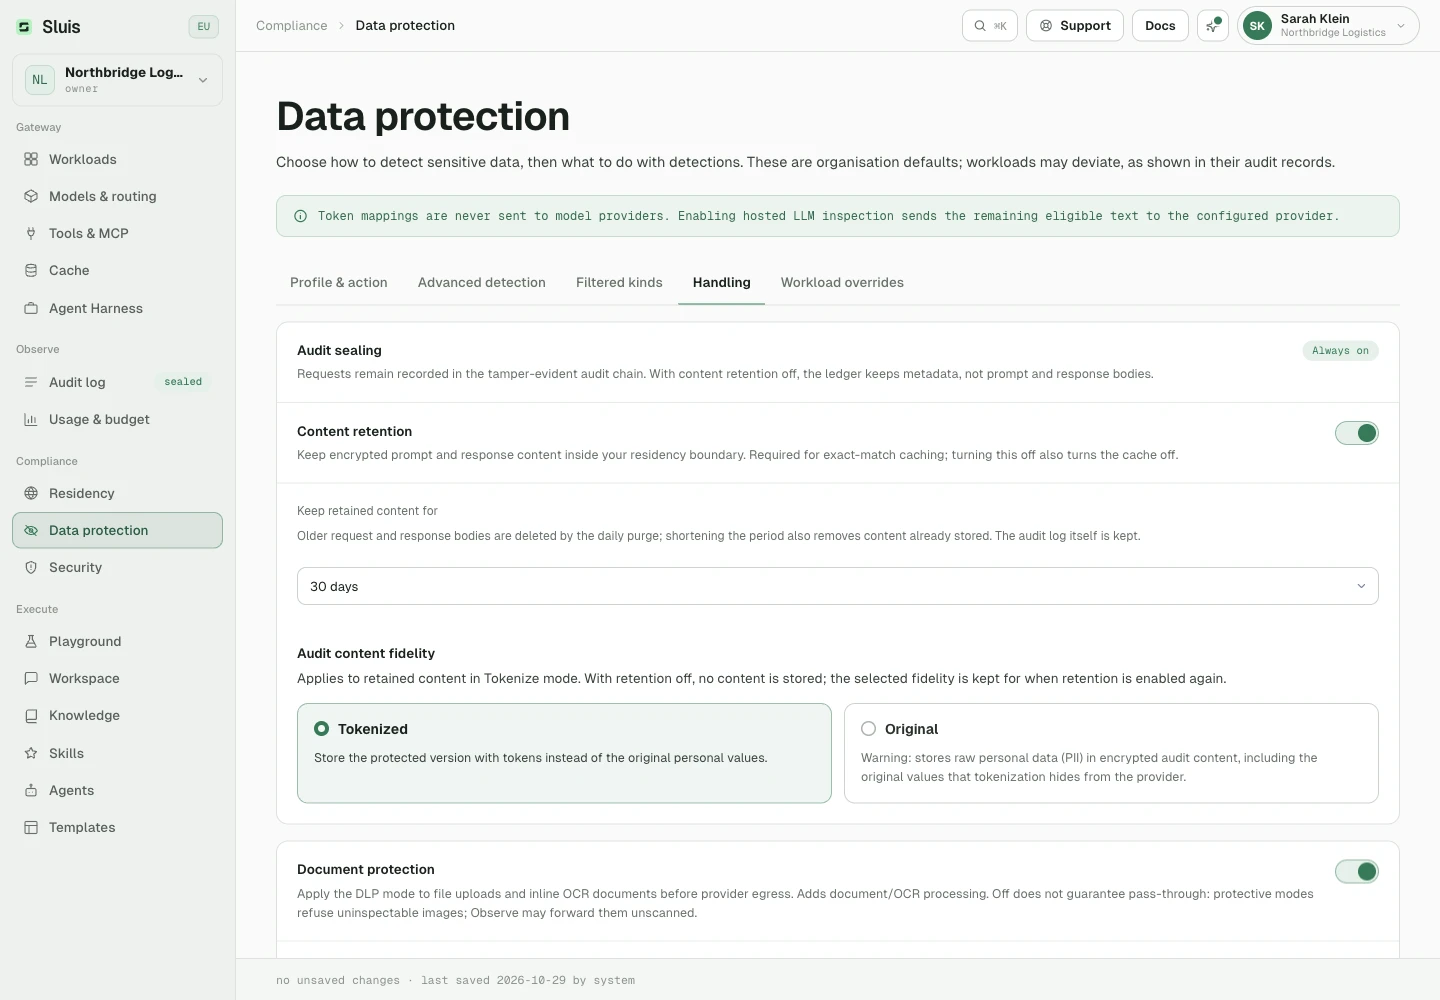
Die Inhaltsaufbewahrung speichert Request- und Response-Bodies für das Audit-Log. Sie ist standardmäßig aktiv und im Ruhezustand verschlüsselt.
- Die Audit-Fidelität legt fest, ob der aufbewahrte Inhalt die Tokens oder die Originalwerte speichert.
- Aufbewahrter Inhalt läuft standardmäßig nach 30 Tagen ab. In der Datenschutz-Ansicht der Console können Sie eine andere Frist in Tagen festlegen (1 bis 36.500) oder ihn unbegrenzt behalten.
- Eine tägliche Bereinigung wendet die aktuelle Frist auf bereits gespeicherten Inhalt an. Eine kürzere Frist entfernt also auch älteren Inhalt.
- Inhalt aus Sluis Workspace-Chats wird nach der kürzeren dieser Frist und der Workspace-Frist für personenbezogene Werte in Chats gelöscht (standardmäßig 7 Tage).
- Das Register der Audit-Metadaten bleibt erhalten und wird nie verändert.
- Schalten Sie die Aufbewahrung aus, erhalten Sie ein Register nur mit Metadaten. Das deaktiviert auch den Response-Cache.
Dokument-Anonymisierung
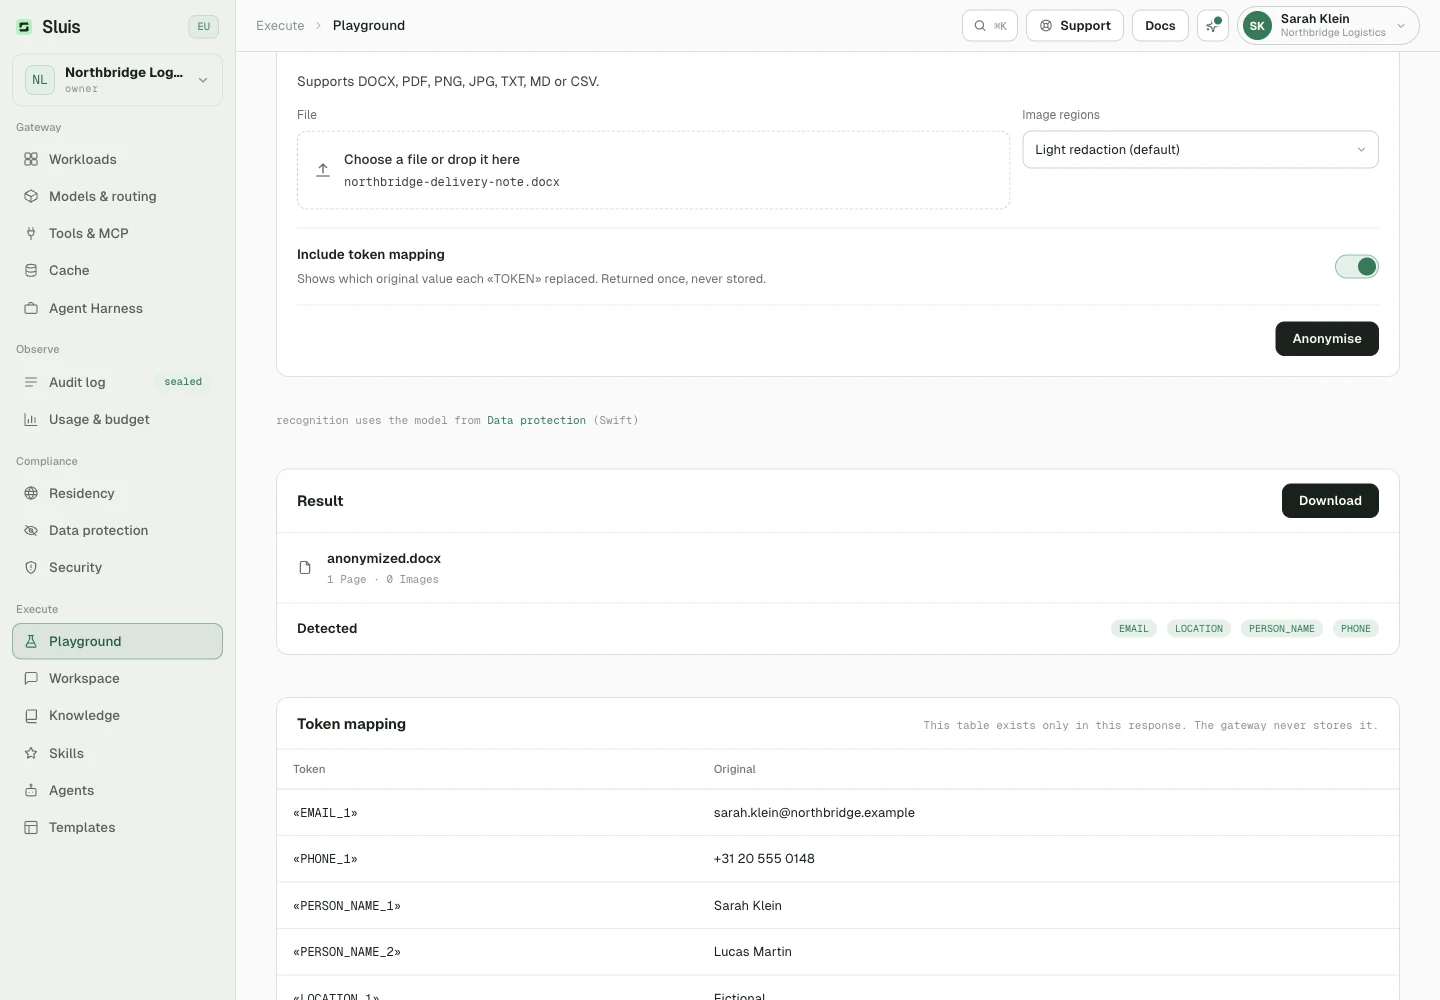
Senden Sie eine docx-, pdf-, Bild- oder Textdatei an POST /v1/documents/anonymize. Sie erhalten dasselbe Dokument zurück, in dem personenbezogene Daten und Secrets im Text durch Merge-Tags wie «PERSON_NAME_1» ersetzt und in Bildern und PDF-Seiten unkenntlich gemacht sind.
- Die Verarbeitung läuft lokal im Gateway, OCR eingeschlossen. Der Vorgang wird in der Audit-Kette versiegelt und pro Seite oder Bild gemessen.
- Geschwärzte PDFs behalten eine unsichtbare, durchsuchbare Textschicht, die aus dem anonymisierten Text erzeugt wird.
- Bei großen Dokumenten stellen Sie einen asynchronen Job in die Warteschlange und holen das Ergebnis später über eine zeitlich begrenzte signierte URL ab.
- In Scans werden Zeilen, die die OCR nicht zuverlässig lesen kann (Unterschriften, unleserliche Handschrift), und Tinte außerhalb jeder erkannten Textzeile (Paraphen, Stempel) vernichtet, statt geraten zu werden. Sie lauten in der Textschicht
«UNREADABLE», und die Antwort meldet die KategorieUNREADABLE_REDACTED.
Token-Zuordnung
Der synchrone Endpunkt liefert die Token-Zuordnung nur, wenn Sie sie anfordern (include_mapping: true) und der Aufrufer berechtigt ist: ein Workload mit documents und documents_reidentify oder ein Console-Owner oder -Admin. Die Zuordnung wird als Anzahl und Hash in der Audit-Kette versiegelt und nie gespeichert. Asynchrone Jobs lehnen Anfragen nach der Zuordnung mit 422 ab.
Auf dem Transportweg
Derselbe Schutz wirkt auch auf dem Transportweg. Mit aktiver dlp_documents-Policy werden Dateien, die über /v1/files hochgeladen werden, und Inline-OCR-Dokumente anonymisiert, bevor sie zu einem Anbieter gehen. Unter block werden sie abgelehnt, unter allow_log gescannt.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Pseudonymisierte Tokens sind innerhalb einer Anfrage stabil, nicht über Anfragen hinweg. Embeddings von tokenisiertem Text stimmen daher zwischen Aufrufen womöglich nicht überein.
Die Policy-Einstellung dlp_embeddings steuert, ob der Scan /v1/embeddings abdeckt. Sie ist standardmäßig aktiv. Mit off gehen Embedding-Eingaben ungescannt an den Anbieter, und jeder ausgenommene Aufruf wird in der Audit-Kette festgehalten.
Entfernungsbegriffe pro Anfrage
Jede JSON-Anfrage auf der Datenebene (chat completions, completions, embeddings, responses und die nativen Anthropic-Ingresses) darf eine sluis-Erweiterung auf oberster Ebene mit einer remove-Liste tragen. Sie benennt die Begriffe, die das Gateway vor dem Versand aus dem Prompt entfernen muss.
- Jeder Eintrag ist ein reiner String oder ein Objekt mit
textund einemkindausperson | organization | location | term. - Höchstens 128 Einträge. Jeder muss nach dem Trimmen nicht leer und höchstens 256 Zeichen lang sein.
- Verglichen wird an Wortgrenzen und ohne Rücksicht auf Groß- und Kleinschreibung.
- Die Erweiterung ist ein Konstrukt des Gateways. Sie wird immer vor dem Versand entfernt und erreicht nie einen Anbieter, den Cache oder aufbewahrte Inhalte.
# name the terms the gateway must remove: the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out: the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Was mit einem Treffer geschieht
Jeder Treffer wird zu einem umkehrbaren Token wie «PERSON_NAME_1», das in die normale Pseudonymisierung einfließt:
- Unter
tokenize, dem Standard, werden die Originalwerte in der Antwort wiederhergestellt, auch beim Streaming. - Unter
maskwird der Begriff durch[REDACTED:<kind>]ersetzt. - Unter
blockwird die Anfrage mit422abgewiesen.
Die Anweisung wird immer befolgt, auch wenn der Workload dlp: off setzt, die Organisation in allow_log läuft oder /v1/embeddings ausgenommen ist. Sie kann den Schutz nur verstärken, nie abschwächen. Deshalb ist sie pro Anfrage erlaubt, anders als der entfernte x-sluis-dlp-Header. Der aufgeführte Begriff erreicht den Anbieter nie.
Fehler und Audit
- Eine fehlerhafte Anweisung wird nie stillschweigend ignoriert. Eine unbekannte Art, ein Eintrag über den Grenzen oder ein unbekanntes Feld innerhalb der Erweiterung wird mit
422abgewiesen. - Was tatsächlich lief, steht in der versiegelten Audit-Zeile. Vom Aufrufer gelieferte Begriffe tragen die Anfrageschicht
dlp:tokenize:person_name(request), getrennt von den Schichten(ner)und(directory), sodass die Kette zeigt, woher jede Entfernung stammt. - Der synchrone Endpunkt
/v1/documents/anonymizeakzeptiert dieselbe Liste alsremove-Option. Asynchrone Jobs lehnen sie mit422ab.
Workload-Option-Overrides
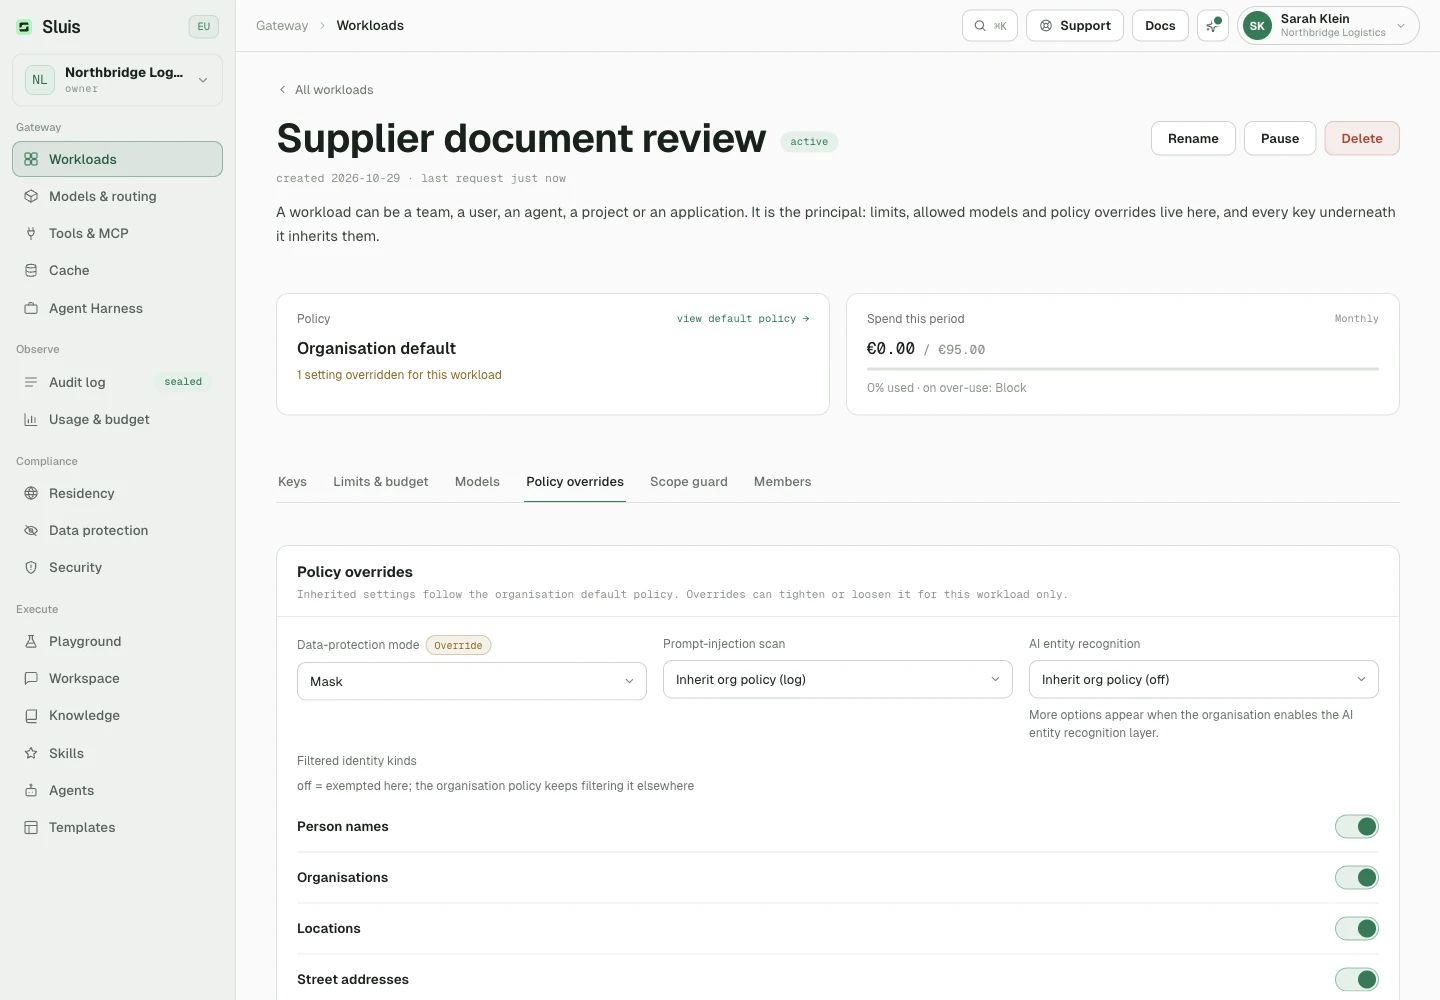
Overrides gehören zum Workload und gelten für alle seine Zugangsdaten. Optionen, die Sie nicht setzen, erben die Policy der Organisation.
Wählen Sie für ner_model off, swift oder deep. Unter dlp.entities stellen Sie Namensarten ein, unter dlp.detectors integrierte Detektoren wie record_id oder vat_number. Fehlende Einstellungen erben die Organisationsvorgabe. Sie gelten auch für Dokumente und Bilder, wobei Schutzschalter und Aktion der Organisation gelten. Ein anderer Detektor kann denselben Wert weiterhin finden.
- In der Console konfiguriert ein Owner oder Admin
option_overridesunter Workloads. - Über die API setzen Sie
option_overridesmitPOST /admin/workloadsbeim Anlegen eines Workloads.
Um einen bestehenden Workload zu bearbeiten, braucht PATCH /admin/workloads/{workload_id} dessen vollständige veränderbare Einstellungen, einschließlich Name, Status, Limits und Budget. Der Aufruf ersetzt sie, statt einzelne Felder zusammenzuführen.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "entities": { "person": true }, "detectors": { "record_id": false } },
        "ner_model": "swift",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
Der Request-Header x-sluis-dlp wurde entfernt. Anfragen mit diesem Header erhalten 400, konfigurieren Sie also stattdessen den Workload. Wirksame Overrides werden in der versiegelten Audit-Kette festgehalten.