API-Referenz
Authentifizierung, Endpoints, Streaming, Reasoning und Fehler der OpenAI-Oberfläche, native Anthropic-APIs und Kompatibilitätsmatrix pro Endpoint.
Authentifizierung
Jede Anfrage an /v1/* authentifiziert sich mit einem virtuellen Key im Header Authorization: Bearer. Erstellen Sie Keys in der Console unter Workloads.
- Das Secret wird einmal angezeigt, gespeichert wird nur sein Hash.
- Ein Key ist ein Zugangsdatum für einen Workload. Der Workload besitzt Rate-Limits, Budget, erlaubte Modelle und Policy-Overrides. Die Organisations-Policy gilt weiterhin.
- Ein Key kann ein optionales Ablaufdatum tragen. Danach wird er genau wie ein unbekannter Key abgewiesen.
- Ein Modell, das nicht auf der nicht leeren Allow-List des Workloads steht, wird mit einem versiegelten
403 permission_errorabgewiesen, bevor etwas versendet wird. Die Abweisung selbst landet in der Audit-Kette. - Ein Workload kann seine Keys auf Endpunkt-Familien beschränken, zum Beispiel chat und embeddings. Andere Familien erhalten ein versiegeltes
403 operation_not_allowed, bevor etwas versendet wird. - Für einen Produktions-Key brauchen Sie eine verifizierte E-Mail-Adresse.
- Eine Ausnahme: Die signierten, zeitlich begrenzten Download-Links für anonymisierte Dokumente brauchen keinen Key.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the workload's allow-list never dispatches:
# → 403 permission_error, and the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    {
      "id": "mistral/mistral-large-latest",
      "object": "model",
      "created": 1704067200,
      "owned_by": "mistral",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": 0.55,
        "output_eur_per_mtok": 1.65,
        "cached_input_eur_per_mtok": 0.055,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }],
        "eur_per_page": null,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    },
    {
      "id": "sluis/fast",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "text",
      "context_window": 128000,
      "capabilities": { "tools": true, "vision": false, "reasoning": null },
      "residency": { "jurisdiction": "EU", "region": "Paris, France", "country": "FR", "owner_is_eu": true },
      "resolves_to": "mistral/mistral-large-latest",
      "pricing": { "input_eur_per_mtok": 0.55, "output_eur_per_mtok": 1.65, "cached_input_eur_per_mtok": 0.055, "audio_input_eur_per_mtok": null, "audio_output_eur_per_mtok": null, "long_context": [{ "from_tokens": 200000, "input_eur_per_mtok": 1.1, "output_eur_per_mtok": 3.3 }], "eur_per_page": null, "eur_per_minute": null, "eur_per_image": null, "estimated": false }
    },
    {
      "id": "sluis/auto",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": null,
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": null
    },
    {
      "id": "sluis/ocr",
      "object": "model",
      "created": 1704067200,
      "owned_by": "sluis",
      "kind": "ocr",
      "context_window": null,
      "capabilities": { "tools": null, "vision": null, "reasoning": null },
      "residency": null,
      "resolves_to": null,
      "pricing": {
        "input_eur_per_mtok": null,
        "output_eur_per_mtok": null,
        "cached_input_eur_per_mtok": null,
        "audio_input_eur_per_mtok": null,
        "audio_output_eur_per_mtok": null,
        "long_context": [],
        "eur_per_page": 0.01,
        "eur_per_minute": null,
        "eur_per_image": null,
        "estimated": false
      }
    }
  ]
}
Endpunkte
Sluis stellt die unten stehende OpenAI-kompatible Oberfläche bereit, dazu die nativen Anthropic-Pfade, die weiter unten beschrieben sind.
Endpunkte ohne First-Class-Handler werden unverändert an den gerouteten Anbieter weitergereicht, Streaming inbegriffen, sodass OpenAI-kompatible Upstreams volle Fidelität behalten.
Ein Browser, der einen Pfad öffnet, den die API nicht bedient, etwa den bloßen API-Host, wird zu dieser Dokumentation weitergeleitet. API-Clients erhalten weiterhin ein schlichtes 404.
| Endpunkt | Zweck |
|---|---|
| POST / | Chat Completions, die primäre Oberfläche: Routing, Datenschutz, Caching, Streaming. |
| POST / | Legacy-Text-Completions. |
| POST / | Embeddings. |
| POST / | Moderations-Klassifikation. |
| POST / | Die OpenAI Responses API. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | Dokument-OCR (Mistral, oder vollständig lokal mit dem Modell sluis/ocr), pro Seite abgerechnet. Mit aktiver dlp_documents-Policy werden Inline-Dokumente anonymisiert, bevor sie das Haus verlassen. |
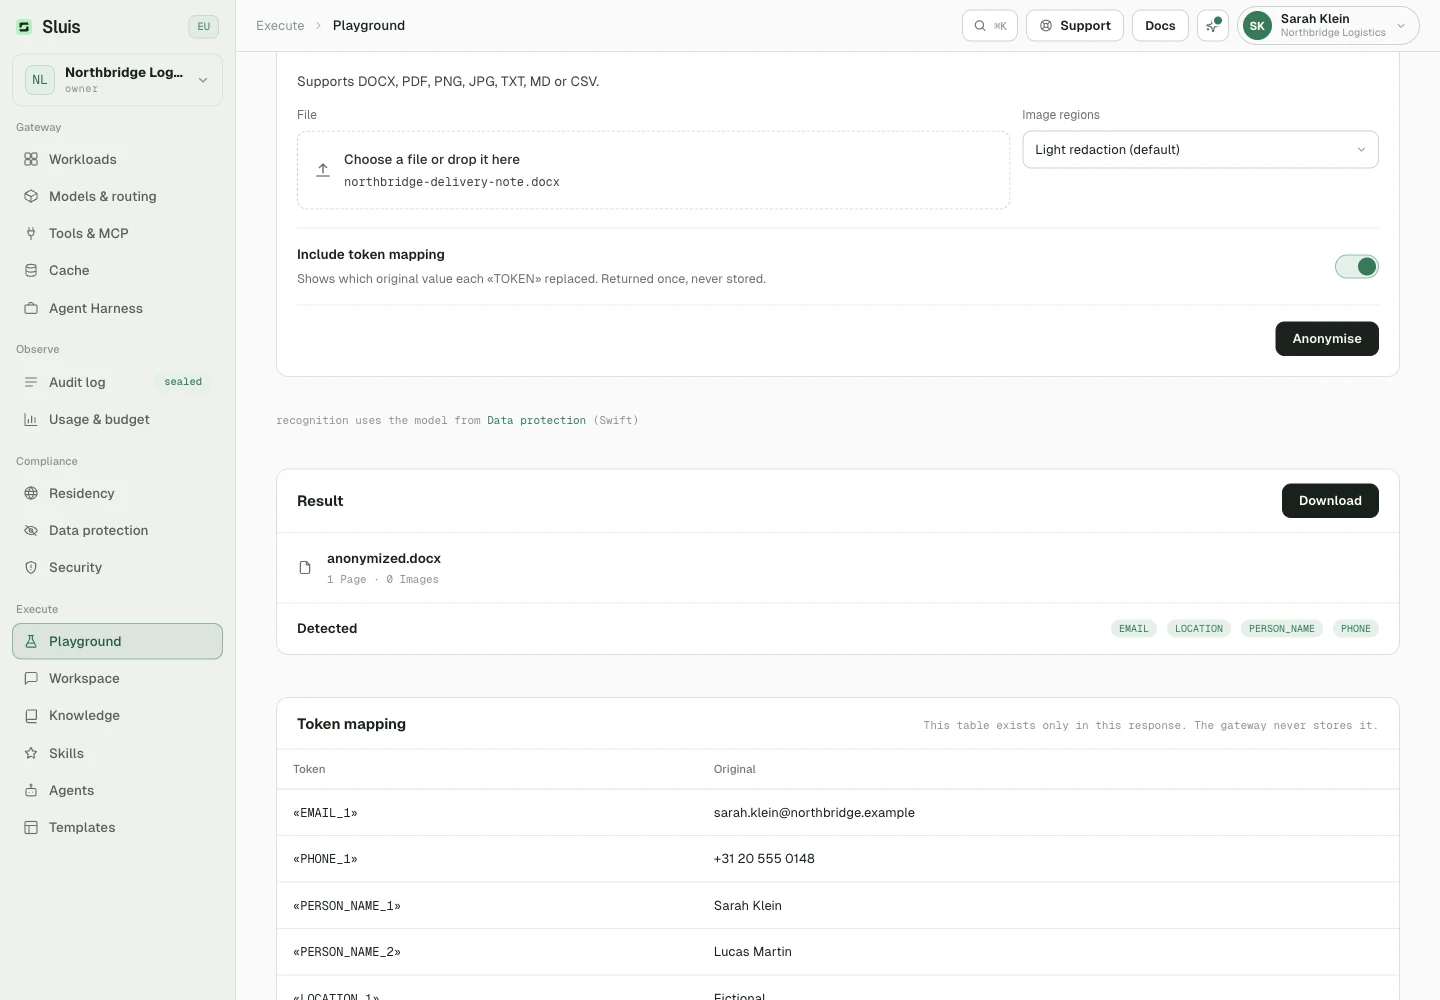
| POST / | Dokument-Anonymisierung: personenbezogene Daten werden durch «MERGE_TAG»s ersetzt, Bilder unkenntlich gemacht. Pro Seite oder Bild abgerechnet. |
| POST / | Asynchrone Anonymisierungs-Jobs: große Dokumente einreihen, /jobs/{id} abfragen und /jobs/{id}/result abholen. Der signierte Download-Link (/v1/documents/deliverables/{id}) ist zeitlich begrenzt und braucht keinen API-Key. |
| GET / | Durch Ihre Policy, Zugangsdaten und Ihren Workload erlaubte Modelle mit Typ, Kontextfenster, Fähigkeiten, Residency, Aliasziel und dem Endpreis dieser Organisation in EUR, ohne MwSt. |
| GET / | Metadaten und organisationsspezifischer Preis eines Modells, im selben Format wie die Liste. |
| POST / | Transkription, Übersetzung und Sprache, an den gerouteten Anbieter weitergereicht. Mit dem Modell sluis/transcribe führt POST /v1/audio/transcriptions die Spracherkennung von Sluis selbst aus, mit Sprechererkennung. Siehe Sprache zu Text. |
| POST / | Bildgenerierung und -bearbeitung, weitergereicht. Ausnahme ist mistral/image-generation: Mistral bietet sie nur über seinen Agent-Connector an, daher übersetzt das Gateway die OpenAI-Anfrage und antwortet mit b64_json, abgerechnet pro Bild. |
| POST / | Videogenerierung, weitergereicht. |
| / | Dateioperationen, weitergereicht mit dem eigenen Key Ihrer Organisation (BYOK oder eigener Anbieter). Ausnahme sind Dateien mit purpose=batch: Sie laufen durch die eigene Schleuse des Gateways und dürfen verwaltete Keys nutzen. |
| / | Batches im OpenAI-Format: Laden Sie eine JSONL-Datei mit purpose=batch an /v1/files hoch, dann hier erstellen, abfragen und abbrechen. Jede Zeile durchläuft Datenschutz und Residency wie ein Live-Aufruf. Ergebnisse kommen innerhalb von 24 Stunden, abgerechnet zum halben Live-Preis. Mistral, Azure, OpenAI und Qwen. |
| POST / | Anthropic Message Batches: erstellen, auflisten, abrufen, Ergebnisse und abbrechen. Aus, solange Ihre Bereitstellung sie nicht aktiviert. Sie brauchen Inhaltsaufbewahrung und laufen nur auf Anthropic-Modellen. Sonst antworten diese Routen mit 404. |
| POST / | Nativer Anthropic-Messages-Ingress: Richten Sie jedes Anthropic-SDK-Tool auf Sluis, mit jedem verbundenen Modell. |
| POST / | Lokale Token-Schätzung für das Kontextmanagement des Anthropic SDK. Nichts wird versendet. |
| GET / | Native Anthropic-Modell-Discovery (list und get), aus dem In-Process-Katalog beantwortet. Auf /v1/models wählt der Header anthropic-version dieselbe Form. |
| HEAD / | Aufwärm-Probe für Anthropic-SDK-Clients wie Claude Code: 200 mit leerem Body. |
| GET / | OpenAI-Realtime-kompatibler WebSocket für Live-Sprachdialoge (Speech to Speech) mit vertex/gemini-3.8-live, gehostet in der EU-Multi-Region auf Google Vertex AI. Auch unter /openai/v1/realtime erreichbar; der Query-Parameter model ist Pflicht. Authentifizieren Sie die Upgrade-Anfrage mit Authorization: Bearer oder x-api-key. Es spricht die GA-Eventnamen; die Beta-Formen OpenAI-Beta: realtime=v1, ephemere Client-Secrets, Browser-Subprotokoll-Schlüssel und G.711-Audio werden nicht unterstützt. Serverseitige Tools, Sitzungswiederaufnahme, Stimmreplikation und Avatar-Ausgabe werden beim Setup abgelehnt. Text wird wie an jedem Endpunkt geschützt; Audio- und Videoframes werden ungeprüft weitergeleitet. Eine Sitzung endet bei einer Ausgabenobergrenze von 2 EUR, und der Anbieter schließt eine Verbindung nach etwa 10 Minuten; verbinden Sie sich neu, um fortzufahren. Abgerechnet wird pro Token zu den Modalitätspreisen des Modells (Text, Audio, Bild- und Videoframes) laut Nutzungsbericht des Anbieters. Nicht verfügbar in Sluis Workspace, im Playground und in sluis/*-Aliasen. Die vollständige Eventliste steht im agent skill. |
| GET / | Nativer Gemini-Live-WebSocket (BidiGenerateContent), auch unter /ws/google.cloud.aiplatform.v1.LlmBidiService/BidiGenerateContent; die Version im Dienstnamen kann v1, v1beta, v1beta1 oder v1alpha sein. Ein google-genai-SDK mit dem gateway-Origin als Base-URL verbindet sich unverändert. Authentifizieren Sie die Upgrade-Anfrage mit x-goog-api-key, Authorization: Bearer oder x-api-key; der Query-Parameter ?key= wird nicht akzeptiert. Frames werden so weitergereicht, wie das Gemini-Live-Protokoll sie definiert, und setup.model ist gemini-3.8-live. Ablehnungen kommen als WebSocket-Close-Frame mit dem Grund als Text. Gleiches Modell, gleiche Limits, gleicher Datenschutz und gleiche Abrechnung wie bei /v1/realtime. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Jeder JSON-Body oben darf zusätzlich die gateway-Erweiterung sluis.remove tragen, die Begriffe benennt, die vor dem Versand aus dem Prompt pseudonymisiert werden müssen. Sie wird entfernt, bevor die Anfrage die gateway verlässt; siehe die Datenschutz-Referenz.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}
Sprache zu Text mit Sprechererkennung
Setzen Sie das Modell auf sluis/transcribe und senden Sie POST /v1/audio/transcriptions. Das Gateway führt die Spracherkennung selbst aus, ohne Abfluss an einen Anbieter.
- Senden Sie eine multipart-
filevon bis zu 240 Minuten. Die Sprache wird automatisch erkannt. response_formatistjson(Standard),textoderverbose_json(Segmente mit Sprecher).- Abgerechnet mit 0,02 € pro Audiominute, je angefangene Sekunde.
- Der DLP-Modus der Organisation gilt wie bei
sluis/ocrfür das Transkript. - Antwortet mit
503, wo die Bereitstellung keine Transkription ausführt.
# Speech to text with speaker detection, billed €0.02 per minute of audio (per started second).
# model "sluis/transcribe" runs in the gateway's own worker: no provider egress, language detected automatically.
curl https://api.sluis.ai/v1/audio/transcriptions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F model=sluis/transcribe \
  -F response_format=verbose_json \
  -F file=@meeting.m4a
{
  "task": "transcribe",
  "duration": 94.2,
  "text": "Goedemorgen allemaal.\nGoedemorgen, fijn dat jullie er zijn.",
  "segments": [
    { "id": 0, "start": 0.4, "end": 2.1, "text": "Goedemorgen allemaal.", "speaker": "speaker_1" },
    { "id": 1, "start": 2.6, "end": 5.0, "text": "Goedemorgen, fijn dat jullie er zijn.", "speaker": "speaker_2" }
  ],
  "usage": { "type": "duration", "seconds": 95 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"] }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local router contract (sluis/typed/router) | Behaviour |
|---|---|
| Model ids | sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. For your own questions, use a typesafe/jev-* model with your own TypeSafe key. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. The other rows describe sluis/typed/router only. |
| Availability | Every answer comes from verified model weights, reported as revision. If the router is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. |
| Response | JSON with model, answers, decision and revision (weights SHA256). Each answer has its type, its typed value (choice, score or noul), confidence, probabilities, legend and answer_confidence. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. |
| Data protection | Tenant DLP applies locally to the state: block refuses; tokenize or mask rewrites what the router is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The router reports no token count, so input is estimated at about 4 characters per token over the state it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local router. |
Dokumente als Eingabe
Hängen Sie ein PDF, Word-Dokument, Bild oder eine Textdatei als Content-Part "type": "file" mit einer base64-file_data-Daten-URL an eine Chat-Anfrage an.
Jedes geroutete Modell akzeptiert das. Anbieter, die File-Parts nativ verstehen, erhalten sie unverändert. Für alle anderen konvertiert das Gateway das Dokument vor dem Versand.
Wie das Modell das Dokument erhält
- Mit einem PDF-Renderer erhalten Modelle mit Bildeingabe jede PDF-Seite als
image_url-Part. Das Budget beträgt 48 Seiten pro Anfrage, geteilt über alle angehängten Dokumente, dazu können Limits des Anbieters gelten. Ohne Renderer extrahiert der Fallback der Bereitstellung den Text oder lehnt ab. - Modelle ohne Bildeingabe erhalten den extrahierbaren Text des Dokuments als Prompt-Text. Der Datenschutz-Scan deckt ihn dann wie jeden anderen Text ab.
- Längere oder schwerere Dokumente gehören auf
/v1/ocr. - Die Responses API nimmt
input_file-Parts statt der verschachteltenfile-Form der Chat Completions. - Sluis kann anbieterseitige
file_id-Referenzen weder prüfen noch auflösen. Sie gehen nur an einen Anbieter durch, der sie unterstützt, mit Ihrem eigenen Anbieter-Key und ausgeschalteter Dokumentprüfung. Sonst betten Sie die Bytes alsfile_dataein.
Datenschutz für Dokumente
- Mit aktiver
dlp_documents-Policy wird das Dokument anonymisiert oder abgelehnt, bevor etwas das Gateway verlässt. - Ist sie aus und der DLP-Modus schützend (
tokenize,maskoderblock), werden Dokumente abgelehnt, die als nicht prüfbare Bilder reisen würden. Unterallow_logpassieren sie mit einer expliziten Ungeprüft-Markierung im Audit-Trail. - Audioteile (
input_audio) können nicht gescannt werden.blockoder erforderliche KI-Erkennung bei aktiver Dokumentprüfung lehnt sie mit422ab. Sonst tragen siex-sluis-unscanned: audio.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Setzen Sie stream: true, und die Antwort kommt als Server-Sent Events. Jedes Frame ist ein chat.completion.chunk-Delta, und der Stream endet mit data: [DONE].
Streams werden im Gateway nie gepuffert: Sie werden durchgeschleust, und Audit-Siegel und Metering erfolgen selbst dann, wenn der Client früh auflegt.
Fordern Sie stream_options.include_usage an, und das Gateway verlangt vom Anbieter ein letztes Nutzungs-Frame. Sendet der Anbieter keines oder bricht der Stream ab, schätzt das Gateway die Nutzung für das Metering.
Möchten Sie sehen, was ein gestreamter Aufruf Ihre Organisation gekostet hat? Senden Sie x-sluis-include-cost: true zusammen mit stream_options.include_usage. Das letzte Nutzungsobjekt enthält dann sluis_cost_eur, siehe Kosten eines Aufrufs.
Bedrock trennt Überlegungen mit reasoning_content und reasoning_signature von der Antwort, auch in Streaming-Deltas. Ablehnungen verwenden finish_reason: content_filter, Ausgabelimits length, auch bei unvollständigen Tool-Aufrufen. Führen Sie keine unvollständigen Tool-Argumente aus. AWS-Streaming-Ausnahmen werden zu Fehler-Frames ohne sensible Details.
Keepalive, Header und Neustarts
- Nach 15 Sekunden ohne Frame schreibt das Gateway zwischen den Events eine SSE-Kommentarzeile (
: keepalive), damit Proxys mit Leerlauf-Timeout die Verbindung offen halten, während ein Modell nachdenkt. SSE-Clients ignorieren sie. - Streams tragen
Cache-Control: no-cacheundX-Accel-Buffering: no. - Startet eine Gateway-Replik neu, bedient sie offene Streams noch bis zu fünf Minuten. Ein danach noch offener Stream endet mit einem Fehler-Event mit dem Code
server_restarting, wiederholen Sie dann die Anfrage. - Tokenisierte Streams akzeptieren einzelne Events bis 4 MiB. Größere Events beenden den Stream mit einem Fehler.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Reasoning
Übergeben Sie den OpenAI-Parameter reasoning_effort (minimal | low | medium | high) bei jedem Modell mit Thinking-Fähigkeit. Sluis übersetzt ihn je Anbieter (Geminis Thinking-Level, Claudes adaptiver Thinking-Effort) und lässt ihn weg, wo ein Modell ihn ablehnen würde, sodass ein einziger Parameter über den gesamten Katalog funktioniert.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Prompt-Caching
Wiederkehrende Prompt-Präfixe (System-Prompts, Tools, Gesprächsverlauf) können beim Anbieter gecacht werden, um Kosten und Latenz zu senken. Sluis übersetzt Anthropic-artige cache_control-Blöcke (optionale TTL 5m oder 1h) sowie OpenAIs prompt_cache_key und prompt_cache_retention auf oberster Ebene je Anbieter.
Mehrere System- oder Assistant-Cachegrenzen können bei der Übersetzung zusammenfallen, auch bei unterschiedlichen TTLs.
| Anbieter | Prompt-Cache-Verhalten |
|---|---|
| Anthropic | Explizites cache_control auf System-Blöcken, Nachrichteninhalten und Tools, einschließlich TTL. Lesen und Schreiben werden getrennt gemeldet. |
| Bedrock | cache_control wird zu Converse-cachePoint-Blöcken in system, messages und toolConfig. |
| OpenAI · Azure | Automatisches Caching. Nach Aktivierung bleiben prompt_cache_key und prompt_cache_retention für Chat und Responses erhalten; nicht unterstützte Optionen und Marker werden entfernt. |
| Gemini · Vertex | Implizites Gemini-Caching und dessen Nutzungsdaten funktionieren; explizite cachedContent-Referenzen werden nicht unterstützt. Claude auf Vertex übersetzt cache_control und TTL wie Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Automatisches Caching, sofern angeboten; alle expliziten Direktiven werden entfernt. Moonshots natives usage.cached_tokens wird erkannt. |
| Scaleway | Automatisches Caching, sofern angeboten; alle expliziten Direktiven werden entfernt. Lesen nutzt den offiziellen Scaleway-EUR-Tarif für Cache-Eingaben, sofern verfügbar, nicht LiteLLM. |
| Nebul | Automatisches Caching, sofern angeboten; alle expliziten Direktiven werden entfernt. Lesen nutzt den offiziellen EUR-Tarif für Cache-Eingaben, sofern verfügbar. |
| Nebius · nebius-eu | Automatisches Caching, sofern angeboten; alle expliziten Direktiven werden entfernt. Offizielle Live-Preise übernehmen keine LiteLLM-Cache-Rabatte; ohne offiziellen Modellpreis kann der LiteLLM-Fallback einen Cache-Tarif liefern. |
| Custom | Nach Aktivierung durch die Organisation werden Direktiven unverändert übermittelt; die Unterstützung liegt beim Betreiber. |
Explizites Prompt-Caching ist Opt-in
Explizites Prompt-Caching ist eine Einstellung der Organisation (provider_prompt_cache). Es ist standardmäßig aus und unabhängig von der Sluis-Inhaltsaufbewahrung und vom exakten Antwort-Cache. Aktivieren Sie es unter Console › Datenschutz.
- Gecachte Präfixe bleiben beim Anbieter, nachdem der Sluis-Datenschutz sie gefiltert hat.
- Ist es aus, entfernt die Schleuse
prompt_cache_key,prompt_cache_retention,prompt_cache_options,cache_controlundprompt_cache_breakpoint. Das automatische Caching des Anbieters selbst wird dadurch nicht abgeschaltet. - Ohne eigenen Key für einen Anbieter laufen Aufrufe über ein Sluis-Zugangsdatum, das sich andere Organisationen teilen. Bei OpenAI und Azure setzt Sluis einen aus Ihrer Organisation abgeleiteten
prompt_cache_keyan die Stelle Ihres eigenen. Bei jedem anderen Anbieter zeigen die Cached-Token-Zahlen in Ihrer Nutzung 0. Die Abrechnung wendet trotzdem den echten Cache-Rabatt an.
Abrechnung und Limits
- Cache-Lese- und Schreibmengen sind Teil der gesamten Prompt-Token, keine zusätzliche Eingabe. Lesen nutzt den verfügbaren Cache-Tarif.
- Anthropic-1h-Schreibvorgänge nutzen den TTL-Tarif, wenn Nutzungsaufschlüsselung und Tarif vorliegen. Sonst gilt der Standard-Erstellungstarif.
- Ohne Cache-Tarif gilt der normale Eingabetarif, niemals Nullabrechnung.
- Die Cache-Nutzung erscheint im Audit-Drawer und unter Nutzung & Budget.
- Lange Prompts werden zum Long-Context-Tarif des Anbieters abgerechnet. Überschreitet der Prompt (gecachte Tokens eingeschlossen) die Schwelle des Modells, wird der gesamte Aufruf zu diesem Tarif abgerechnet. Er steht in der Modelltabelle unter dem Preis.
Bei einem von Sluis verwalteten Key weist Sluis eine Anfrage mit 400 ab, bevor etwas gesendet wird, wenn sie einen Aufschlag wählt, den Sluis nicht messen kann:
- eine
cache_control-ttlaußer5m, wo der Anbieter sie berücksichtigt (Anthropic, Bedrock, Claude auf Vertex) - ein
service_tieraußerauto,default,flexoderstandard_only - die Anthropic-Long-Context-Beta (
context-1m) auf einem Modell, für das Sluis keinen Long-Context-Tarif hat
Ihr eigener Anbieter-Key leitet alle drei unverändert weiter.
Fehlercodes
Fehler verwenden das OpenAI-Fehler-Envelope; der Wert error.type spiegelt den HTTP-Status, sodass die Fehlerbehandlung Ihres SDK unverändert weiterarbeitet.
| Code | Wann |
|---|---|
| 400 invalid_request_error | Fehlerhafter Request-Body oder fehlerhafte Parameter. |
| 400 invalid_request_error | Modell-ID ohne Anbieter-Präfix. Jede aufrufbare ID ist provider/model, zum Beispiel mistral/mistral-large-latest. Die Meldung lautet: model must be provider-prefixed. |
| 400 invalid_request_error | Die Anfrage trägt den entfernten Header x-sluis-dlp. Overrides pro Anfrage wurden durch Option-Overrides pro Workload ersetzt: Konfigurieren Sie sie unter Console › Workloads. |
| 401 authentication_error | Fehlender oder unbekannter API-Key. |
| 402 insufficient_quota | Kein aktiver Plan oder Budget erreicht. Aktivieren Sie einen Plan oder erhöhen Sie das Budget. Die Anfrage erreicht nie einen Anbieter. |
| 403 permission_error | Dem Key fehlt die Berechtigung, zum Beispiel weil das Modell nicht auf der Allow-List des Workloads steht. |
| 422 invalid_request_error | Vor dem Versand abgewiesen, zum Beispiel weil der Datenschutz im Modus block die Anfrage erfasst hat. |
| 422 document_too_large_to_scan | Ein Dokument ist zu groß für den gewählten Weg: eine Seite, die selbst bei der minimalen Scan-Auflösung über der Render-Pixelgrenze bleibt, oder eine Datei über der Byte-Grenze der Textextraktion. Großformatige Seiten (A0- und A1-Zeichnungen) werden automatisch herunterskaliert. Verkleinern oder teilen Sie das Dokument und senden Sie es erneut. |
| 429 rate_limit_error | Rate-Limit erreicht. Am Gateway durchgesetzt, die Anfrage erreicht also nie einen Anbieter. |
| 403 permission_error | Durch die Residency-Policy blockiert: Keine erlaubte Jurisdiktion bedient die Anfrage. Der Body enthält den Grund. |
| 403 scope_violation | Vom Scope-Guard des Workloads im Modus block abgewiesen: Der Aufruf liegt außerhalb des für diesen Workload festgelegten Einsatzbereichs. Die Meldung nennt den Grund des Guards, und die Anfrage erreicht nie einen Anbieter. |
| 422 malware_detected | Die hochgeladene Datei entsprach einer Malware-Signatur und wurde abgelehnt, bevor sie gespeichert oder verarbeitet wurde. Der Name der Signatur wird nie zurückgegeben. |
| 503 pdf_renderer_unavailable | Ein eingebettetes PDF musste als Seitenbilder gesendet werden, weil das geroutete Modell Bildeingaben liest, aber diese Bereitstellung hat keinen PDF-Renderer. Die Anfrage wird abgelehnt, statt aus extrahiertem Text beantwortet zu werden, was alles verwerfen würde, was eine Zeichnung oder ein Scan zeigt. |
| 503 malware_scan_unavailable | Die hochgeladene Datei konnte nicht auf Malware geprüft werden (Scanner nicht erreichbar oder langsam, oder die Datei überschreitet das Scanlimit von 100 MiB) und wurde deshalb nicht angenommen. Es wurde nichts gespeichert. Versuchen Sie es mit Backoff erneut. |
| 503 scope_guard_unavailable | Der Scope-Guard des Workloads steht auf block, konnte aber kein Urteil fällen, deshalb wird der Aufruf abgewiesen, statt durchgelassen zu werden. Mit Backoff erneut versuchen. |
| 503 auth_unavailable | Das Gateway konnte seinen Key-Speicher nicht lesen und deshalb den Key nicht prüfen. Der Key ist nicht als ungültig bekannt. Versuchen Sie es mit Backoff erneut und beachten Sie Retry-After. |
| 504 api_error | Der Anbieter hat nicht innerhalb der Antwortfrist des Workloads geantwortet: standardmäßig 300 Sekunden, 10 bis 600, wenn der Workload sie festlegt, kürzer, wenn die Anfrage x-sluis-upstream-timeout sendet. error.sluis.cause ist timeout. Das Gateway hat den Aufruf nicht wiederholt, weil der Anbieter ihn noch ausführen kann. Kürzen Sie den Prompt oder bitten Sie um eine längere Frist, bevor Sie erneut senden. |
| 5xx api_error | Ausfall des Upstream-Anbieters nach Wiederholungsversuchen. Der Circuit Breaker lenkt den Traffic an fehlerhaften Anbietern vorbei. Der Body enthält die Meldung des Anbieters selbst sowie ein error.sluis-Objekt, das die Ursache und jeden Versuch nennt, mit Upstream-Status oder Transportfehler und Dauer. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. \"mistral/mistral-large-latest\"",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model not permitted for this API key",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}Anthropic Messages API
Sluis spricht die Anthropic Messages API nativ. Richten Sie Claude Code oder ein beliebiges Anthropic-SDK auf das Gateway und rufen Sie POST /v1/messages auf. /anthropic/v1/messages ist der eindeutige Pfad mit Präfix auf denselben Handler.
Die Anfrage wird in die interne Form übersetzt, durchläuft dieselbe Pipeline aus Inspect, Route, Seal und Meter wie jeder andere Aufruf und kommt in Anthropics Format zurück, Streaming inbegriffen.
Authentifizierung
- Senden Sie Ihren Sluis-Key im Anthropic-Header
x-api-keyoder im üblichen HeaderAuthorization: Bearer. Beides wird akzeptiert. - Der Header
anthropic-versionwird mit jedem Wert akzeptiert und nie verlangt. BeiGET /v1/modelswählt sein Vorhandensein die Anthropic-Form. - Das Parsing ist bewusst offen: Unbekannte Body-Felder, unbekannte Content-Block-Typen, unbekannte
anthropic-beta-Werte und die Query?beta=true, die Claude Code sendet, werden toleriert, nicht abgewiesen. - Beta-Flags gehen Byte für Byte an Upstreams der Anthropic-Familie und werden überall sonst ignoriert.
Endpoints
| Endpunkt | Zweck |
|---|---|
| POST / | Messages, gepuffert oder streamend. Unterstützt System-Prompts (String oder Blöcke), Tools und Tool-Ergebnisse (einschließlich Fehlerergebnissen und darin enthaltener Bilder), Bilder, Dokumentblöcke, thinking- und redacted_thinking-Blöcke im Verlauf sowie cache_control-Marker an jeder cachefähigen Stelle. |
| POST / | Lokale Token-Schätzung für das Kontextmanagement des SDK. Nichts wird versendet, aufbewahrt oder gemessen. |
| GET / | Native Modell-Discovery in Anthropics Form, aus dem In-Process-Katalog beantwortet. Auf dem Root-Pfad wählt der Header anthropic-version diese Form, ohne ihn erhalten Sie die OpenAI-Form. Unter /anthropic gilt sie immer. Die Cursor before_id, after_id und limit gelten nach bestem Bemühen, und created_at ist ein fester Platzhalter, weil der Katalog kein Veröffentlichungsdatum pro Modell kennt. |
| HEAD / | Die Aufwärm-Probe, die Claude Code vor einer Sitzung sendet: nur HEAD, beantwortet mit 200 und leerem Body. |
Modell-Routing
Das Wire-Format schränkt das Modell nie ein: Der Ingress ist ein Codec, und die Modell-ID bestimmt die Route.
- Eine blanke ID wie
claude-sonnet-5wird über den Standardanbieter dieses Ingress aufgelöst,anthropic, es sei denn, Ihre Organisation verweist ihn woandershin (zum Beispiel aufvertexfür in der EU gehostetes Claude). Die Residency-Schleuse entscheidet weiterhin, ob dieses Ziel die Anfrage bedienen darf. - Legen Sie ein Ziel explizit mit einer ID mit Anbieter-Präfix fest, etwa
vertex/claude-opus-4-8. - Oder übergeben Sie einen
sluis/*-Alias. Dann läuft ein Anthropic-SDK-Tool bei jedem verbundenen Anbieter, innerhalb Ihrer Policy.
Streaming
Mit "stream": true ist die Antwort die vollständige Anthropic-Event-Grammatik:
message_start, danncontent_block_start,content_block_deltaundcontent_block_stopfür jeden Block, dannmessage_deltamit kumulierter Nutzung (einschließlich Cache-Lese- und Erstellungs-Tokens), dannmessage_stop.- Text kommt als
text_delta, Tool-Argumente alsinput_json_deltaund Reasoning alsthinking_deltaplussignature_delta, wenn der geroutete Anbieter es erzeugt hat. message_startträgt die Zahl der Eingabe-Tokens, wenn der Anbieter sie in seinem ersten Chunk meldet. Sonst beginnt sie bei null, undmessage_deltameldet die aktualisierte Nutzung.- Ein
ping-Event folgt aufmessage_startund wiederholt sich nach etwa 15 Sekunden Upstream-Stille, damit ein langer Thinking-Zug nie den Watchdog eines Clients auslöst. - Ein Fehler mitten im Stream wird als
error-Event neu kodiert, statt einen abgeschnittenen Stream zu liefern. stop_sequenceträgt die getroffene Sequenz, wenn die Antwort von einem Anbieter der Anthropic-Familie kam, und ist sonst null.- Senden Sie
x-sluis-include-cost: true, und die Nutzung inmessage_deltaenthält auchsluis_cost_eur, den Preis des Aufrufs für Ihre Organisation in EUR, sowiesluis_cost_estimated: truenur bei einer Schätzung. Siehe Kosten eines Aufrufs.
# native Anthropic Messages: the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true: the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Fehler
Fehler der Messages-Handler nutzen das Envelope von Anthropic: ein "type": "error" auf oberster Ebene mit dem Fehlertyp des Anbieters. Das gilt auch für Abweisungen, die nie ein Modell erreichen, etwa ein unbekannter Key oder eine Datenschutz-Blockade.
Die Typen sind invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error und overloaded_error.
- Die Antwort trägt einen
request-id-Header und einrequest_id-Body-Feld, die Korrelations-ID für Ihren Client. - Hat der Aufruf eine Audit-Zeile erzeugt, kennzeichnet der Header
x-sluis-request-iddiese Zeile. Ein Authentifizierungsfehler hat keine Audit-Zeile. - Vom Gateway behandelte HTTP-5xx-Antworten tragen zusätzlich eine eigene Diagnose-ID
x-request-id. Eine sichere, vom Client gesendete ID wird auch bei anderen Antworten zurückgegeben. Fehler eines vorgeschalteten Proxys sind davon ausgenommen. - Abweisungen auf Gateway-Ebene, die vor dem Handler passieren, etwa Ledger-Backpressure oder Überlast, können in der OpenAI-Fehlerform zurückkommen.
# failures from the Messages handlers are Anthropic-shaped: auth and
# data-protection refusals included
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "`mcp_servers` is not supported: an external MCP server reached from the model would bypass the Sluis tool gate. Register the server with Sluis and call it through the compliance-native MCP gateway (`/v1/mcp`), which audits and meters every tool call."
  },
  "request_id": "req_4c81…"
}
Ein nicht leeres mcp_servers-Array wird mit 400 invalid_request_error abgewiesen, statt weitergereicht zu werden. Ein Modell, das selbst einen externen MCP-Server aufruft, läge außerhalb der Sluis-Schleuse. Registrieren Sie den Server stattdessen in der Console und rufen Sie seine Tools über das MCP-Gateway auf, wo jeder ausgeführte Tool-Aufruf geprüft, geroutet, versiegelt und gemessen wird.
Kompatibilitätsmatrix
Was die nativen Ingresse heute abdecken, Endpoint für Endpoint. Diese Tabelle ist die Aussage: was hier nicht als unterstützt steht, ist Roadmap, wird bewusst abgewiesen oder gehört zu einer anderen Produktoberfläche, nie stillschweigend angedeutet.
| Anthropic | Status | Hinweise |
|---|---|---|
| POST / | ✓ nativ | Gepuffert und streamend, Tools, Bilder, Dokumentblöcke, Thinking-Round-Trip und Prompt-Cache-Marker. |
| POST / | ✓ lokale Schätzung | Lokal beantwortet. Nichts wird versendet. |
| GET / | ✓ nativ | Native list- und get-Form aus dem In-Process-Katalog. Auf dem Root-Pfad per Header verhandelt, unter /anthropic bedingungslos. |
| HEAD / | ✓ | Die Aufwärm-Probe von Claude Code, nur HEAD. |
| Message Batches | ✓ Opt-in | Verfügbar, wenn Ihre Bereitstellung sie aktiviert: erstellen, auflisten, abrufen, Ergebnisse und abbrechen, für Modelle, die auf Anthropic aufgelöst werden. Sonst 404. Nutzen Sie für andere Anbieter das OpenAI-förmige /v1/batches. |
| Files | ✗ Roadmap | Die Files API ist nicht gebrückt. Inline-Dokumentblöcke und file_data decken den üblichen Weg ab. |
| mcp_servers | ✗ abgewiesen | Ein nicht leeres Array wird mit 400 abgewiesen, statt weitergereicht zu werden. Registrieren Sie den Server und nutzen Sie das Sluis-MCP-Gateway. |
| Skills · Agents · Admin | ✗ außerhalb des Umfangs | Skills, Managed Agents und die Admin-, Nutzungs- und Kosten-APIs sind eine andere Produktoberfläche, keine Inferenz-Kompatibilität. |
Routing über Protokollgrenzen
Anbieterspezifische Felder bleiben erhalten, solange die Anfrage bei einem Anbieter landet, der dasselbe Protokoll spricht. Eine Anthropic-Anfrage, die ein Anbieter der Anthropic-Familie bedient, behält ihre Thinking-Blöcke, Cache-Marker, Beta-Flags und die getroffene stop_sequence.
Bei Routing über Protokollgrenzen werden diese Felder beim Versand verworfen und nie am Ingress abgewiesen. Die Audit-Zeile hält Wire-Format und aufgelösten Anbieter fest, sodass sich jeder Qualitätsverlust zuordnen lässt.
Opake Werte werden nie umgeschrieben: Thinking-Signaturen und redacted_thinking-Payloads werden unverändert oder gar nicht weitergereicht. Deshalb wird auch ein geparkter Thinking-Block, den der Datenschutz-Scan beanstandet, verworfen statt maskiert: Ein umgeschriebener Block trüge eine ungültige Signatur.