Ochrona danych
Tryby wykrywania, biblioteka 60 detektorów, wykrywanie encji z modelami do wyboru, skanowanie bezpieczeństwa, powiadomienie modelu i retencja.
Ochrona danych działa na każdym żądaniu przed wysyłką. Domyślny tryb to tokenize: każda wykryta wartość jest zamieniana na stabilny typizowany token, taki jak «EMAIL_1». Wykryte wartości trafiają do dostawcy wyłącznie jako tokeny, a w drodze powrotnej do Ciebie odpowiedź jest przywracana do prawdziwych wartości, niezależnie od tego, czy jest strumieniowana. Mapa tokenów żyje w pamięci przez czas trwania żądania i nigdy nie jest utrwalana. Pseudonimizacja działa w jedną stronę: chroni to, co wysyłasz. W Sluis Workspace publiczne wyniki wyszukiwania w sieci i wcześniejsza odpowiedź modelu z tej samej tury nie są ponownie tokenizowane; wartość, którą rozmowa już stokenizowała, pozostaje zastąpiona swoim tokenem, a dziennik audytu odnotowuje, kiedy to zastosowano.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives — only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back — restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Inne tryby: mask nieodwracalnie przepisuje wykryte wartości, block odrzuca żądanie z kodem 422, a allow_log przepuszcza je, oznaczając wpis w audycie.
60 wbudowanych detektorów działa od ręki: 28 dla danych osobowych, od amerykańskiego numeru SSN po pakiet krajowych numerów identyfikacyjnych z walidacją sumą kontrolną dla 12 krajów UE, oraz 32 dla sekretów i poświadczeń. Każdy można włączać per organizacja, a terminy własne (zwykłe lub regex) obejmują wszystko, co specyficzne dla Twojej firmy:
Wykrywanie encji
Osoby, organizacje i miejsca trudno wykrywać samymi wzorcami. Sluis łączy heurystyki kontekstowe, korelację e-mail, katalog tenanta, dostarczane słowniki i opcjonalne NER. Model NER działa jako wewnętrzny sidecar: tekst pozostaje w obrębie wdrożenia. Te warstwy analizują też tekst wyodrębniony z dokumentów i przez OCR, gdy ochrona dokumentów jest włączona. Przy włączonym NER jedno żądanie może zawierać do 100 000 różnych encji; powyżej tego limitu skan uznaje się za niepełny. Nazwa wykryta przez model raz jest zastępowana wszędzie, gdzie powtarza się w żądaniu, jako to samo całe słowo z tą samą wielkością liter i tym samym tokenem, także w wiadomościach, w których model jej nie wskazał. Pojedyncze ogólne słowa i krótkie skróty obejmują tylko wystąpienie wskazane przez model.
Słownik nazwisk to deterministyczny odpowiednik NER: imiona i nazwiska skompilowane z rządowych danych otwartych w słownik dostarczany wewnątrz bramy. Wychwytuje pełne imiona i nazwiska oraz nazwiska poprzedzone tytułem grzecznościowym, bez dodatkowych opóźnień i bez wysyłania czegokolwiek poza Twój perymetr. Nazwiska będące zarazem zwykłymi wyrazami są wychwytywane tylko w kontekście o kształcie nazwiska; rzadkie nazwiska pozostają zadaniem katalogu lub NER.
Modele NER do wyboru
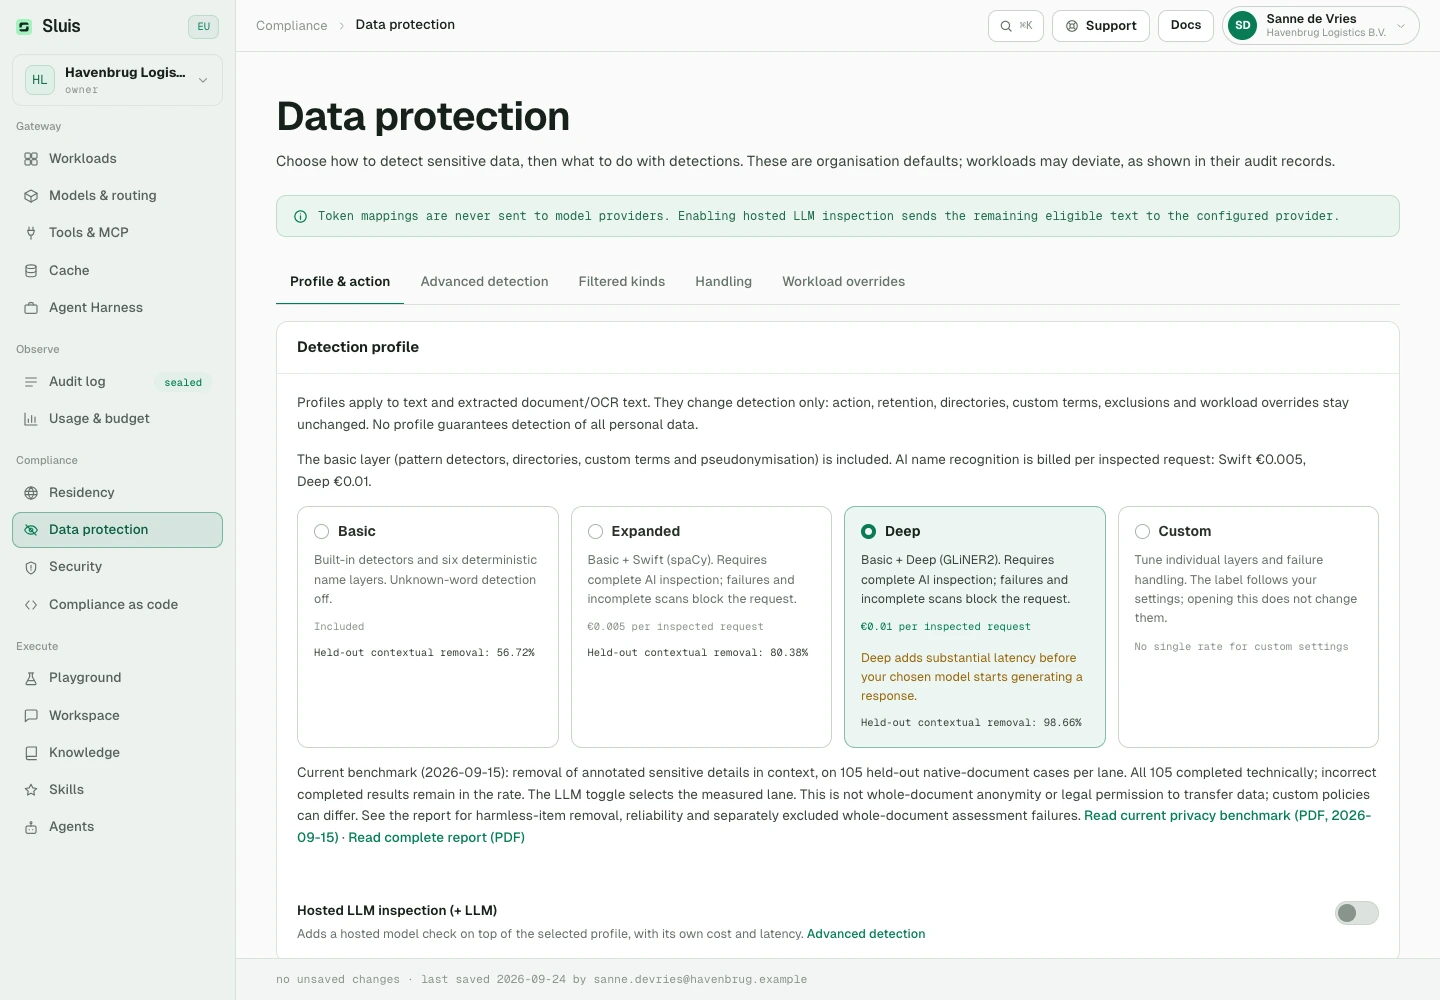
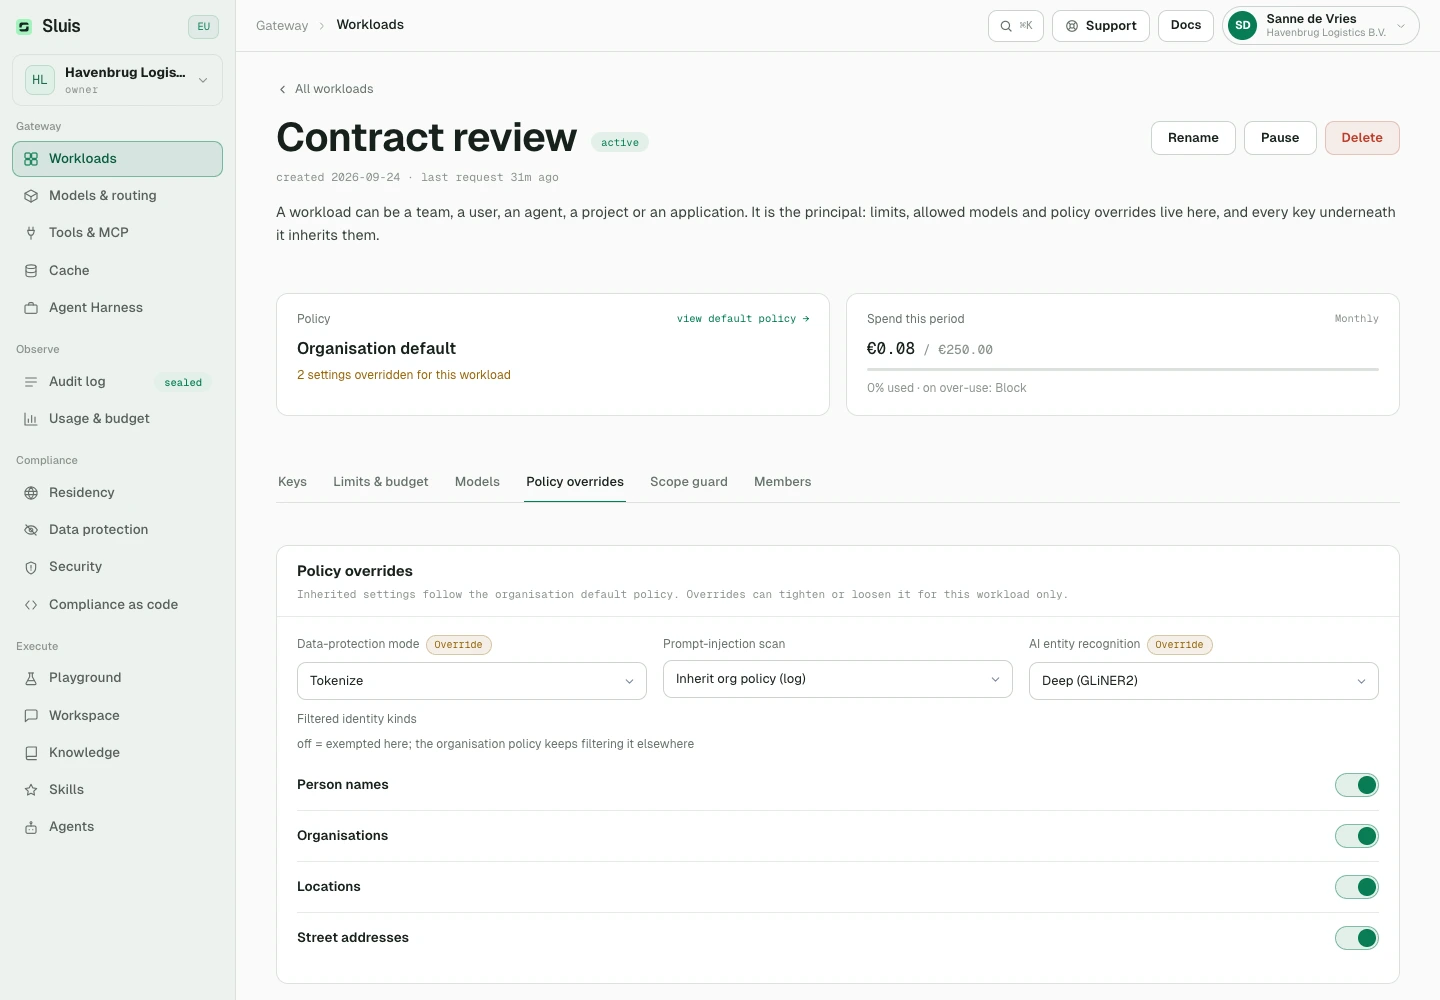
W Ochronie danych wybierz Podstawowy, Rozszerzony lub Dogłębny. Podstawowy używa wbudowanych detektorów i sześciu deterministycznych warstw nazw, bez wywołania modelu; to ustawienie nowych organizacji. Rozszerzony dodaje Swift (spaCy), a Dogłębny zamiast niego GLiNER2-PII. Oba profile AI wymagają pełnej inspekcji i blokują błędy modelu lub niepełne skany. Dogłębny wymaga więcej obliczeń, ale nie gwarantuje wyższej czułości. Własny pozwala dostosować poszczególne ustawienia. Istniejące polityki, wyłączenia, katalogi i odstępstwa workloadów pozostają bez zmian; nieznane słowa są wyłączone we wszystkich trzech profilach. Workload nie może włączyć NER, jeśli organizacja je wyłącza. Rozpoznawanie nazw przez AI jest rozliczane raz za każde sprawdzone żądanie klienta: 0,005 € ze Swift (Rozszerzony), 0,01 € z GLiNER2 (Dogłębny); Podstawowy jest w cenie. Kolejne wywołania, które Sluis wykonuje w ramach tego żądania, nie są rozliczane ponownie, a niepełna inspekcja nic nie kosztuje. Każda opłata to powiązane potwierdzenie audytu, które wlicza się do Twoich budżetów.
Dogłębny znacznie wydłuża oczekiwanie, zanim wybrany model zacznie generować odpowiedź. Czas skanowania Swift i GLiNER2 zależy od długości tekstu, liczby wiadomości i sprzętu. Limit obejmuje cały skan NER wiadomości, załączników i okien jednego żądania, nie każde okno osobno: 30 sekund do 320 000 znaków, plus 30 sekund za każde kolejne 320 000 znaków, najwyżej 10 minut. To maksimum, nie typowe opóźnienie. Opcjonalna hostowana inspekcja LLM dodaje oddzielny czas oczekiwania przed generowaniem odpowiedzi, zależny od tekstu, obciążenia dostawcy i ponowień; nie obejmuje go ten limit NER.
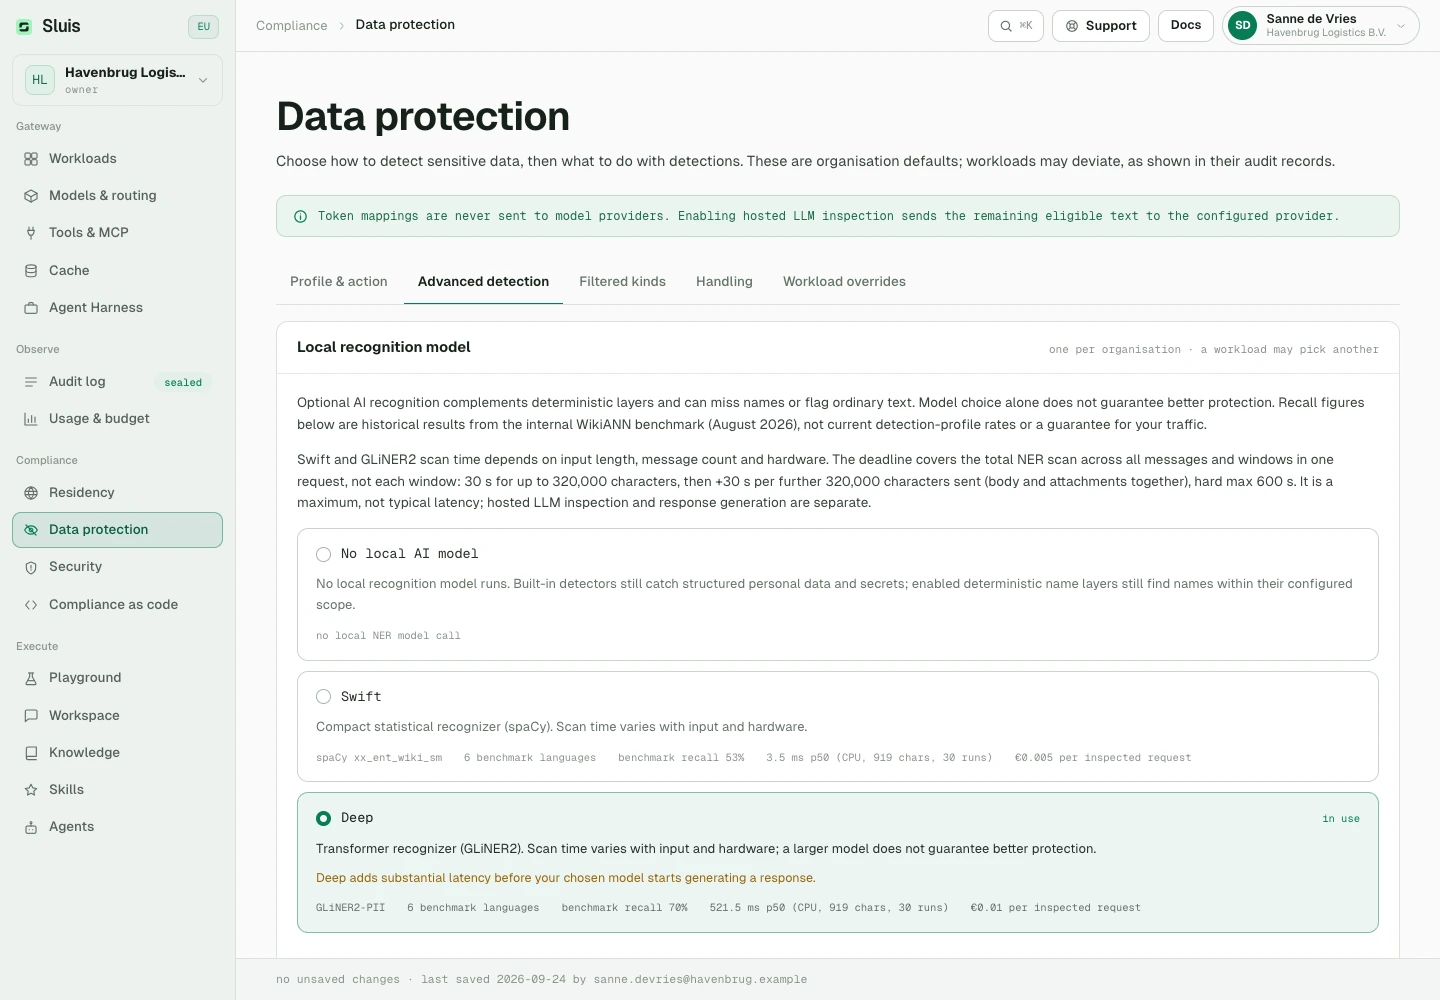
| Model | Pokrycie | Zmierzona dokładność | Opóźnienie |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Zmierzono 2026-08-12 na wewnętrznym benchmarku: zdania testowe WikiANN w sześciu językach (NL, EN, DE, FR, ES, IT; 150 na język), oceniane jako mikro-F1 na parach (etykieta, tekst) na poziomie tekstu z zastosowanym produkcyjnym filtrem fałszywych trafień, na deweloperskiej maszynie Apple Silicon w FP32. WikiANN to automatycznie anotowany materiał z Wikipedii i teren treningowy spaCy: czytaj te liczby jako względną wskazówkę między poziomami, nie jako absolutną dokładność w terenie.
Skanowanie bezpieczeństwa
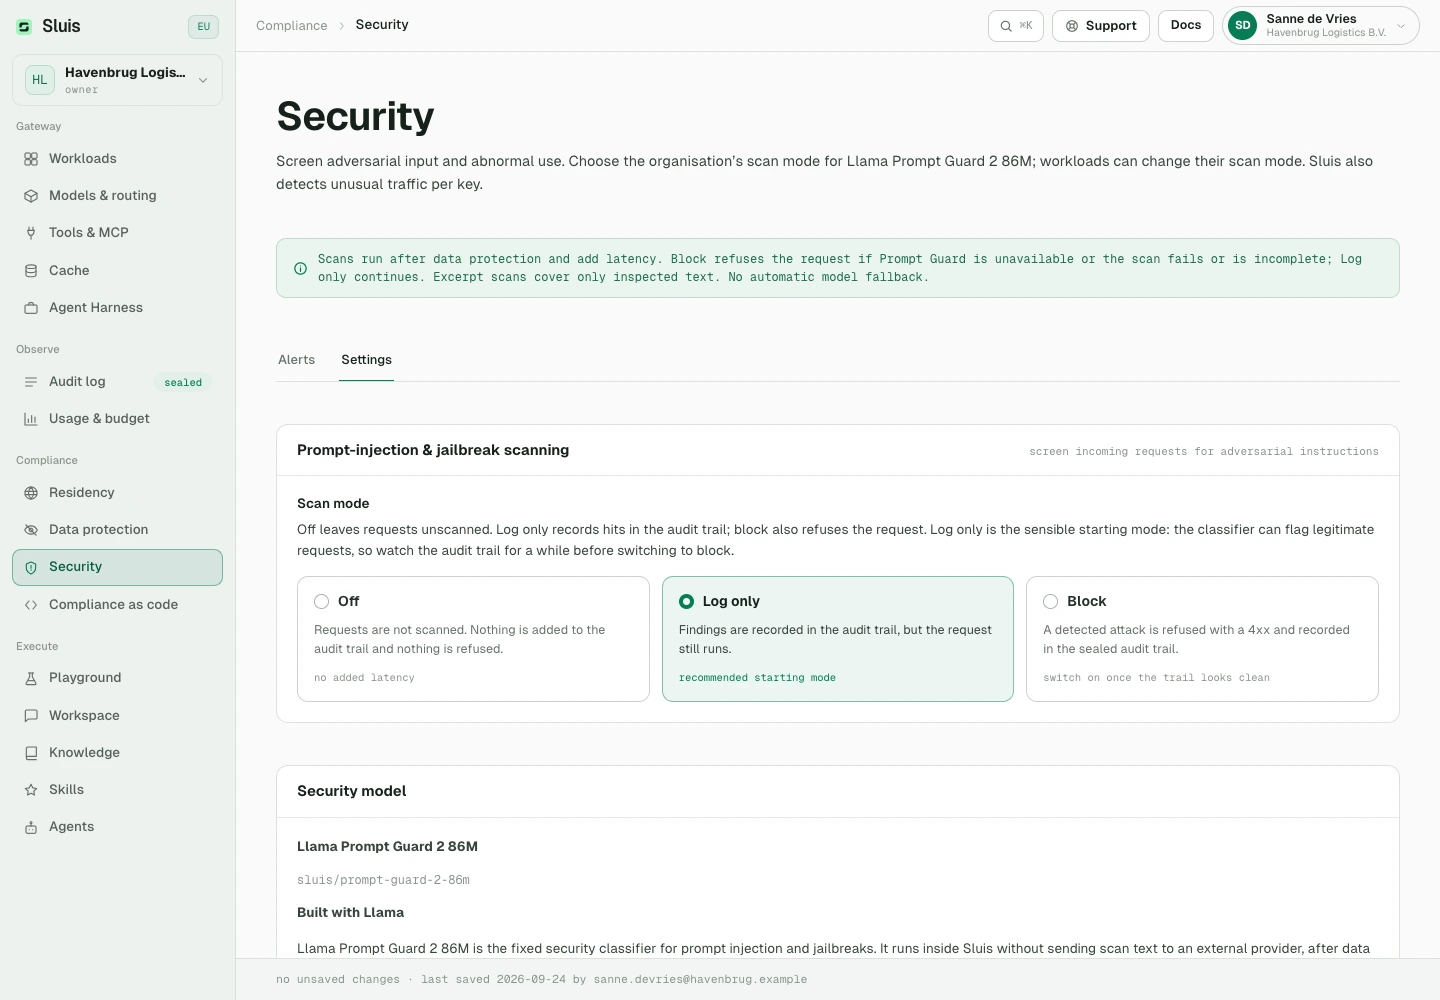
Opcjonalne wykrywanie prompt injection i jailbreaków przy śluzie, analizowane przed wysyłką. Trzy tryby: off | log | block. off pomija skan. log zapisuje wykrycia bez blokowania ruchu. block odrzuca wykryte ataki i blokuje, gdy model jest niedostępny lub klasyfikacja jest błędna albo niepełna. Bez automatycznej zmiany modelu.
Bezpieczeństwo zawsze korzysta z Llama Prompt Guard 2 86M (sluis/prompt-guard-2-86m), wewnątrz Sluis bez wysyłania tekstu na zewnątrz. 0,01 EUR za ukończony skan logiczny, jeden raz niezależnie od okien i wyniku, także dla bezpiecznych próbek; bez dopłaty za tokeny. Tryb wyłączony, odmowy wstępne i błędy techniczne nie są płatne. Nakładające się okna do 512 tokenów modelu zachowują granice segmentów, w całkowitym budżecie od 4096 do 65536 tokenów. Stały próg wynosi 0,8. Skan działa po ochronie danych, która może zachować dane osobowe, gdy jest wyłączona lub tylko rejestruje. Skany zwiększają opóźnienie i mają ograniczony czas. Długie dane używają fragmentów; bezpieczny wynik obejmuje tylko sprawdzony tekst. Audit zapisuje sprawdzone i wszystkie bajty. Built with Llama. Meta Llama 3.1 Community License.
Każdy skan ma osobny, powiązany płatny wpis audytu: security.scan. Opłaty mogą wystąpić również po zablokowaniu żądania lub obsłużeniu go z pamięci podręcznej. Wyjątki dla kluczy mogą zmieniać tryb skanu. Osobna opcjonalna inspekcja prywatności Nemotron korzysta z Nebul zgodnie z polityką rezydencji i jest rozliczana za tokeny.
Osobno opcjonalne wykrywanie anomalii zachowania kluczy działa jako zadanie w tle, bez żadnego opóźnienia żądań: linie bazowe per klucz z odpornych statystyk z sezonowością godzina-tygodnia, plus wielowymiarowa warstwa isolation forest. Alerty są wyjaśnialne, nigdy goły wynik, i trafiają do widoku Bezpieczeństwo w Konsoli, opcjonalnie e-mailem.
Powiadomienie dla modelu
Gdy tokenizacja przepisała żądanie, Sluis wstrzykuje na początku wiadomość systemową informującą model, że tokeny «…» to nieprzezroczyste symbole zastępcze, które musi zachować w nienaruszonym stanie; to właśnie zapewnia niezawodne przywracanie. Domyślnie włączone; dostosuj lub wyłącz per organizacja.
Retencja i wierność audytu
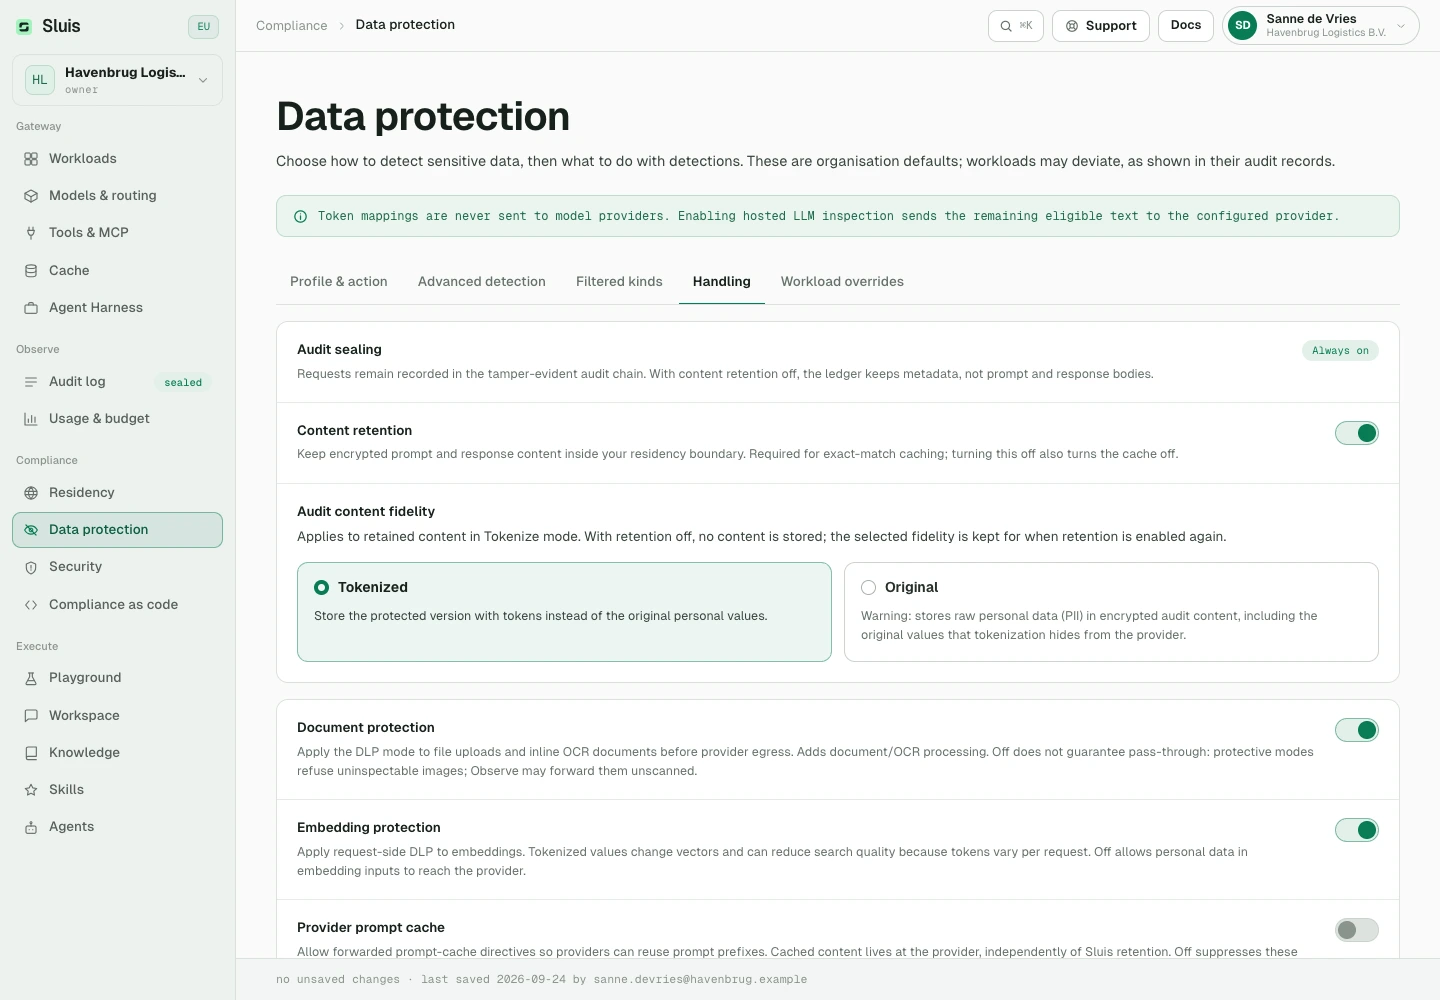
Retencja treści (body żądań i odpowiedzi dla dziennika audytu) jest domyślnie włączona i szyfrowana w spoczynku; wierność audytu decyduje, czy zachowana treść przechowuje tokeny, czy wartości oryginalne. Zachowana treść jest przechowywana do momentu jej usunięcia, chyba że ustawisz okres retencji w dniach w Konsola → Ochrona danych. Codzienne czyszczenie stosuje bieżący okres do treści już zapisanej, więc jego skrócenie usuwa także starszą treść. Treść z czatów Sluis Workspace jest usuwana po upływie krótszego z dwóch okresów: tego okresu lub okresu Workspace dla wartości osobowych w czatach (domyślnie 7 dni). Rejestr metadanych audytu jest zachowywany i nigdy nie jest zmieniany. Wyłącz retencję, by mieć rejestr wyłącznie z metadanymi; to wyłącza także cache odpowiedzi.
Anonimizacja dokumentów
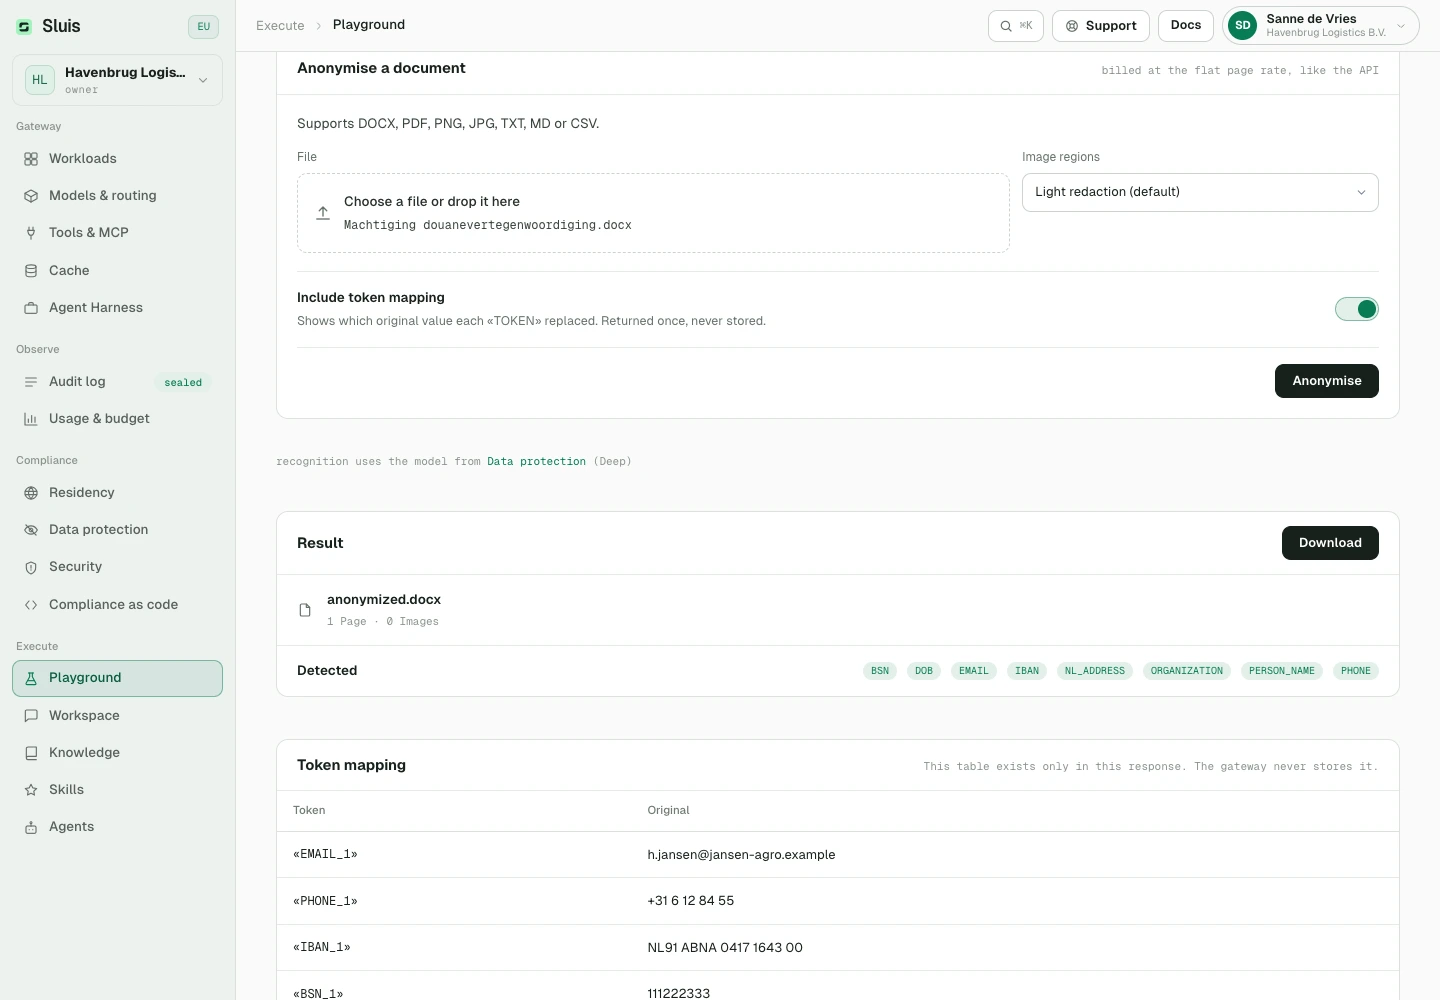
Wyślij plik docx, pdf, obraz lub tekst na POST /v1/documents/anonymize a ten sam dokument wraca z PII i sekretami zastąpionymi znacznikami jak «PERSON_NAME_1» w tekście oraz rozmytymi na obrazach i stronach PDF. Przetwarzanie pozostaje lokalne w gateway, wraz z OCR; operacja jest pieczętowana w łańcuchu audytu i rozliczana za stronę/obraz. Mapa tokenów jest zwracana tylko na żądanie i nigdy nie jest przechowywana. Zredagowane PDF-y zachowują niewidoczną, przeszukiwalną warstwę tekstu zbudowaną z zanonimizowanego tekstu. Dla dużych dokumentów zakolejkuj zadanie asynchroniczne i odbierz wynik później przez podpisany URL o ograniczonej ważności. W skanach wiersze, których OCR nie potrafi wiarygodnie odczytać, takie jak podpisy i nieczytelne pismo odręczne, oraz tusz poza każdym rozpoznanym wierszem tekstu, taki jak parafy i pieczątki, są niszczone, a nie zgadywane. W warstwie tekstu widnieją jako «UNREADABLE», a odpowiedź zgłasza kategorię UNREADABLE_REDACTED.
Ta sama ochrona działa w tranzycie: z włączoną polityką dlp_documents pliki wysyłane przez /v1/files i dokumenty OCR inline są anonimizowane zanim wyjdą do dostawcy, odrzucane w trybie block i skanowane w trybie allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddingi
Pseudonimizowane tokeny są stabilne w obrębie jednego żądania, nie między żądaniami; embeddingi tokenizowanego tekstu mogą się więc różnić między wywołaniami. Ustawienie dlp_embeddings decyduje, czy skanowanie obejmuje /v1/embeddings: domyślnie włączone, ustawienie na off wysyła dane wejściowe embeddingów do dostawcy bez skanowania. Każde zwolnione wywołanie jest odnotowane w dzienniku audytu.
Terminy do usunięcia w żądaniu
Każde żądanie JSON w płaszczyźnie danych — chat completions, completions, embeddings, responses oraz natywne ingressy Anthropic — może nieść rozszerzenie sluis na najwyższym poziomie. Jego lista remove wskazuje terminy, które gateway musi usunąć z promptu przed wysyłką: zwykły ciąg znaków albo obiekt z polem text i kind spośród person | organization | location | term. Najwyżej 128 wpisów, każdy niepusty po przycięciu i najwyżej 256 znaków; dopasowanie działa na granicach słów i ignoruje wielkość liter. Samo rozszerzenie jest konstrukcją gateway i zawsze znika przed wysyłką: nigdy nie trafia do dostawcy, do cache ani do przechowywanej treści.
# name the terms the gateway must remove — the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out — the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Każde dopasowanie staje się odwracalnym tokenem — «PERSON_NAME_1» — który dołącza do zwykłej pseudonimizacji: w trybie tokenize, domyślnym, oryginalne wartości są przywracane w odpowiedzi, łącznie ze streamingiem; w trybie mask termin zastępuje [REDACTED:<kind>]; w trybie block żądanie jest odrzucane z 422. Instrukcja jest zawsze respektowana, nawet gdy klucz ustawia dlp: off, organizacja działa w allow_log lub /v1/embeddings jest zwolnione: może wyłącznie wzmocnić ochronę, nigdy jej osłabić, i dlatego jest dopuszczona per żądanie tam, gdzie wycofany nagłówek x-sluis-dlp nie był. Wskazany termin nigdy nie dociera do dostawcy.
Wadliwa dyrektywa nigdy nie jest po cichu ignorowana: nieznany kind, wpis poza limitami lub nieznane pole wewnątrz rozszerzenia są odrzucane z 422. To, co faktycznie zadziałało, jest ujawniane w zapieczętowanym wierszu audytu, gdzie terminy podane przez wywołującego niosą warstwę request — dlp:tokenize:person_name(request) — odrębną od warstw (ner) i (directory), więc dziennik pokazuje, skąd wzięło się każde usunięcie. Ta sama lista jest przyjmowana jako opcja remove na /v1/documents/anonymize i w jego zadaniach asynchronicznych.
Wyjątki workloadu
Wyjątki należą do workloadu i dotyczą wszystkich jego poświadczeń. Owner lub admin konfiguruje option_overrides w Console → Workloads lub przez POST /admin/workloads podczas tworzenia. Nieustawione opcje dziedziczą politykę organizacji. Edycja przez PATCH /admin/workloads/{workload_id} wymaga wszystkich edytowalnych ustawień, w tym nazwy, statusu, limitów i budżetu; zastępuje je zamiast scalać pola.
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "mode": "off" },
        "ner_model": "deep",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
Nagłówek żądania x-sluis-dlp został usunięty. Żądania z nim otrzymują 400; skonfiguruj workload. Obowiązujące wyjątki są zapisywane w zapieczętowanym dzienniku audytu.