Referencja API
Uwierzytelnianie, endpointy, streaming, reasoning i błędy na powierzchni OpenAI, natywne API Anthropic oraz macierz zgodności per endpoint.
Uwierzytelnianie
Każde żądanie do /v1/* uwierzytelnia się wirtualnym kluczem w nagłówku Authorization: Bearer. Klucze tworzysz w Konsoli; sekret jest pokazywany raz, a przechowywany jest tylko jego hash. Klucz uwierzytelnia workload. Workload zarządza limitami, budżetem, dozwolonymi modelami i wyjątkami; żądania nadal podlegają polityce organizacji.
Żądanie, którego model nie znajduje się na niepustej liście dozwolonych modeli workloadu, zostaje odrzucone zapieczętowanym 403 permission_error zanim cokolwiek zostanie wysłane; sama odmowa trafia do łańcucha audytu.
Utworzenie klucza produkcyjnego wymaga zweryfikowanego adresu e-mail.
curl https://api.sluis.ai/v1/models \
  -H "Authorization: Bearer $SLUIS_KEY"

# a model outside the key's allow-list never dispatches:
# → 403 permission_error · the refusal is sealed in the audit chain
{
  "object": "list",
  "data": [
    { "id": "mistral/mistral-large-latest", "object": "model", "owned_by": "mistral" },
    { "id": "vertex/claude-opus-4-8", "object": "model", "owned_by": "vertex" },
    { "id": "sluis/auto", "object": "model", "owned_by": "sluis" }
  ]
}
Endpointy
Sluis udostępnia poniższą powierzchnię zgodną z OpenAI, a obok niej natywne ścieżki Anthropic opisane dalej. Endpointy bez dedykowanej obsługi są przekazywane dosłownie do wyznaczonego dostawcy, wraz ze streamingiem, więc zgodne z OpenAI usługi nadrzędne zachowują pełną wierność. Przeglądarka, która otworzy ścieżkę nieobsługiwaną przez API, na przykład sam host API, zostaje przekierowana do tej dokumentacji; klienci API nadal dostają zwykłe 404.
| Endpoint | Przeznaczenie |
|---|---|
| POST / | Chat completions, główna powierzchnia: routing, ochrona danych, buforowanie, streaming. |
| POST / | Starsze text completions. |
| POST / | Embeddingi. |
| POST / | Klasyfikacja moderacji. |
| POST / | API OpenAI Responses. |
| POST / | Native System One typed decisions, not OpenAI chat messages. |
| POST / | OCR dokumentów (Mistral, lub w pełni lokalnie z modelem sluis/ocr) · rozliczane za stronę. Z włączoną polityką dlp_documents dokumenty inline są anonimizowane przed wysyłką. |
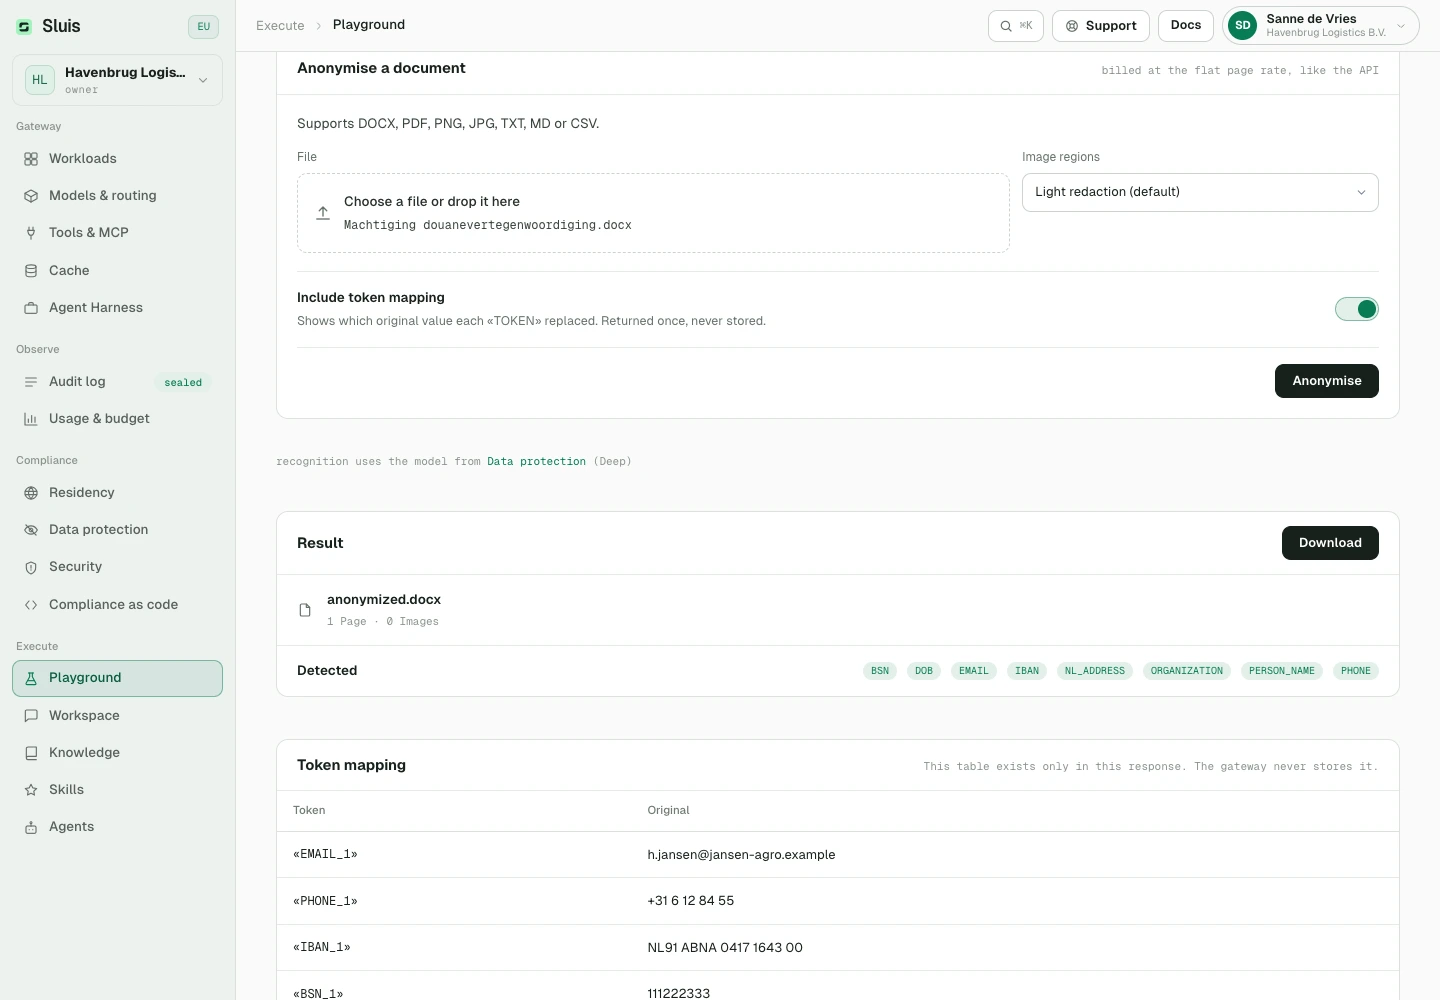
| POST / | Anonimizacja dokumentów · PII stają się «MERGE_TAG»ami, obrazy są rozmywane · rozliczane za stronę/obraz. |
| POST / | Asynchroniczne zadania anonimizacji · kolejkuj duże dokumenty, sprawdzaj status i pobieraj wynik przez podpisany URL o ograniczonej ważności, bez klucza API. |
| GET / | Modele, które Twoja polityka i poświadczenia faktycznie osiągają, nic hipotetycznego. |
| GET / | Metadane pojedynczego modelu. |
| POST / | Transkrypcja, tłumaczenie, mowa · przekazywane do wyznaczonego dostawcy. |
| POST / | Generowanie i edycja obrazów · przekazywane. Wyjątkiem jest mistral/image-generation: Mistral udostępnia generowanie obrazów wyłącznie przez swój konektor agenta, więc brama tłumaczy żądanie OpenAI i odpowiada w b64_json, rozliczane za obraz. |
| POST / | Generowanie wideo · przekazywane. |
| / | Operacje na plikach · przekazywane z własnym kluczem Twojej organizacji (BYOK lub własny dostawca), nigdy z zarządzanymi kluczami. |
| POST / | Natywne wejście Anthropic Messages · skieruj dowolne narzędzie z SDK Anthropic na Sluis; dowolny podłączony model. |
| POST / | Lokalne oszacowanie tokenów dla zarządzania kontekstem SDK Anthropic; nic nie jest wysyłane. |
| GET / | Natywne odkrywanie modeli Anthropic · list i get w formacie Anthropic, z katalogu w procesie. Na /v1/models ten sam format wybiera nagłówek anthropic-version. |
| HEAD / | Sonda rozgrzewkowa dla klientów SDK Anthropic, takich jak Claude Code · 200 z pustym ciałem. |
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user", "content": "Say hi" }] }'
{
  "id": "chatcmpl-9f2e…",
  "object": "chat.completion",
  "model": "mistral-large-latest",
  "choices": [{
    "index": 0,
    "message": { "role": "assistant", "content": "Hi! How can I help?" },
    "finish_reason": "stop"
  }],
  "usage": { "prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17 }
}
Każde powyższe ciało JSON może dodatkowo nieść rozszerzenie gateway sluis.remove, wskazujące terminy, które trzeba spseudonimizować w prompcie przed wysyłką. Jest usuwane, zanim żądanie opuści gateway; zobacz Referencji ochrony danych.
# Document OCR, billed per page. Returns pages[] markdown + usage_info.pages_processed.
# model "sluis/ocr" runs the gateway's own OCR engine: fully local, no provider egress (inline data: URLs only).
curl https://api.sluis.ai/v1/ocr \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-ocr-latest", "document": { "type": "document_url", "document_url": "https://example.com/invoice.pdf" } }'
{
  "pages": [{
    "index": 0,
    "markdown": "# Invoice 2026-118\nAcme BV · Keizersgracht 1…",
    "images": [],
    "dimensions": { "dpi": 150, "height": 1754, "width": 1240 }
  }],
  "model": "mistral-ocr-latest",
  "usage_info": { "pages_processed": 1, "doc_size_bytes": 48213 }
}# Document anonymization, billed per page/image. PII becomes «MERGE_TAG»s; images are blurred. curl https://api.sluis.ai/v1/documents/anonymize \ -H "Authorization: Bearer $SLUIS_KEY" \ -F file=@contract.docx \ -F 'options={ "entities": ["person_name", "email", "iban"], "remove": ["Project Nightingale"], "include_mapping": true }'
{
  "filename": "contract.docx",
  "content_type": "application/vnd.openxmlformats-officedocument.wordprocessingml.document",
  "content_base64": "UEsDBBQABgAIA…",
  "summary": { "pages": 4, "images": 1, "categories": ["EMAIL", "IBAN", "PERSON_NAME"], "downgraded": false },
  "mapping": [
    { "token": "«PERSON_NAME_1»", "original": "Jan de Vries" },
    { "token": "«IBAN_1»", "original": "NL91ABNA0417164300" }
  ]
}
System One typed decisions
# The router behind sluis/auto: send state only, not questions.
curl https://api.sluis.ai/v1/systemone \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"sluis/typed/router",
       "state":{"request":"Compare these two supplier contracts clause by clause and list the risks.",
                "previous":"Here are both contracts.",
                "attachments":["contract_a.pdf (application/pdf)","contract_b.pdf (application/pdf)"]}}'
{
  "model": "sluis/typed/router",
  "answers": {
    "reasoning":  { "type": "noul", "noul": 0.9412,
                    "probabilities": { "false": 0.0588, "true": 0.9412 },
                    "confidence": 0.9412, "answer_confidence": 0.9412 },
    "complexity": { "type": "score", "score": 2.31,
                    "legend": { "0": "trivial", "1": "simple", "2": "moderate", "3": "hard" },
                    "probabilities": { "0": 0.01, "1": 0.12, "2": 0.42, "3": 0.45 },
                    "confidence": 0.2612, "answer_confidence": 0.45 },
    "task":       { "type": "choice", "choice": "document",
                    "probabilities": { "code": 0.01, "writing": 0.03, "translation": 0.01, "extraction": 0.05,
                                       "document": 0.86, "support": 0.02, "smalltalk": 0.01, "action": 0.01 },
                    "confidence": 0.6888, "answer_confidence": 0.86 }
  },
  "decision": { "route": "sluis/reasoning", "demand": "strong" },
  "revision": ""
} | Local-pack contract | Behaviour |
|---|---|
| Model ids | sluis/typed answers your own questions on a local open model (GLiNER2.5-Decide). sluis/typed/router is the router Sluis uses for sluis/auto, with its own calibrated questions. |
| sluis/ | Send the text a request carries: state.request (required), and optional previous, system and attachments (a string or a list of "name (mime)" strings); a plain string is the request. It answers reasoning (noul, P(needs multi-step reasoning)), complexity (score, 0 trivial to 3 hard, with legend and probabilities per level) and task (choice over code, writing, translation, extraction, document, support, smalltalk, action). decision holds the route and demand sluis/auto would take from this text alone, or null. Files, images, JSON mode, tools, prompt size and your organisation's policy are not part of this input and can change a real sluis/auto route. answers.reasoning keeps the keys it always had; the rest is additional. |
| Plain sluis/ | Always answered on Sluis infrastructure, never by an outside provider. When the local model is unavailable the call returns 503. GET /v1/models lists it only when it can answer. |
| TypeSafe | Bring your own key only; no sluis/* alias reaches it. Name the model explicitly, for example typesafe/jev-latest. The normal gate applies: it is a US provider, so your residency policy must allow US. |
| Availability | Every answer comes from verified model weights, reported as revision. If the local model is unavailable or cannot be verified, the call fails closed with 503. |
| State | Required JSON object, list (array) or string, at most 128 KiB (131072 bytes) of serialized JSON before DLP. Missing or invalid state returns 422; oversized state returns 413. The open pack reads the first 384 words. |
| Questions | sluis/typed/router supplies its own calibrated questions: any questions field, including null or an empty object, returns 400. Plain sluis/typed requires 1 to 16 questions of type noul, choice (2 to 20 options) or score (2 to 20 levels), each with instructions; missing questions return 422, a malformed set 400, more than 64 KiB 413. The characters [ ] ( ) and backticks are removed before the model reads them, so options that then collide return 400, as does a set longer than about 1,000 tokens. |
| Response | JSON with model, answers and revision (weights SHA256); sluis/typed/router adds decision. Each answer has its type, its typed value (choice, score or noul), confidence and, where the pack reports them, probabilities, legend and answer_confidence. On sluis/typed gate on answer_confidence; its probabilities are uncalibrated. No chat completion or streaming envelope. |
| Latency | sluis/typed/router usually answers well under 200 ms; when busy it returns 503 with Retry-After: 2. Plain sluis/typed runs all questions in one CPU pass: about 2 s for a prompt-sized state, up to about 7 s for a long one, with a 10 s budget. |
| Data protection | Tenant DLP applies locally to the state and to the questions' instructions and criteria: block refuses; tokenize or mask rewrites what the pack is shown. Per-request removal terms are honoured. |
| Residency | Processed on Sluis infrastructure with no outside provider and no upstream residency routing step. |
| Metering | Each successful local decision is sealed and billed per input token at €0.01 per 1M tokens; output is free. The pack reports no token count, so input is estimated at about 4 characters per token over the state and questions it was shown. Normal limits, budgets and model allow-lists still apply. |
| Aliases | An existing tenant alias with the same name takes precedence over the local pack. |
Dokumenty na wejściu
Dołącz PDF, dokument Word, obraz lub plik tekstowy do żądania czatu jako część treści "type": "file" z URL-em file_data w base64. Zaakceptuje to każdy wybrany model: dostawcy, którzy natywnie rozumieją części plikowe, otrzymują je bez zmian, a dla wszystkich pozostałych brama konwertuje dokument przed wysyłką. Referencje file_id po stronie dostawcy nie są rozwiązywane; osadź bajty jako file_data.
Modele z widzeniem otrzymują każdą stronę PDF wyrenderowaną jako część image_url (budżet 48 stron na żądanie, wspólny dla wszystkich załączonych dokumentów); modele bez wejścia obrazowego otrzymują możliwy do wyodrębnienia tekst dokumentu wstawiony jako tekst promptu, który skan ochrony danych obejmuje potem jak każdy inny tekst. Dłuższe lub cięższe dokumenty należą do /v1/ocr. Przy włączonej polityce dlp_documents dokument jest anonimizowany lub odrzucany, zanim cokolwiek opuści bramę. Gdy jest wyłączona, a tryb DLP organizacji jest ochronny (tokenize, mask lub block), dokumenty, które podróżowałyby jako niemożliwe do zbadania obrazy, są odrzucane; przy allow_log przechodzą z jawnym znacznikiem braku skanowania w dzienniku audytu.
# Attach a document as an OpenAI-style `file` content part. The gateway
# normalizes it for the routed provider, so this works on any model.
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "scaleway/gemma-4-26b-a4b-it",
        "messages": [{ "role": "user", "content": [
          { "type": "file",
            "file": { "filename": "drawing.pdf",
                      "file_data": "data:application/pdf;base64,'"$(base64 -w0 drawing.pdf)"'" } },
          { "type": "text", "text": "Which discipline does this drawing document?" }
        ] }] }'
import OpenAI from "openai";
import { readFileSync } from "node:fs";

const client = new OpenAI({
  baseURL: "https://api.sluis.ai/v1",
  apiKey: process.env.SLUIS_KEY,
});
const pdf = readFileSync("drawing.pdf").toString("base64");

const reply = await client.chat.completions.create({
  model: "vertex/gemini-3.1-pro",
  messages: [{
    role: "user",
    content: [
      { type: "file",
        file: { filename: "drawing.pdf",
                file_data: `data:application/pdf;base64,${pdf}` } },
      { type: "text", text: "Which discipline does this drawing document?" },
    ],
  }],
});
Streaming
Ustaw stream: true, a odpowiedź nadchodzi jako server-sent events: każda ramka to delta chat.completion.chunk, a strumień kończy się data: [DONE]. Strumienie nigdy nie są buforowane w bramie: przepływają przez nią rozgałęzieniem (tee), a zapieczętowanie audytu i pomiar następują nawet wtedy, gdy klient rozłączy się wcześniej.
Poproś o stream_options.include_usage a ostatnia ramka niesie dokładne zużycie tokenów, te same liczby, które brama mierzy i rozlicza.
Po 15 sekundach bez ramki brama zapisuje między zdarzeniami linię komentarza SSE (: keepalive), aby proxy z limitem bezczynności utrzymywały połączenie, gdy model myśli; klienci SSE ją ignorują. Strumienie mają nagłówki Cache-Control: no-cache i X-Accel-Buffering: no. Gdy replika bramy się restartuje, obsługuje otwarte strumienie jeszcze do pięciu minut; strumień otwarty dłużej kończy się zdarzeniem błędu z kodem server_restarting, wtedy ponów żądanie.
stream = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Write a haiku"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="")
const stream = await client.chat.completions.create({ model: "mistral/mistral-large-latest", messages: [{ role: "user", content: "Write a haiku" }], stream: true, stream_options: { include_usage: true }, }); for await (const chunk of stream) { process.stdout.write(chunk.choices[0]?.delta?.content ?? ""); }
# the raw event stream on the wire
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"Water"}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" finds a way."}}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}],"usage":{"prompt_tokens":12,"completion_tokens":9,"total_tokens":21}}

data: [DONE]
Rozumowanie
Przekaż parametr OpenAI reasoning_effort (minimal | low | medium | high) na dowolnym modelu zdolnym do myślenia. Sluis tłumaczy go zależnie od dostawcy (poziom myślenia Gemini, adaptacyjny wysiłek myślowy Claude) i pomija go tam, gdzie model by go odrzucił, więc jeden parametr działa w całym katalogu.
resp = client.chat.completions.create(
    model="vertex/claude-opus-4-8",
    messages=[{"role": "user", "content": "Prove it step by step…"}],
    reasoning_effort="high",  # minimal | low | medium | high
)
Cache promptów
Powtarzające się prefiksy promptu — długi prompt systemowy, definicje narzędzi, rosnąca rozmowa — mogą być cache'owane u dostawcy: taniej i szybciej. Sluis mówi standardowymi markerami branży: bloki cache_control w stylu Anthropic (z opcjonalnym TTL 5m lub 1h) oraz parametr najwyższego poziomu prompt_cache_key od OpenAI. Wyślij je w jednej formie; Sluis tłumaczy je lub usuwa zależnie od dostawcy, więc to samo żądanie działa w całym katalogu.
| Dostawca | Zachowanie cache promptów |
|---|---|
| Anthropic | Jawne punkty cache_control na blokach systemowych, treści wiadomości i definicjach narzędzi, z TTL 5m lub 1h. Odczyty i zapisy cache raportowane są osobno. |
| Bedrock | cache_control jest tłumaczony na bloki cachePoint w Converse w system, messages i toolConfig — to samo żądanie, bez przepisywania po Twojej stronie. |
| OpenAI · Azure | Automatyczne cache'owanie długich prefiksów. Markery są usuwane; opcjonalny prompt_cache_key jest przekazywany bez zmian, by kolejne wywołania trafiały w ten sam cache. |
| Gemini · Vertex | W przypadku modeli Gemini cache'owanie jest niejawne po stronie dostawcy — nic nie wysyłasz, a raportowany udział tokenów z cache przechodzi do Twojego zużycia. Claude na Vertex przyjmuje jawne cache_control wraz z TTL, dokładnie jak w Anthropic. |
| xAI · DeepSeek · Mistral · Qwen · Moonshot · Zhipu | Automatycznie tam, gdzie dostawca to oferuje. Jawne markery są usuwane, więc żądanie napisane dla Claude nigdy nie zostanie tu odrzucone. |
| Scaleway · custom | Scaleway nie ma cache promptów u dostawcy: dyrektywy są tam usuwane, a dźwignią jest opcjonalny cache odpowiedzi bramki. Własny endpoint dostaje obie dyrektywy bez zmian — to zachowanie jest kontraktem operatora. |
Jawny cache promptów jest włączany na poziomie organizacji i domyślnie wyłączony: prefiks w cache to dane w spoczynku u dostawcy — wcześniej przefiltrowane przez DLP Sluis, ale przechowywane poza Sluis przez czas życia cache. Włącz go w Konsola → Ochrona danych. Część dostawców (OpenAI, Gemini, xAI, DeepSeek) i tak cache'uje automatycznie we własnej infrastrukturze; przełącznik rządzi tylko tym, co Sluis jawnie przekazuje (cache_control, cachePoint, prompt_cache_key), a nie wewnętrznym zachowaniem dostawcy. Bez własnego klucza do dostawcy wywołania korzystają z poświadczeń Sluis współdzielonych z innymi organizacjami: w OpenAI i Azure Sluis zastępuje Twój prompt_cache_key kluczem wyprowadzonym z Twojej organizacji, a u pozostałych dostawców liczniki tokenów z cache w Twoim zużyciu pokazują 0. Rozliczenie nadal uwzględnia rzeczywisty rabat za cache.
Odczyty z cache rozliczane są po obniżonej stawce dostawcy; zapisy w stylu Anthropic dodają dopłatę za zapis do stawki wejściowej. Oba są widoczne dla każdego wywołania w szufladzie audytu i sumowane w Zużycie i budżet. Na kluczu zarządzanym przez Sluis żądanie, które wybiera dopłatę, której Sluis nie potrafi zmierzyć — ttl cache_control inny niż 5m tam, gdzie dostawca go respektuje (Anthropic, Bedrock, Claude na Vertex), service_tier inny niż auto, default, flex lub standard_only albo beta długiego kontekstu Anthropic (context-1m) — jest odrzucane z 400, zanim cokolwiek zostanie wysłane; Twój własny klucz dostawcy przekazuje wszystkie trzy bez zmian.
Kody błędów
Błędy używają koperty błędów OpenAI; wartość error.type odzwierciedla status HTTP, więc obsługa błędów w Twoim SDK działa bez zmian.
| Kod | Kiedy |
|---|---|
| 400 invalid_request_error | Nieprawidłowy body żądania lub parametry. |
| 400 invalid_request_error | Identyfikator modelu bez prefiksu dostawcy. Każdy wywoływalny identyfikator to provider/model, np. mistral/mistral-large-latest; treść odpowiedzi brzmi: model must be provider-prefixed. |
| 400 invalid_request_error | Żądanie niesie usunięty nagłówek x-sluis-dlp. Nadpisania per żądanie zastąpiono option overrides per workload; skonfiguruj je w Konsola → Workloady. |
| 401 authentication_error | Brakujący lub nieznany klucz API. |
| 402 insufficient_quota | Brak aktywnego planu lub osiągnięty budżet. Aktywuj plan albo podnieś budżet; żądanie nigdy nie dociera do dostawcy. |
| 403 permission_error | Klucz nie ma uprawnień, na przykład model nie jest na jego liście dozwolonych. |
| 422 invalid_request_error | Odrzucone przed wysyłką, na przykład ochrona danych w trybie block dopasowała żądanie. |
| 422 document_too_large_to_scan | Dokument jest zbyt duży dla obranej ścieżki: strona wciąż przekracza limit pikseli renderowania nawet przy minimalnej rozdzielczości skanowania albo plik przekracza limit bajtów ekstrakcji tekstu. Strony wielkoformatowe (rysunki A0/A1) są renderowane z automatycznym pomniejszeniem; dedykowany kod pozwala klientowi zmniejszyć lub podzielić dokument i wysłać go ponownie. |
| 429 rate_limit_error | Osiągnięty limit zapytań. Egzekwowane na bramie; żądanie nigdy nie dociera do dostawcy. |
| 403 permission_error | Zablokowane przez politykę rezydencji: żadna dozwolona jurysdykcja nie obsłuży żądania. Body zawiera powód. |
| 403 scope_violation | Odrzucone przez strażnika zakresu workloadu w trybie block: wywołanie wykracza poza zakres zapisany dla tego workloadu. Komunikat podaje powód strażnika, a żądanie nigdy nie trafia do dostawcy. |
| 503 pdf_renderer_unavailable | Osadzony PDF musiał zostać wysłany jako obrazy stron, ponieważ wybrany model przyjmuje dane obrazowe, ale to wdrożenie nie ma renderera PDF. Żądanie zostaje odrzucone zamiast po cichu obsłużone na podstawie wyodrębnionego tekstu, co odrzuciłoby wszystko, co pokazuje rysunek lub skan. |
| 503 scope_guard_unavailable | Strażnik zakresu workloadu działa w trybie block, ale nie wydał werdyktu, więc wywołanie zostaje odrzucone zamiast przepuszczone. Ponów z rosnącym odstępem. |
| 503 auth_unavailable | Il gateway non ha potuto leggere il proprio archivio delle chiavi e quindi verificare la chiave. La chiave non è considerata non valida; riprova con backoff e rispetta Retry-After. |
| 504 api_error | Dostawca nie odpowiedział w czasie na odpowiedź ustawionym dla workloadu: 300 sekund, chyba że workload ustawia od 10 do 600, krócej, jeśli żądanie wysłało x-sluis-upstream-timeout. error.sluis.cause ma wartość timeout. Brama nie powtórzyła wywołania, bo dostawca może je nadal przetwarzać; skróć prompt albo poproś o dłuższy czas, zanim wyślesz je ponownie. |
| 5xx api_error | Awaria dostawcy nadrzędnego po ponowieniach; bezpiecznik kieruje ruch z pominięciem niesprawnych dostawców. Body przenosi komunikat samego dostawcy oraz obiekt error.sluis nazywający przyczynę i każdą podjętą próbę, z jej statusem nadrzędnym lub błędem transportu i czasem trwania. |
{
  "error": {
    "message": "model must be provider-prefixed, e.g. mistral/mistral-large-latest",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_request"
  }
}
{
"error": {
"message": "model is not on this key's allow-list",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}{
"error": {
"message": "provider `openai` (jurisdiction `US`) is not permitted by the tenant's residency policy",
"type": "permission_error",
"param": null,
"code": "permission_denied"
}
}Anthropic Messages API
Sluis mówi natywnie w Anthropic Messages API. Skieruj Claude Code lub dowolne SDK Anthropic na bramkę i wywołaj POST /v1/messages: żądanie jest tłumaczone na kształt wewnętrzny, przechodzi dokładnie ten sam potok Inspect → Route → Seal → Meter jak każde inne wywołanie i wraca przetłumaczone na format Anthropic, wraz ze streamingiem. /anthropic/v1/messages to jednoznaczna ścieżka z prefiksem do tej samej obsługi.
Uwierzytelnianie
Wyślij swój klucz Sluis w nagłówku x-api-key Anthropic albo w zwykłym nagłówku Authorization: Bearer; oba są akceptowane. Nagłówek anthropic-version jest czytany, ale nigdy wymagany, i sprawdzany jest tylko jego kształt. Parsowanie jest celowo otwarte: nieznane pola ciała, nieznane typy bloków treści, nieznane wartości anthropic-beta i zapytanie ?beta=true, które wysyła Claude Code, są tolerowane, a nie odrzucane. Flagi beta trafiają bajt w bajt do dostawców z rodziny Anthropic, a w innych miejscach są ignorowane.
Endpointy
| Endpoint | Przeznaczenie |
|---|---|
| POST / | Messages, buforowane lub strumieniowe · prompty systemowe jako łańcuch lub bloki, narzędzia i wyniki narzędzi (także wyniki błędów i bloki obrazów w środku), obrazy, bloki dokumentów, historyczne bloki thinking i redacted_thinking oraz znaczniki cache_control na każdej pozycji podlegającej cache'owaniu. |
| POST / | Lokalne oszacowanie tokenów do zarządzania kontekstem w SDK: nic nie jest wysyłane, przechowywane ani rozliczane. |
| GET / | Natywne odkrywanie modeli w formacie Anthropic (data, has_more, first_id, last_id, display_name, created_at, kursory before_id/after_id/limit w miarę możliwości), obsługiwane z katalogu w procesie, bez zapytania do bazy. Na ścieżce głównej ten format wybiera nagłówek anthropic-version — bez niego dostajesz format OpenAI; pod /anthropic obowiązuje zawsze. Identyfikatory pozostają wywoływalnymi w Sluis identyfikatorami provider/model, a created_at jest stałym wypełniaczem, bo katalog nie zna daty wydania poszczególnych modeli. |
| HEAD / | Sonda rozgrzewkowa, którą Claude Code wysyła przed sesją · tylko HEAD, odpowiedź 200 z pustym ciałem. |
Routing modeli
Format przewodowy nigdy nie ogranicza modelu: wejście to kodek, a trasę wybiera identyfikator modelu. Goły identyfikator, na przykład claude-sonnet-5, rozwiązuje się przez domyślnego dostawcę tego wejścia — anthropic, chyba że Twoja organizacja wskaże inny, na przykład vertex dla Claude w UE — po czym brama rezydencji nadal decyduje, czy ten cel może obsłużyć żądanie. Przypnij cel wprost identyfikatorem z prefiksem dostawcy (vertex/claude-opus-4-8) albo podaj alias sluis/*: narzędzie na SDK Anthropic działa wtedy na dowolnym podłączonym dostawcy, w granicach Twojej polityki.
Streaming
Przy "stream": true odpowiedzią jest pełna gramatyka zdarzeń Anthropic: message_start z prawdziwą liczbą tokenów wejściowych, content_block_start / content_block_delta / content_block_stop dla każdego bloku, message_delta z narastającym zużyciem, w tym tokenami odczytu i tworzenia cache, a na końcu message_stop. Tekst przychodzi jako text_delta, argumenty narzędzi jako input_json_delta, a rozumowanie jako thinking_delta i signature_delta, jeśli wyznaczony dostawca je wytworzył. Zdarzenie ping następuje po message_start i powtarza się po około 15 sekundach ciszy po stronie dostawcy, więc długie myślenie nigdy nie uruchomi licznika klienta, a awaria w środku strumienia jest przekodowana na zdarzenie error zamiast urwanego strumienia. stop_sequence zawiera dopasowaną sekwencję, gdy odpowiedź przyszła od dostawcy z rodziny Anthropic, a w przeciwnym razie jest null.
# native Anthropic Messages — the model id owns the route, not the wire format
curl https://api.sluis.ai/v1/messages \
  -H "x-api-key: $SLUIS_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{ "model": "vertex/claude-opus-4-8",
        "max_tokens": 256,
        "system": "Be concise.",
        "messages": [{ "role": "user", "content": "Say hi" }] }'

# /anthropic/v1/messages is the unambiguous prefixed path for the same handler
{
  "id": "msg_01f7…",
  "type": "message",
  "role": "assistant",
  "model": "claude-opus-4-8",
  "content": [{ "type": "text", "text": "Hi! How can I help?" }],
  "stop_reason": "end_turn",
  "stop_sequence": null,
  "usage": {
    "input_tokens": 9,
    "output_tokens": 8,
    "cache_read_input_tokens": 0,
    "cache_creation_input_tokens": 0
  }
}
# "stream": true — the full event grammar, ping keep-alives included
event: message_start
data: {"type":"message_start","message":{"id":"msg_01f7…","role":"assistant","model":"claude-opus-4-8","usage":{"input_tokens":9,"output_tokens":0}}}
event: ping
data: {"type":"ping"}
event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}
event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"Hi!"}}
event: ping
data: {"type":"ping"}
event: content_block_stop
data: {"type":"content_block_stop","index":0}
event: message_delta
data: {"type":"message_delta","delta":{"stop_reason":"end_turn","stop_sequence":null},"usage":{"output_tokens":8,"cache_read_input_tokens":0}}
event: message_stop
data: {"type":"message_stop"}Błędy
Każdy błąd na tych ścieżkach używa koperty Anthropic — pola "type": "error" na najwyższym poziomie z typem błędu producenta (invalid_request_error, authentication_error, billing_error, permission_error, not_found_error, conflict_error, request_too_large, rate_limit_error, api_error, overloaded_error) — łącznie z odmowami, które nigdy nie docierają do modelu, jak nieznany klucz czy blokada ochrony danych. Identyfikator żądania bramki wraca w nagłówku request-id i w polu request_id ciała, a jest to ten sam identyfikator, który wskazuje wywołanie w śladzie audytu.
# every failure on /v1/messages* is Anthropic-shaped — auth and
# data-protection refusals included, never an OpenAI envelope
{
  "type": "error",
  "error": {
    "type": "rate_limit_error",
    "message": "rate limit exceeded"
  },
  "request_id": "req_9f2e…"
}
# mcp_servers is refused, not quietly passed through: an external MCP
# server called by the model would sit outside the Sluis gate
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "mcp_servers is not supported: register the server in Sluis and call the MCP gateway at /v1/mcp"
  },
  "request_id": "req_4c81…"
}
Jedno pole żądania jest odrzucane, a nie przekazywane: mcp_servers zwraca 400 invalid_request_error. Model wywołujący zewnętrzny serwer MCP działałby poza bramą Sluis, więc zarejestruj serwer w Konsoli i użyj bramki MCP pod /v1/mcp, gdzie każde wywołanie narzędzia jest sprawdzane, routowane, pieczętowane i rozliczane.
Macierz zgodności
Co natywne wejścia obejmują dziś, endpoint po endpoincie. Ta tabela jest deklaracją: czego nie ma tu jako obsługiwane, jest na roadmapie, świadomie odrzucane albo należy do innej powierzchni produktu — nigdy nie jest sugerowane po cichu.
| Anthropic | Status | Uwagi |
|---|---|---|
| POST / | ✓ natywne | Buforowane i strumieniowe, narzędzia, obrazy, bloki dokumentów, powrót bloków thinking i znaczniki cache promptów. |
| POST / | ✓ oszacowanie lokalne | Odpowiedź lokalna; nic nie jest wysyłane. |
| GET / | ✓ natywne | Natywny kształt list i get z katalogu w procesie; na ścieżce głównej wybierany nagłówkiem, pod /anthropic zawsze. |
| HEAD / | ✓ | Sonda rozgrzewkowa Claude Code, tylko HEAD. |
| Message Batches | ✗ roadmapa | Message Batches nie są zaimplementowane; praca wsadowa biegnie dziś jako zwykłe wywołania na żywo. |
| Files | ✗ roadmapa | API Files nie jest podłączone; wbudowane bloki dokumentów i file_data pokrywają typową drogę. |
| mcp_servers | ✗ odrzucone | Odrzucane z 400, nie przekazywane — zarejestruj serwer i wywołaj bramkę MCP Sluis pod /v1/mcp. |
| Skills · Agents · Admin | ✗ poza zakresem | Skills, zarządzani agenci oraz API administracyjne, zużycia i kosztów to inna powierzchnia produktu, nie zgodność inferencji. |
Routing między protokołami. Pola specyficzne dla producenta przeżywają, dopóki żądanie trafia do dostawcy mówiącego tym samym protokołem: żądanie Anthropic obsłużone przez dostawcę z rodziny Anthropic zachowuje bloki thinking, znaczniki cache, flagi beta i dopasowane stop_sequence. Przy routingu na inny protokół te pola są usuwane przy wysyłce — nigdy odrzucane na wejściu — a wiersz audytu zapisuje zarówno format przewodowy, jak i wybranego dostawcę, więc każda utrata jest przypisywalna. Wartości nieprzejrzyste nigdy nie są przepisywane: podpisy thinking i zawartość redacted_thinking są przekazywane dosłownie albo wcale, i właśnie dlatego zaparkowany blok thinking oznaczony przez skan ochrony danych jest usuwany, a nie maskowany — przepisany blok miałby nieprawidłowy podpis.