Presupuestos y caché
Límites de velocidad y presupuestos por clave, topes de organización y caché de respuesta exacta.
Presupuestos y límites
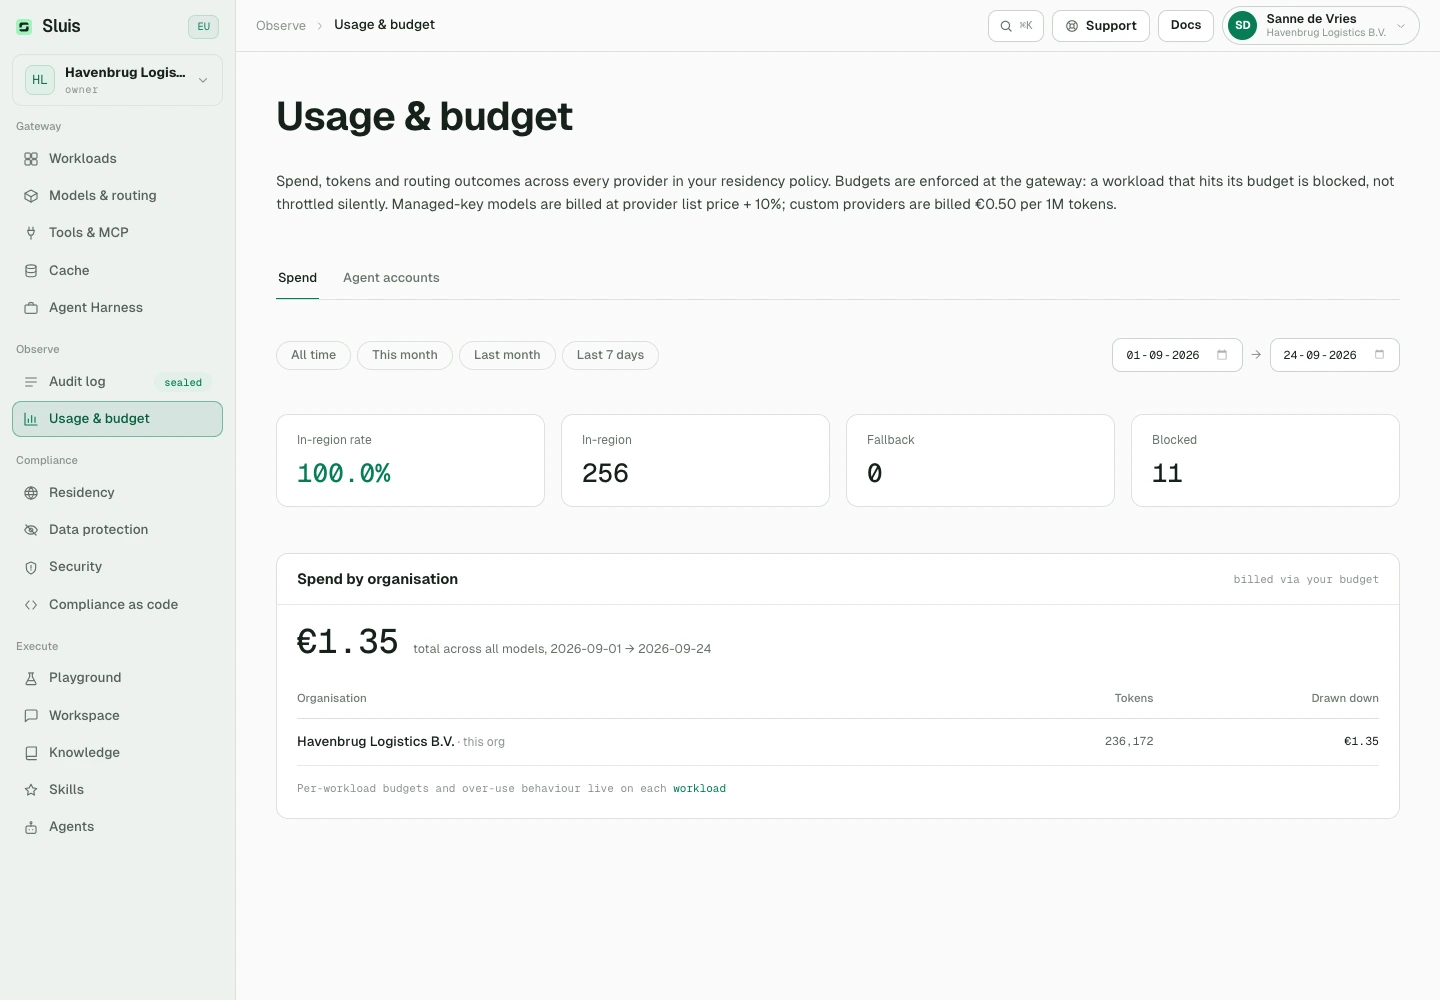
Cada carga de trabajo define límites de tasa (solicitudes y tokens por minuto) y un presupuesto compartido entre sus credenciales. Elija un periodo: total, daily o monthly. Un límite agregado de la organización se aplica a todos los workloads.
La aplicación ocurre en la pasarela, en dinero real: cada petición se tarifica con el libro de precios en vivo y se descuenta antes de despachar. Superado el límite de tasa, la llamada devuelve 429; superado el presupuesto, 402. La petición nunca llega a un proveedor. Si los contadores llegan a ser inaccesibles, la comprobación falla en cerrado y se reconcilia con el registro de auditoría inmutable en lugar de adivinar. Las subidas a Knowledge de Sluis Workspace se miden igual: los embeddings que necesita un documento se tarifican como una llamada a /v1/embeddings y se cargan a la organización, a su crédito prepago y al presupuesto del miembro que sube el archivo. Una subida se rechaza con 402 cuando el presupuesto o el crédito de la organización se ha agotado.
# past the key's rate limit — the request never reaches a provider
{
  "error": {
    "message": "rate limit exceeded",
    "type": "rate_limit_error",
    "param": null,
    "code": "rate_limit_exceeded"
  }
}
# budget reached or no active plan — activate a plan or raise the budget
{
  "error": {
    "message": "budget exceeded",
    "type": "insufficient_quota",
    "param": null,
    "code": "insufficient_quota"
  }
}
Caché
Una caché de respuesta exacta opcional compara peticiones normalizadas. Está estrictamente aislada por organización, cifrada en reposo y requiere retención de contenido. Actívela en la vista Cache de la Consola.
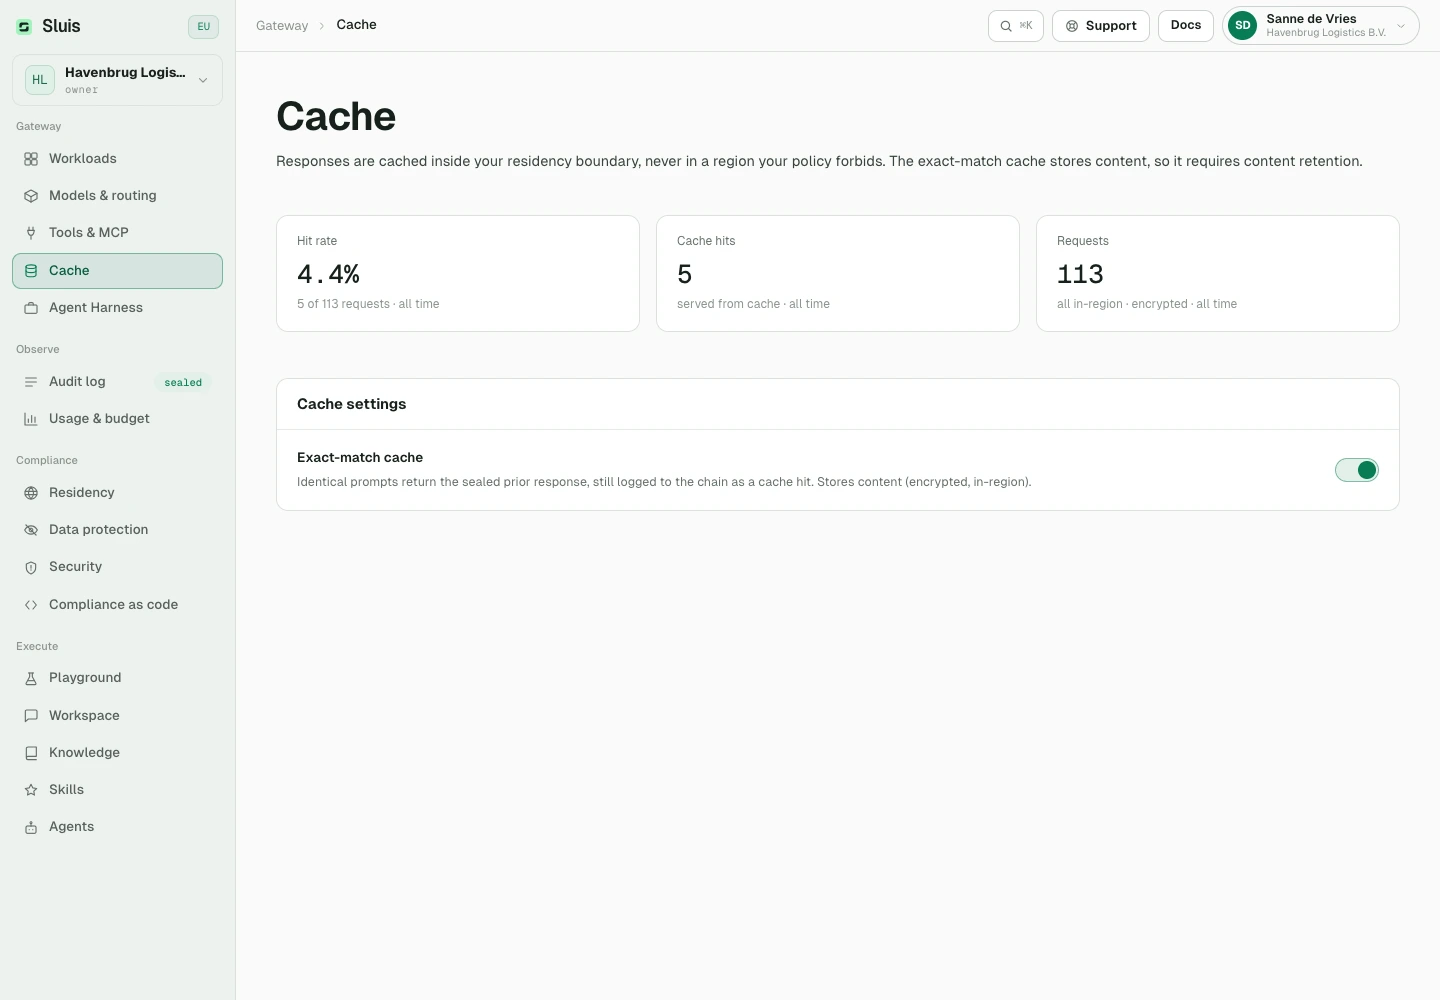
Las nuevas filas de auditoría registran cómo se sirvió la llamada: none | exact.
# identical request twice — the second is served from the exact cache
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest", "messages": [{ "role": "user", "content": "Define GDPR" }] }'

# audit row of call #2: cache_hit: exact · no provider dispatch, no token cost