Protección de datos
Los modos de detección, la biblioteca de 60 detectores, la detección de entidades y sus modelos a elegir, el análisis de seguridad, el aviso al modelo y la retención.
La protección de datos se ejecuta en cada petición antes de despachar. El modo por defecto es tokenize: cada valor detectado se sustituye por un token tipado estable como «EMAIL_1». Los valores detectados solo llegan al proveedor como tokens, y la respuesta se restaura a los valores reales de vuelta hacia usted, en streaming o no. El mapa de tokens vive en memoria durante la vida de la petición y nunca se persiste. La seudonimización es de un solo sentido: protege lo que usted envía. En Sluis Workspace, los resultados públicos de búsqueda web y la salida del propio modelo anterior en el mismo turno no se vuelven a tokenizar; un valor que la conversación ya tokenizó sigue sustituido por su token, y el registro de auditoría indica cuándo se aplicó.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives — only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back — restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Otros modos: mask reescribe los valores detectados de forma irreversible, block rechaza la petición con 422, y allow_log la deja pasar mientras marca la fila de auditoría.
60 detectores integrados vienen de serie: 28 para datos personales, del número de la Seguridad Social de EE. UU. a un paquete de identificadores nacionales de 12 países de la UE validados por suma de control, y 32 para secretos y credenciales. Cada uno se puede activar o desactivar por organización, y los términos personalizados (texto plano o regex) cubren cualquier cosa específica de su negocio:
Detección de entidades
Personas, organizaciones y lugares son difíciles de detectar solo mediante patrones. Sluis combina heurísticas de contexto, correlación de correo, directorio del tenant, diccionarios incluidos y NER opcional. El modelo NER funciona como sidecar interno: el texto permanece dentro del despliegue. Estas capas también analizan el texto extraído de documentos y por OCR cuando la protección de documentos está activada. Con NER activado, una petición puede nombrar hasta 100.000 entidades distintas; por encima de ese límite el análisis cuenta como incompleto. Un nombre que el modelo detecta una vez se sustituye allí donde reaparezca en la petición, como la misma palabra completa con las mismas mayúsculas y el mismo token, también en mensajes donde el modelo no lo señaló. Las palabras genéricas aisladas y las siglas cortas solo cubren la aparición que el modelo señaló.
El diccionario de nombres es la contraparte determinista del NER: nombres de pila y apellidos compilados a partir de datos abiertos de administraciones públicas en un diccionario incluido en la pasarela. Detecta nombres completos y nombres precedidos de un tratamiento, sin latencia añadida y sin que nada salga de su perímetro. Los nombres que también son palabras corrientes solo se detectan con contexto con forma de nombre; los nombres poco frecuentes siguen siendo tarea del directorio o del NER.
Modelos NER a elegir
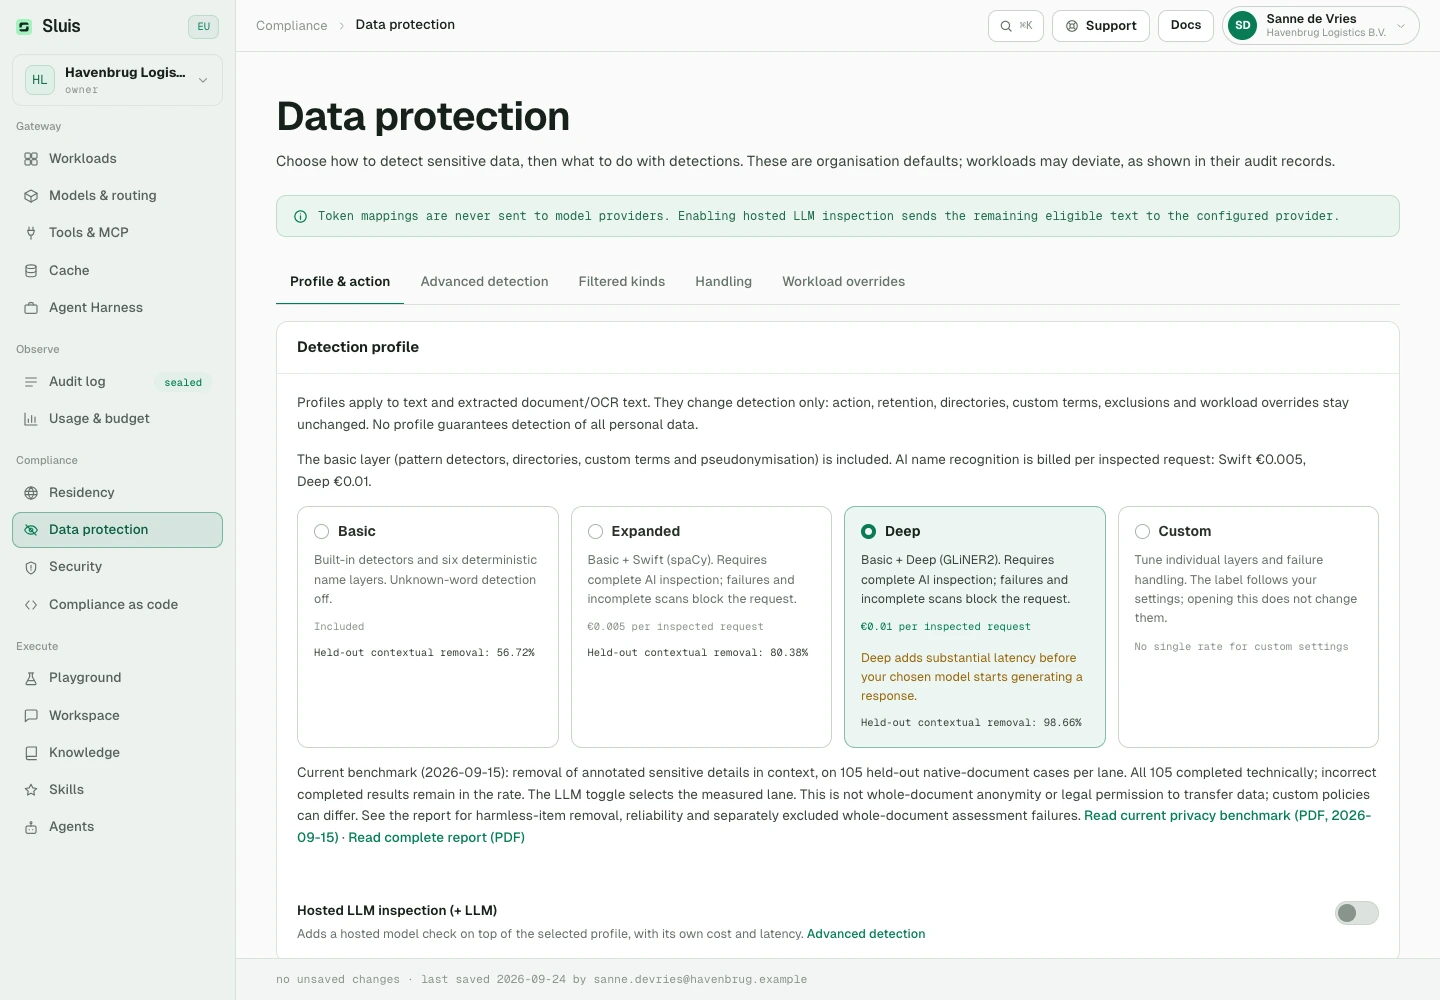
Elija Básico, Ampliado o Profundo en Protección de datos. Básico usa detectores integrados y seis capas deterministas de nombres, sin llamar a un modelo; es el valor inicial de las nuevas organizaciones. Ampliado añade Swift (spaCy); Profundo añade GLiNER2-PII en su lugar. Ambos perfiles de IA exigen inspección completa y bloquean fallos del modelo o análisis incompletos. Profundo requiere más procesamiento, sin garantizar mayor cobertura. Personalizado permite ajustes individuales. Las políticas existentes, exclusiones, directorios y excepciones de workloads se conservan; las palabras desconocidas siguen desactivadas en los tres perfiles. Un workload no puede activar NER si la organización lo desactiva. El reconocimiento de nombres por IA se factura una vez por cada petición de cliente inspeccionada: 0,005 € con Swift (Ampliado), 0,01 € con GLiNER2 (Profundo); Básico está incluido. Las llamadas posteriores que Sluis hace dentro de esa petición no se vuelven a facturar, y una inspección incompleta no cuesta nada. Cada cargo es un comprobante de auditoría vinculado que cuenta para sus presupuestos.
Profundo añade una latencia considerable antes de que el modelo elegido empiece a generar una respuesta. El tiempo de análisis de Swift y GLiNER2 depende de la longitud del texto, el número de mensajes y el hardware. El límite abarca todo el análisis NER de los mensajes, adjuntos y ventanas de una solicitud, no cada ventana: 30 segundos hasta 320.000 caracteres, más 30 segundos por cada 320.000 caracteres adicionales, 10 minutos como máximo. Es un máximo, no la latencia habitual. La inspección LLM alojada opcional añade una espera independiente antes de generar la respuesta, según el texto, la carga del proveedor y los reintentos; queda fuera de este límite NER.
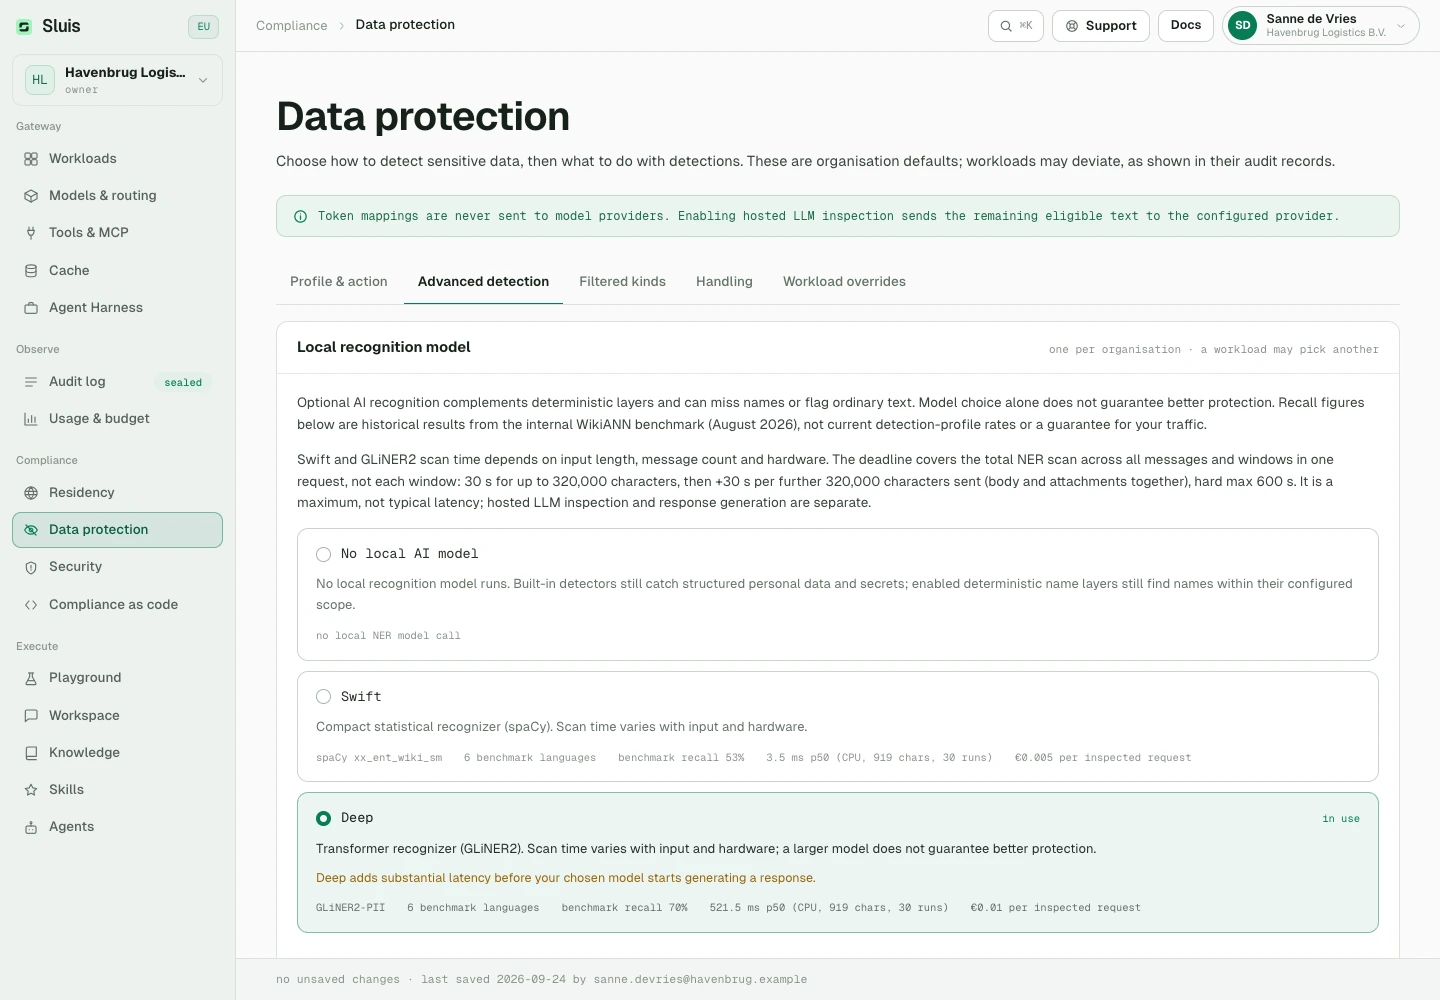
| Modelo | Cobertura | Precisión medida | Latencia |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Medido el 2026-08-12 en un benchmark interno: frases de prueba de WikiANN en seis idiomas (NL, EN, DE, FR, ES, IT; 150 por idioma), puntuadas como micro-F1 sobre pares (etiqueta, texto) a nivel de texto con el filtro de falsos positivos de producción aplicado, en una máquina de desarrollo Apple Silicon en FP32. WikiANN es material de Wikipedia con anotación automática y el terreno de entrenamiento de spaCy: lea las cifras como guía relativa entre niveles, no como precisión absoluta en campo.
Análisis de seguridad
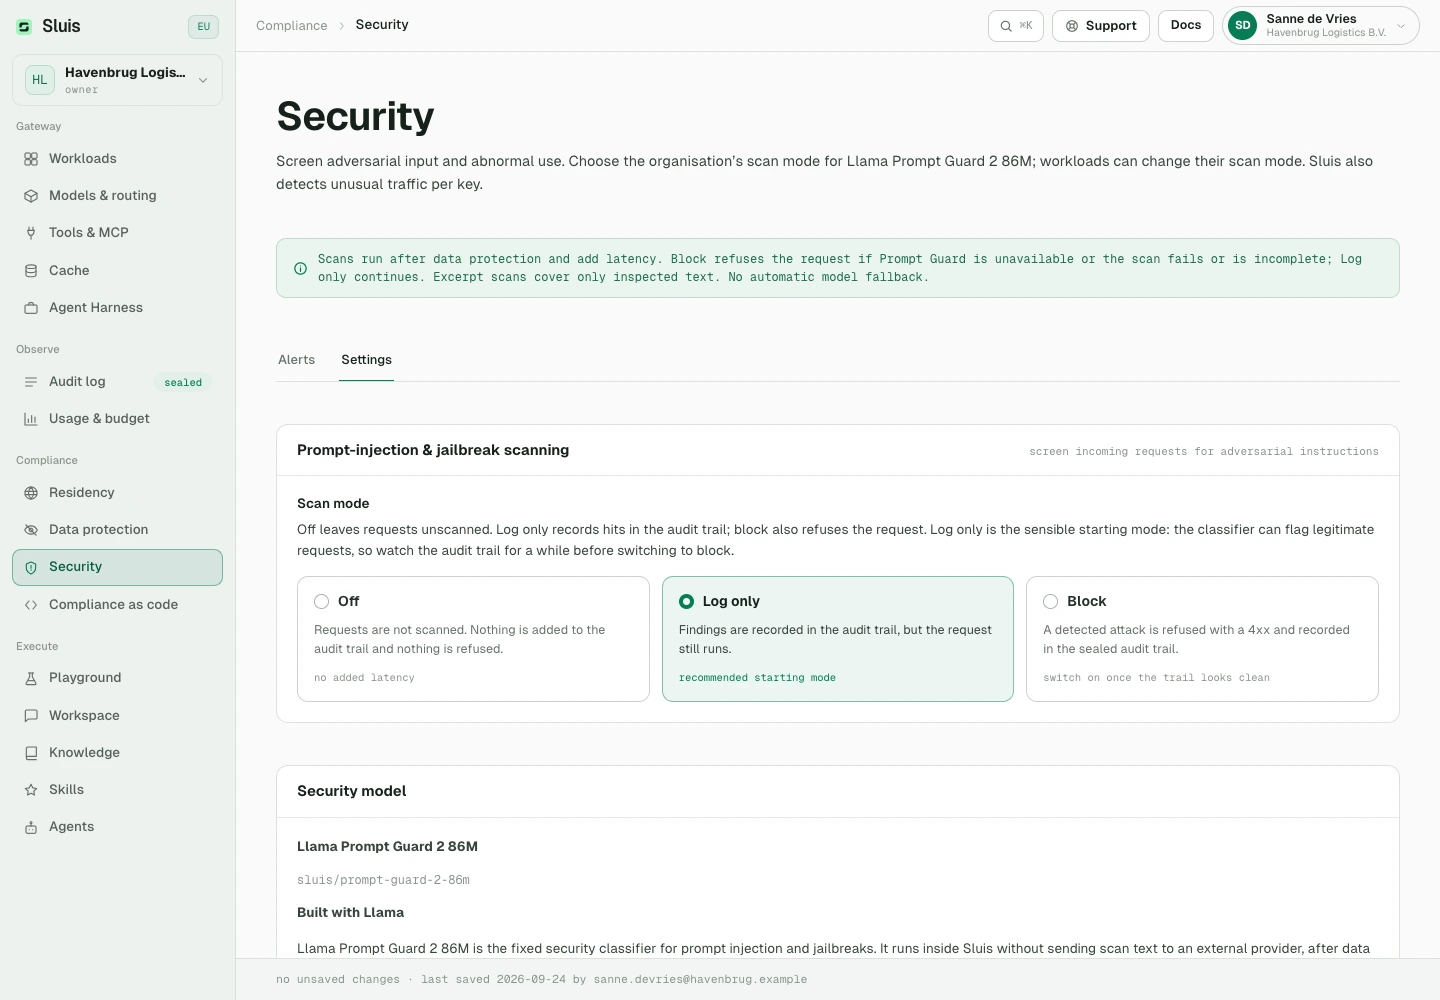
Detección opcional de inyecciones de prompt y jailbreaks en la esclusa, analizada antes del despacho. Tres modos: off | log | block. off omite el análisis. log registra las detecciones sin bloquear el tráfico. block rechaza los ataques detectados y bloquea si el modelo no está disponible o la clasificación falla o queda incompleta. Sin cambio automático de modelo.
La seguridad siempre usa Llama Prompt Guard 2 86M (sluis/prompt-guard-2-86m), dentro de Sluis sin transferir el texto al exterior. 0,01 EUR por análisis lógico completado, una vez independientemente de las ventanas o el veredicto, incluidos los extractos seguros; sin recargo por tokens. Desactivado, rechazos previos y errores técnicos no se cobran. Las ventanas solapadas de hasta 512 tokens del modelo conservan los segmentos, dentro del presupuesto total configurado de 4096 a 65536 tokens. El umbral fijo es 0,8. El análisis sigue a la protección de datos, que puede conservar datos personales si está desactivada o solo registra. Los análisis añaden latencia y tienen plazos limitados. Las entradas largas usan extractos; un veredicto seguro solo cubre el texto inspeccionado. Audit registra bytes inspeccionados y totales. Built with Llama. Meta Llama 3.1 Community License.
Cada análisis tiene una entrada de auditoría facturable separada y vinculada: security.scan. Puede haber cargos aunque la solicitud original se bloquee o se responda desde la caché. Las excepciones por workload pueden cambiar el modo de análisis. Por separado, la inspección de privacidad Nemotron opcional usa Nebul según su política de residencia y se factura por tokens.
Por separado, la detección opcional de anomalías del comportamiento de las claves corre como trabajo en segundo plano, sin latencia alguna en las peticiones: líneas base por clave con estadística robusta y estacionalidad hora-de-semana, más una capa multivariante de bosque de aislamiento. Las alertas son explicables, nunca una puntuación desnuda, y llegan a la vista Seguridad de la Consola, con correo opcional.
Aviso al modelo
Cuando la tokenización reescribió una petición, Sluis inyecta un mensaje de sistema inicial que indica al modelo que los tokens «…» son marcadores opacos que debe mantener intactos; eso es lo que hace fiable la restauración. Activado por defecto; personalícelo o desactívelo por organización.
Retención y fidelidad de auditoría
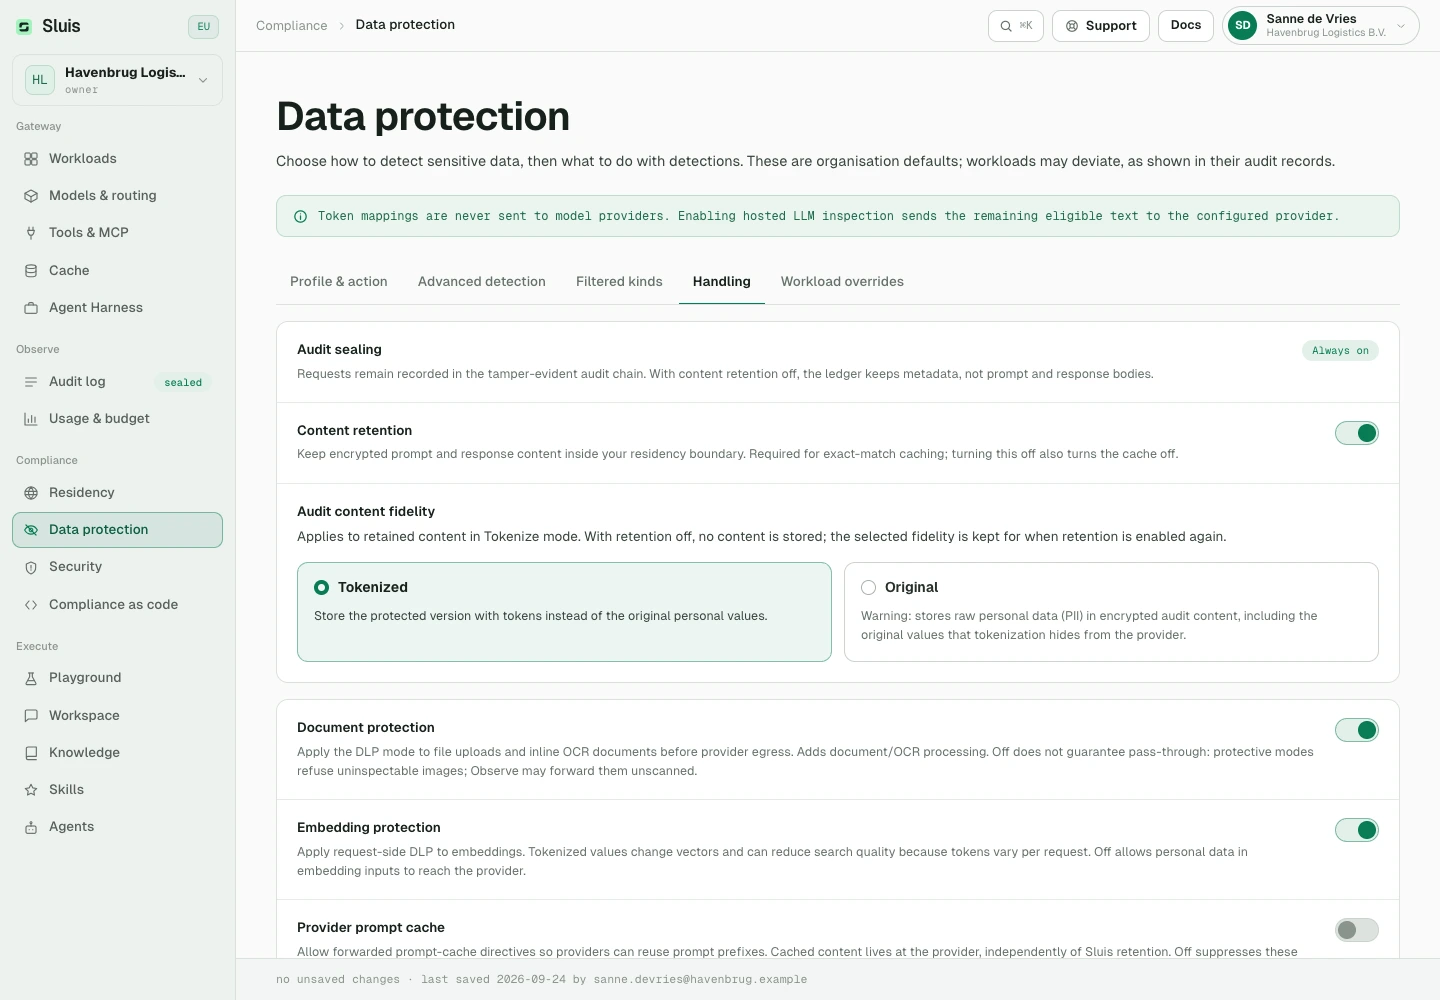
La retención de contenido (los cuerpos de petición y respuesta para el registro de auditoría) está activada por defecto y cifrada en reposo; la fidelidad de auditoría decide si el contenido retenido guarda los tokens o los valores originales. El contenido retenido se guarda hasta que usted lo borre, salvo que fije un plazo de retención en días en la vista Protección de datos de la Consola. Una purga diaria aplica el plazo vigente al contenido ya almacenado, así que acortarlo también elimina contenido más antiguo. El contenido de los chats de Sluis Workspace se elimina tras el menor entre ese plazo y el plazo de Workspace para los valores personales de los chats (7 días por defecto). El registro de metadatos de auditoría se conserva y nunca se modifica. Desactive la retención para un registro solo de metadatos; eso también desactiva la caché de respuesta.
Anonimización de documentos
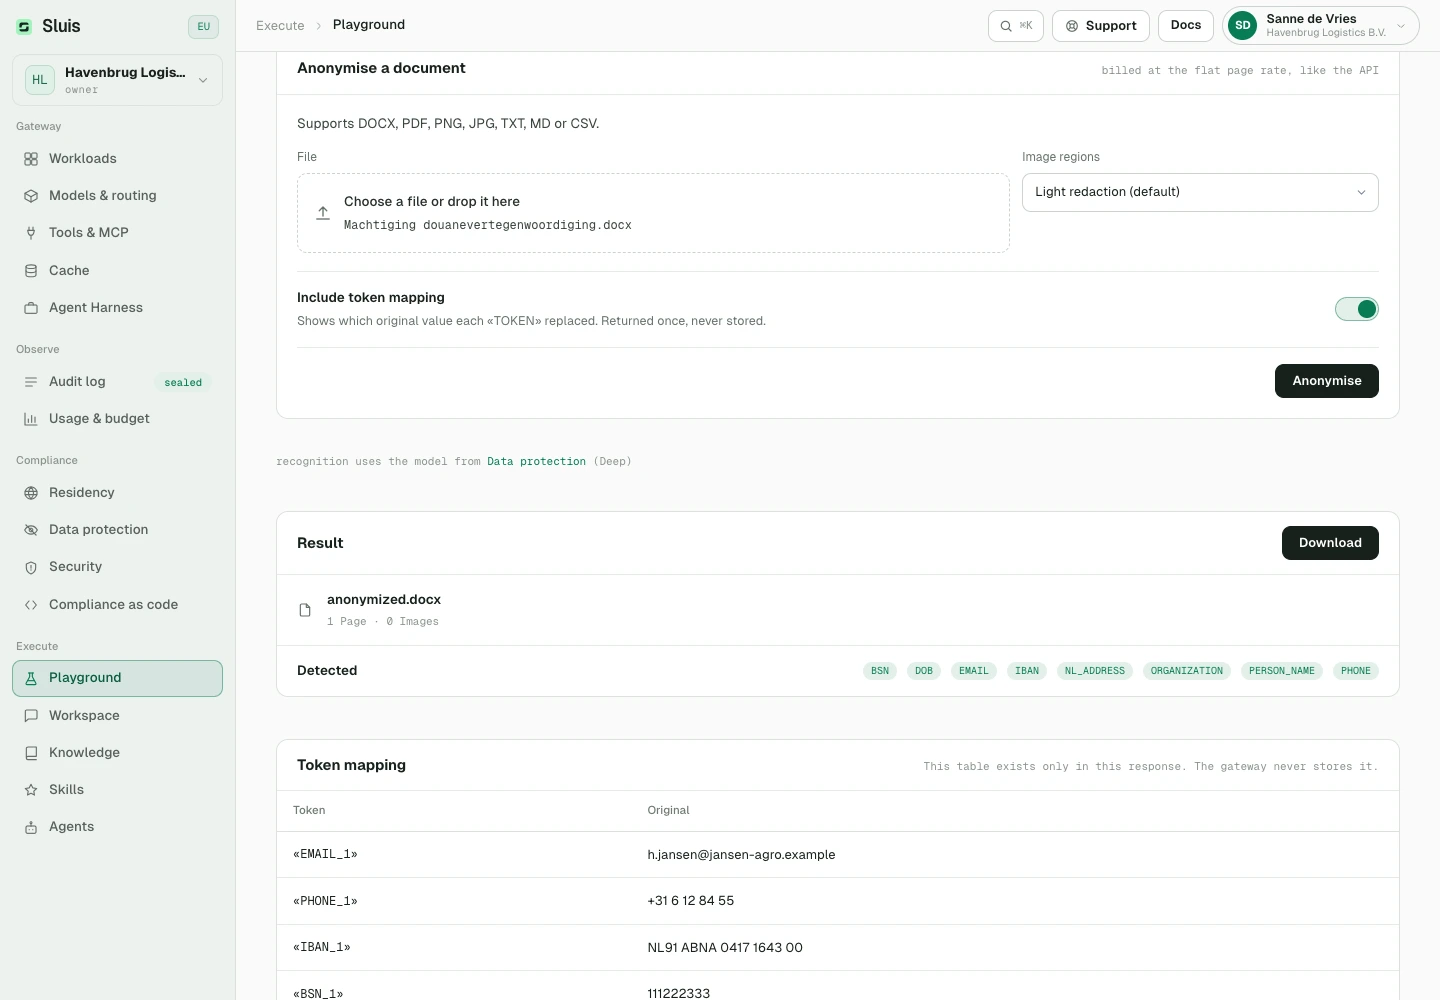
Envíe un archivo docx, pdf, imagen o texto a POST /v1/documents/anonymize y el mismo documento vuelve con los PII y secretos sustituidos por etiquetas como «PERSON_NAME_1» en el texto, y difuminados en imágenes y páginas PDF. El procesamiento es local a la gateway, OCR incluido; la operación se sella en la cadena de auditoría y se factura por página/imagen. El mapa de tokens solo se devuelve si usted lo pide y nunca se almacena. Los PDF censurados conservan una capa de texto invisible y buscable construida a partir del texto anonimizado. Para documentos grandes, encole un trabajo asíncrono y recoja el resultado más tarde con una URL firmada de duración limitada. En los escaneos, las líneas que el OCR no puede leer con fiabilidad, como firmas y escritura a mano ilegible, y la tinta fuera de toda línea de texto reconocida, como rúbricas y sellos, se destruyen en lugar de adivinarse. Aparecen como «UNREADABLE» en la capa de texto y la respuesta indica la categoría UNREADABLE_REDACTED.
La misma protección funciona en tránsito: con la política dlp_documents activa, los archivos subidos por /v1/files y los documentos OCR inline se anonimizan antes de salir hacia un proveedor, se rechazan en modo block y se analizan en modo allow_log.
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Los tokens pseudonimizados son estables dentro de una solicitud, no entre solicitudes; los embeddings de texto tokenizado pueden no coincidir entre llamadas. El ajuste dlp_embeddings controla si el análisis cubre /v1/embeddings: activado por defecto, ponerlo en off envía las entradas de embedding al proveedor sin analizar. Cada llamada exenta queda registrada en el registro de auditoría.
Términos a eliminar por petición
Cualquier petición JSON del plano de datos — chat completions, completions, embeddings, responses y los ingress nativos de Anthropic — puede llevar una extensión sluis de nivel superior. Su lista remove nombra los términos que la gateway debe eliminar del prompt antes del envío: una cadena simple, o un objeto con un text y un kind de entre person | organization | location | term. Como máximo 128 entradas, cada una no vacía tras el recorte y de hasta 256 caracteres; la coincidencia es por límites de palabra y no distingue mayúsculas. La extensión misma es una construcción de la gateway y siempre se retira antes del envío: nunca llega a un proveedor, ni a la caché, ni al contenido conservado.
# name the terms the gateway must remove — the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out — the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Cada coincidencia se convierte en un token reversible — «PERSON_NAME_1» — que se suma a la pasada de pseudonimización normal: en modo tokenize, el predeterminado, los valores originales se restauran en la respuesta, streaming incluido; en modo mask el término se sustituye por [REDACTED:<kind>]; en modo block la petición se rechaza con 422. La instrucción se respeta siempre, aunque la clave fije dlp: off, la organización funcione en allow_log o /v1/embeddings esté exento: solo puede reforzar la protección, nunca debilitarla, y por eso se admite por petición allí donde la cabecera retirada x-sluis-dlp no lo estaba. El término listado nunca llega al proveedor.
Una directiva malformada nunca se ignora en silencio: un kind desconocido, una entrada fuera de los límites o un campo desconocido dentro de la extensión se rechazan con 422. Lo que realmente se ejecutó se divulga en la fila de auditoría sellada, donde los términos aportados por quien llama llevan la capa request — dlp:tokenize:person_name(request) — distinta de las capas (ner) y (directory), de modo que el registro muestra de dónde vino cada eliminación. La misma lista se acepta como opción remove en /v1/documents/anonymize y sus trabajos asíncronos.
Excepciones del workload
Las excepciones pertenecen al workload y se aplican a todas sus credenciales. Un owner o admin configura option_overrides en Console → Workloads o con POST /admin/workloads al crear un workload. Las opciones no definidas heredan la política de la organización. Para editarlo, PATCH /admin/workloads/{workload_id} requiere todos sus ajustes modificables, incluidos nombre, estado, límites y presupuesto; los reemplaza sin fusionar campos.
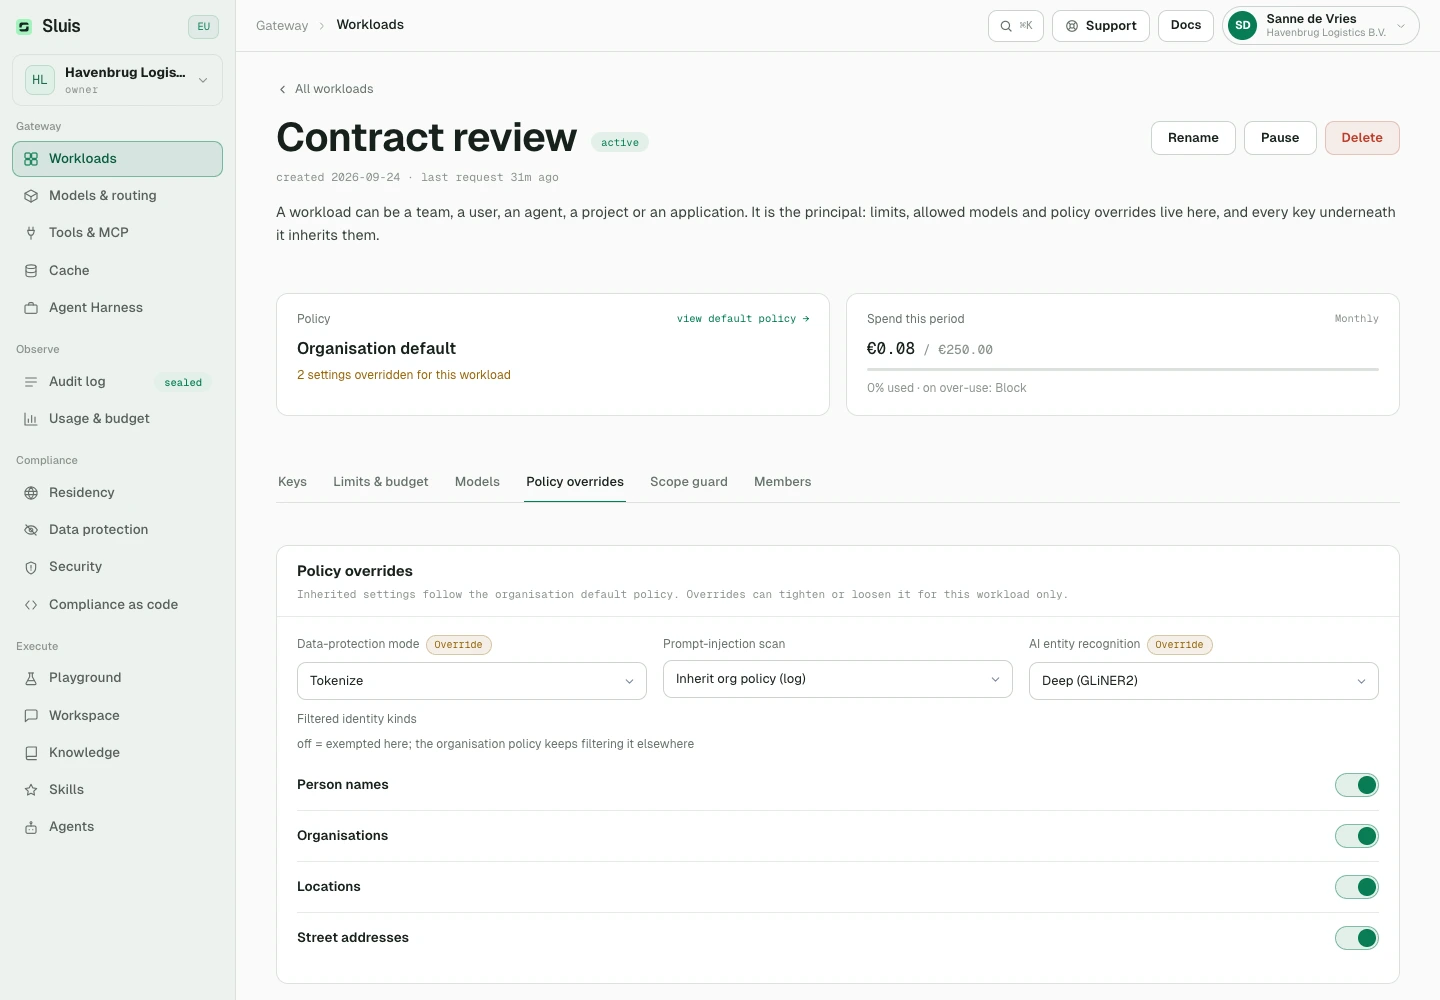
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "mode": "off" },
        "ner_model": "deep",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
La cabecera de petición x-sluis-dlp se ha eliminado. Las peticiones que la incluyen reciben 400; configure el workload. Las excepciones efectivas se registran en el historial de auditoría sellado.