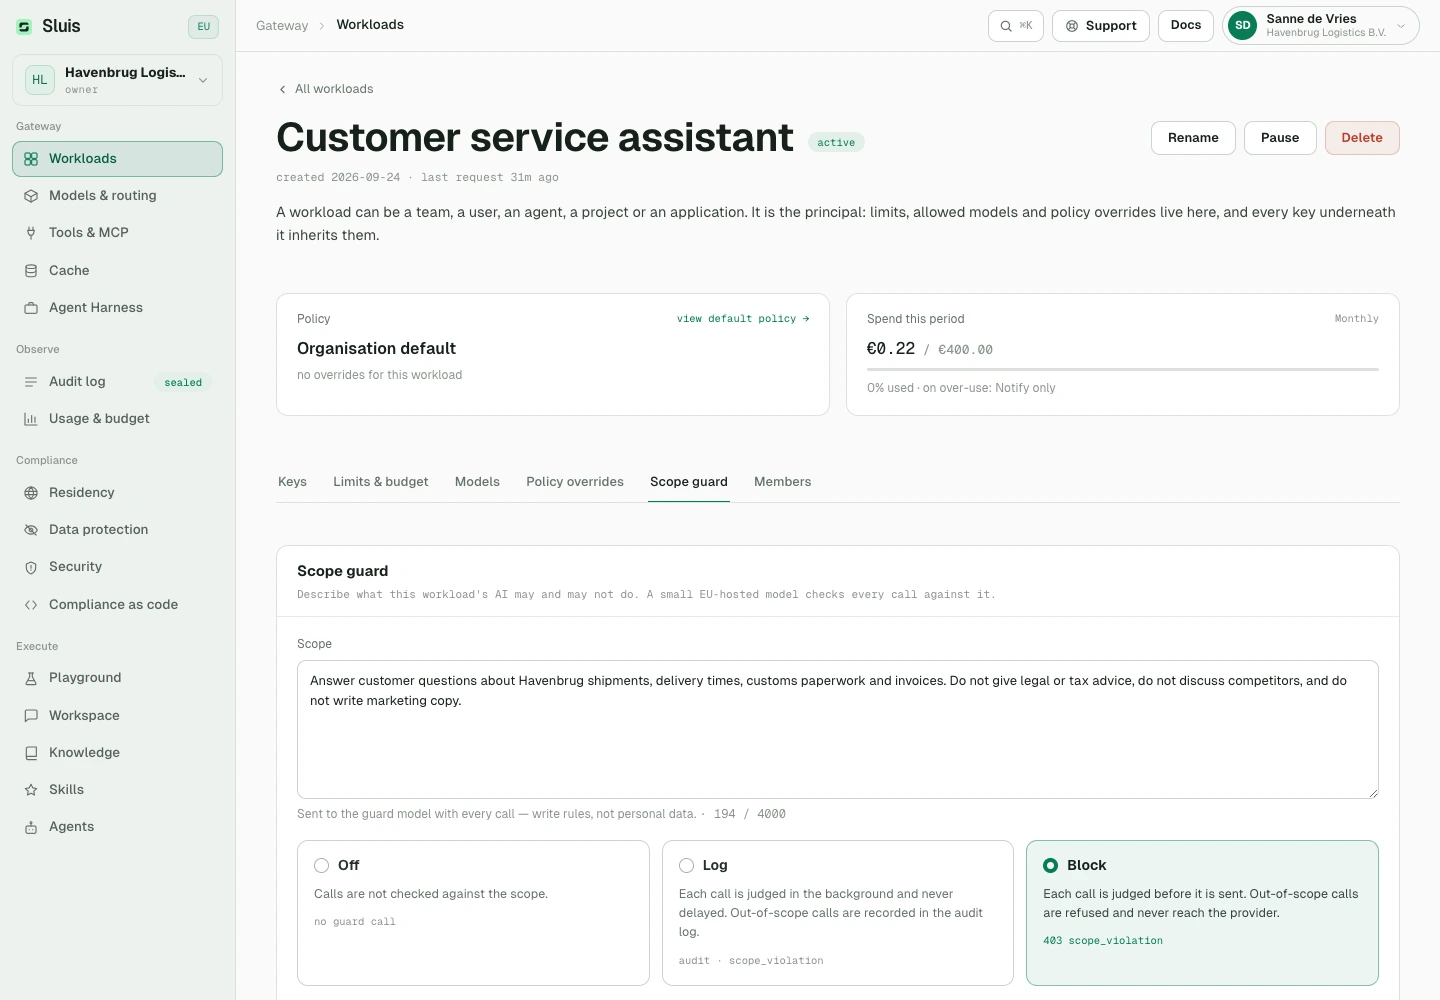
Workloads
Ein Workload bündelt Einstellungen für ein Team, einen Benutzer, einen Agenten oder eine Anwendung. API-Schlüssel sind die zugehörigen Zugangsdaten.
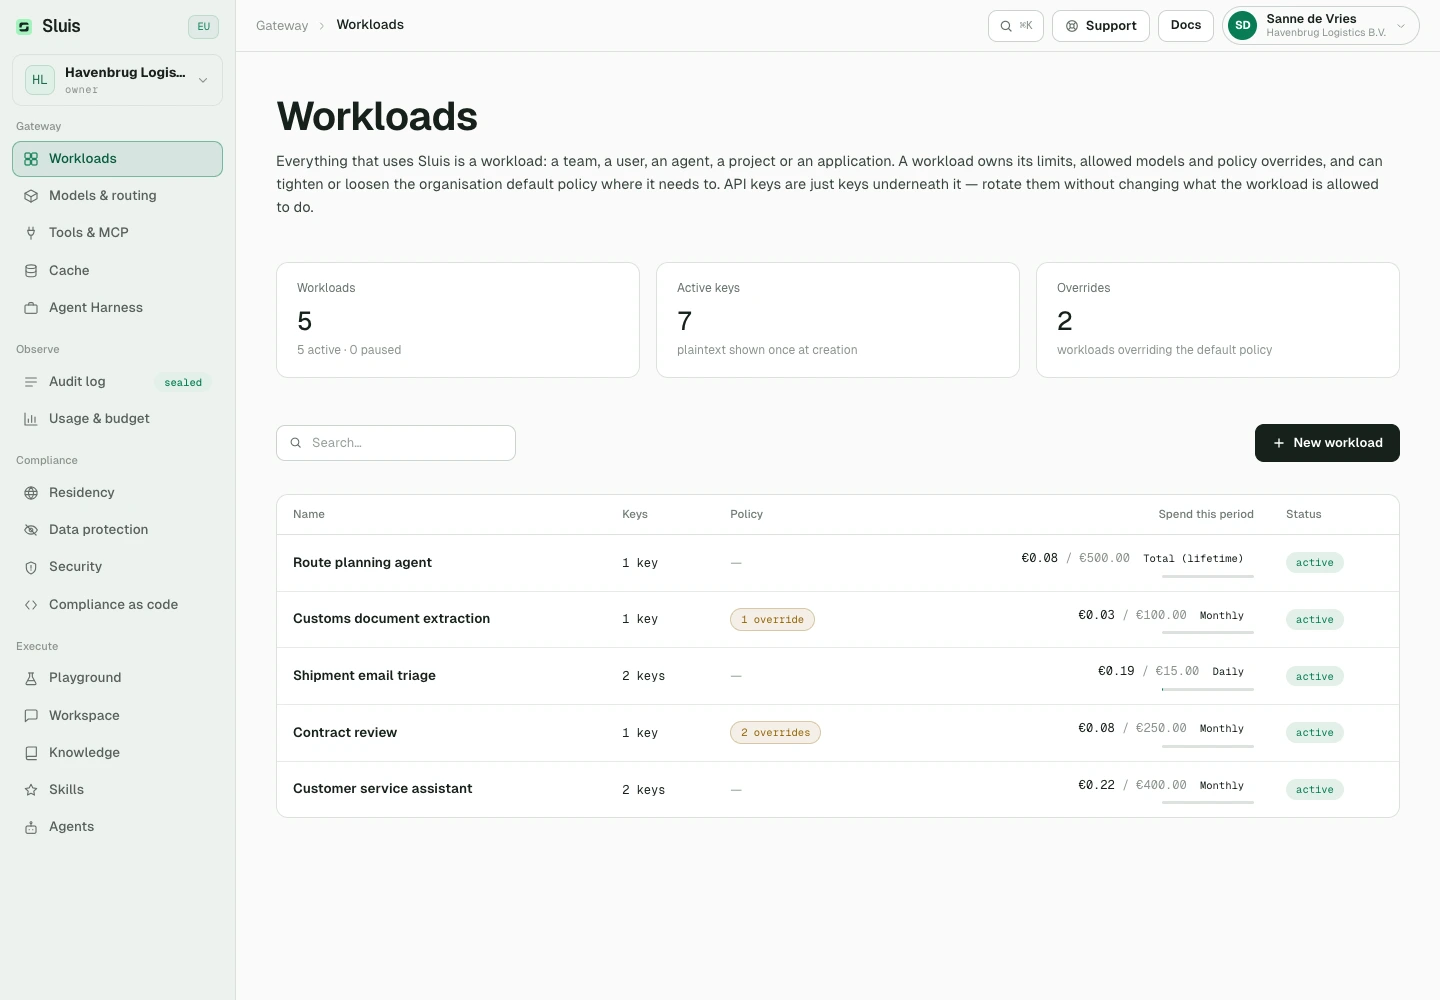
Legen Sie Modelle, Anfragen und Tokens pro Minute sowie ein tägliches, monatliches oder gesamtes Budget fest. block stoppt Aufrufe bei Überschreitung (402); notify lässt sie weiterlaufen.
Unter Limits & Budget legt die Antwortfrist fest, wie lange ein Modellaufruf auf die Antwort des Anbieters wartet: 10 bis 600 Sekunden, standardmäßig 300. Ein Aufruf ohne rechtzeitige Antwort endet mit 504 und wird nicht wiederholt, weil der Anbieter noch daran arbeiten kann. Ein Aufrufer kann die Frist pro Anfrage mit dem Header x-sluis-upstream-timeout verkürzen, nie verlängern. Eine bereits begonnene gestreamte Antwort wird dadurch nicht abgeschnitten; nur 600 Sekunden Stille im laufenden Stream beenden sie.
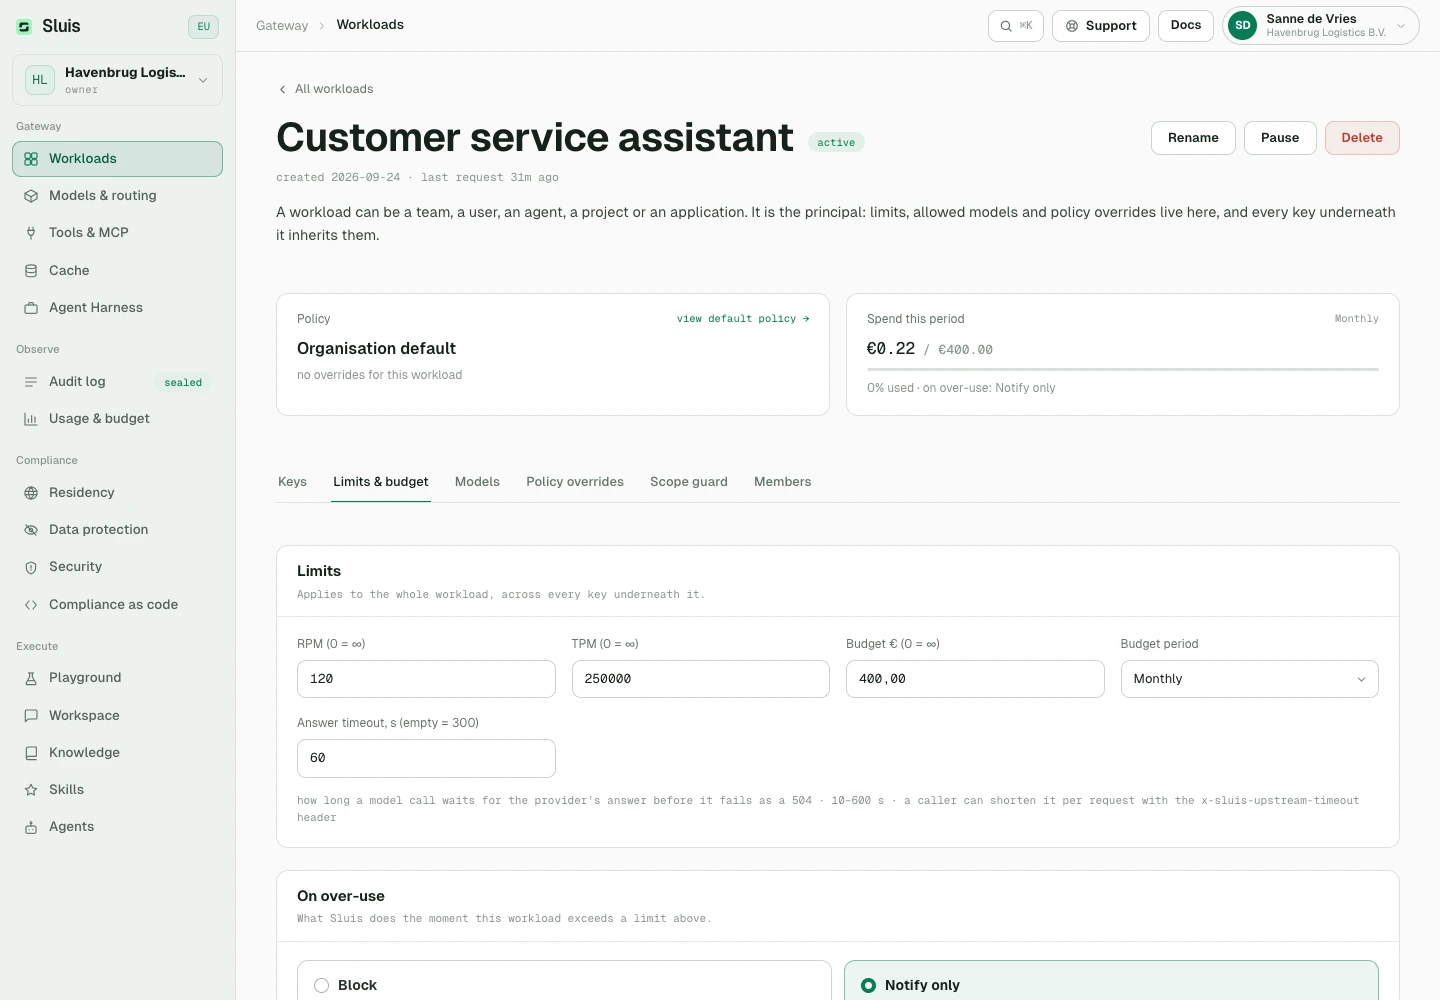
Ein leeres option_overrides übernimmt Organisationsvorgaben. Pausieren verweigert Anfragen (403), ohne Schlüssel zu widerrufen. Schlüsselrotation behält die Workload-Richtlinie bei.
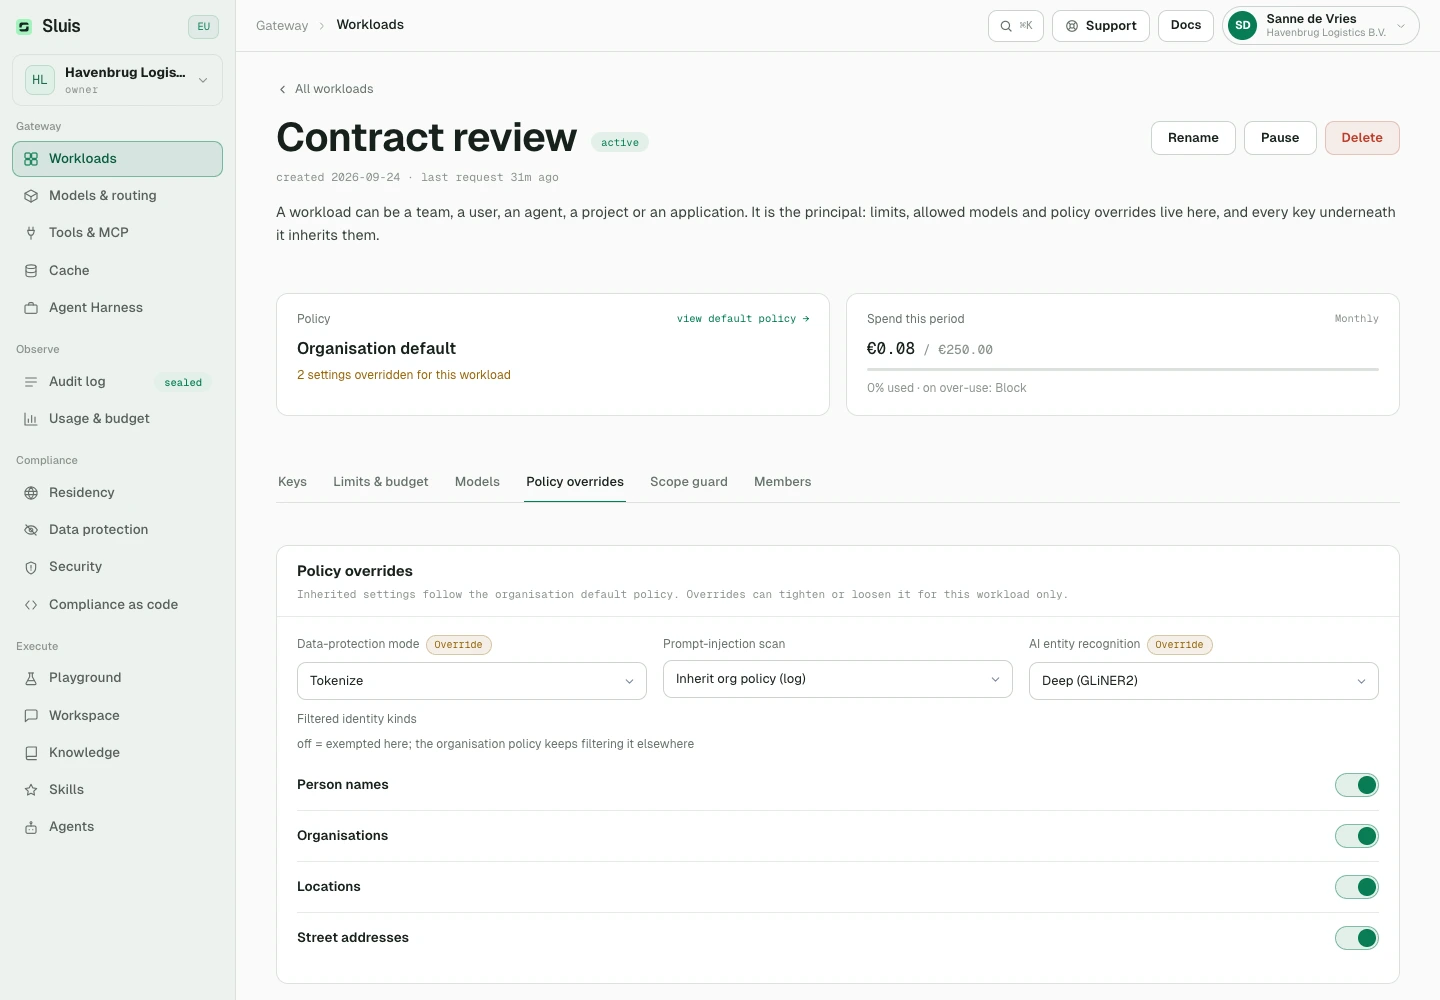
Der Scope-Guard prüft jeden Modellaufruf mit den Schlüsseln des Workloads (außer Embeddings) gegen einen Einsatzbereich, den Sie in Klartext beschreiben: was die KI dieses Workloads darf und was nicht, bis zu 4.000 Zeichen. Ein kleines, in der EU gehostetes Modell (Mistral Small) beurteilt jeden Aufruf nach dem Datenschutz, anhand des Texts, den der Anbieter erhalten würde. off schaltet die Prüfung ab. log urteilt im Hintergrund, ohne den Aufruf zu verzögern, und hält Aufrufe außerhalb des Einsatzbereichs im Audit-Log fest. block wartet auf das Urteil und weist einen Aufruf außerhalb des Einsatzbereichs mit 403 scope_violation ab, bevor er den Anbieter erreicht; kann die Prüfung nicht abgeschlossen werden, wird der Aufruf mit 503 abgewiesen. Jede Prüfung ist ein eigener Audit-Beleg, abgerechnet zum Tokenpreis des Modells, und Ihre Residency-Policy muss dieses Modell erlauben.