Datenschutz
Erkennungsmodi, die Bibliothek mit 60 Detektoren, Entitätserkennung samt wählbarer Modelle, Security-Scanning, der Modellhinweis und Aufbewahrung.
Der Datenschutz läuft bei jeder Anfrage vor dem Versand. Der Standardmodus ist tokenize: jeder erkannte Wert wird durch ein stabiles typisiertes Token wie «EMAIL_1». Erkannte Werte erreichen den Anbieter nur als Tokens, und die Antwort wird auf dem Rückweg zu Ihnen wieder auf die echten Werte zurückgesetzt, gestreamt oder nicht. Die Token-Zuordnung lebt für die Dauer der Anfrage im Speicher und wird niemals persistiert. Die Pseudonymisierung wirkt in eine Richtung: Sie schützt, was Sie senden. In Sluis Workspace werden öffentliche Websuchergebnisse und die eigene Ausgabe des Modells aus derselben Runde nicht neu tokenisiert; ein Wert, den die Unterhaltung bereits tokenisiert hat, bleibt durch sein Token ersetzt, und das Audit-Log vermerkt, wann dies galt.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives — only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back — restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Weitere Modi: mask schreibt erkannte Werte irreversibel um, block weist die Anfrage mit 422 ab, und allow_log lässt sie durch und markiert dabei die Audit-Zeile.
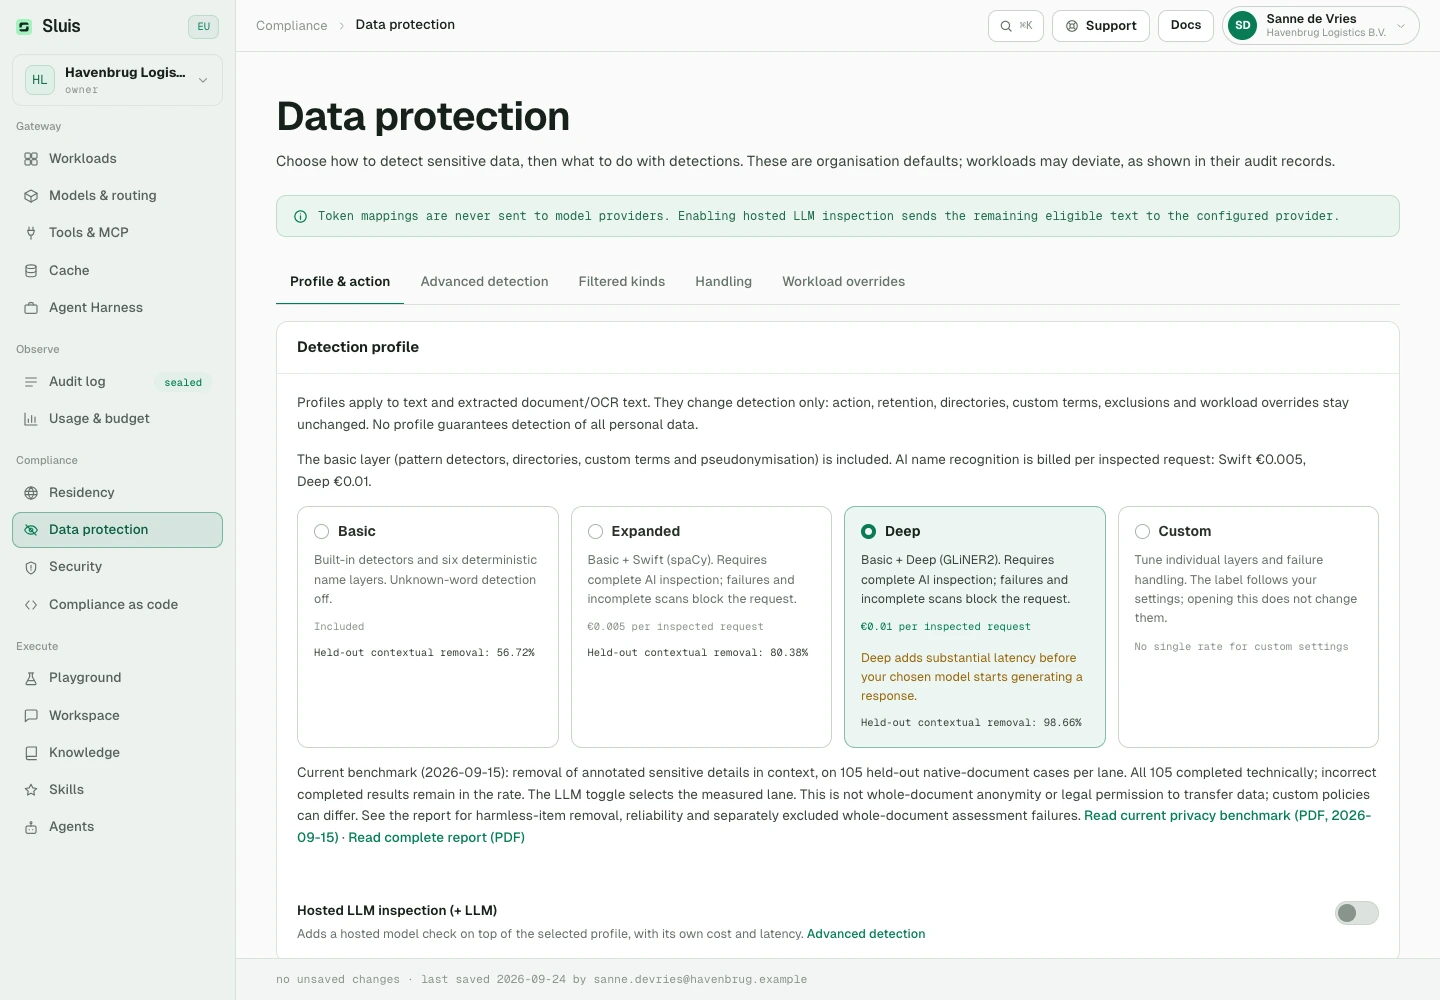
60 integrierte Detektoren sind von Haus aus dabei: 28 für personenbezogene Daten, von der US Social Security Number bis zum Paket nationaler IDs, das 12 EU-Länder per Prüfsumme validiert, und 32 für Secrets und Zugangsdaten. Jeder lässt sich pro Organisation schalten, und eigene Begriffe (Klartext oder Regex) decken alles ab, was für Ihr Geschäft spezifisch ist:
Entitätserkennung
Personen, Organisationen und Orte lassen sich allein per Muster schwer erkennen. Sluis kombiniert Kontextheuristiken, E-Mail-Korrelation, ein Mandantenverzeichnis, mitgelieferte Wörterbücher und optionales NER. Das NER-Modell läuft als netzwerkinterner Sidecar: Text bleibt innerhalb des Deployments. Diese Schichten prüfen auch extrahierten Dokument- und OCR-Text, wenn der Dokumentenschutz aktiviert ist. Mit aktivem NER darf eine Anfrage bis zu 100.000 verschiedene Entitäten nennen; oberhalb dieser Grenze gilt der Scan als unvollständig. Ein Name, den das Modell einmal erkennt, wird überall ersetzt, wo er in der Anfrage wieder vorkommt, als dasselbe ganze Wort in gleicher Groß- und Kleinschreibung und mit demselben Token, auch in Nachrichten, in denen das Modell ihn nicht gemeldet hat. Einzelne allgemeine Wörter und kurze Akronyme gelten nur an der vom Modell gemeldeten Stelle.
Das Namenswörterbuch ist das deterministische Gegenstück zu NER: Vor- und Nachnamen, aus offenen Behördendaten zu einem Wörterbuch kompiliert, das im Gateway mitgeliefert wird. Es erkennt vollständige Namen und Namen nach einer Anrede, ohne zusätzliche Latenz und ohne dass etwas Ihren Perimeter verlässt. Namen, die zugleich gewöhnliche Wörter sind, werden nur mit namensartigem Kontext erkannt; seltene Namen bleiben Sache des Verzeichnisses oder des NER.
NER-Modelloptionen
Wählen Sie Basis, Erweitert oder Tiefgehend unter Datenschutz. Basis verwendet eingebaute Detektoren und sechs deterministische Namensschichten ohne Modellaufruf; neue Organisationen starten damit. Erweitert ergänzt Swift (spaCy), Tiefgehend stattdessen GLiNER2-PII. Beide KI-Profile verlangen vollständige Prüfung und blockieren Modellfehler oder unvollständige Scans. Tiefgehend braucht mehr Rechenzeit, garantiert aber keine höhere Trefferquote. Benutzerdefiniert erlaubt einzelne Anpassungen. Bestehende Richtlinien, Ausschlüsse, Verzeichnisse und Workload-Abweichungen bleiben unverändert; unbekannte Wörter sind in allen drei Profilen aus. Ein Workload kann NER nicht einschalten, wenn die Organisation es ausschaltet. Die KI-Namenserkennung wird einmal pro geprüfter Kundenanfrage abgerechnet: 0,005 € mit Swift (Erweitert), 0,01 € mit GLiNER2 (Tiefgehend); Basis ist inklusive. Folgeaufrufe, die Sluis innerhalb dieser Anfrage macht, werden nicht erneut berechnet, und eine unvollständige Prüfung kostet nichts. Jede Abrechnung ist ein verknüpfter Audit-Beleg, der auf Ihre Budgets angerechnet wird.
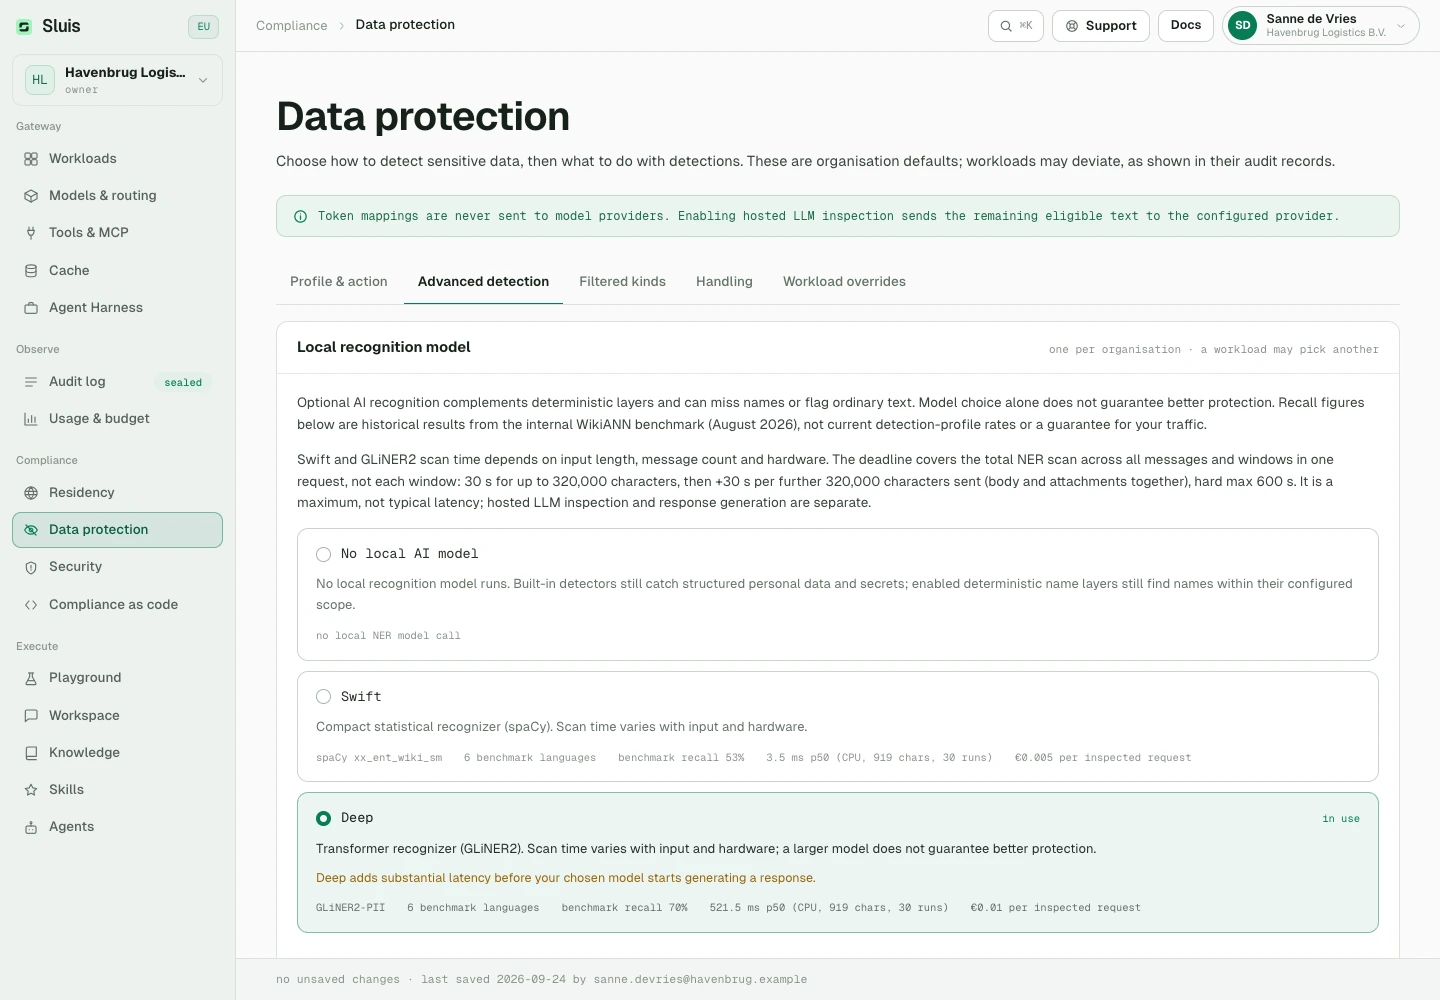
Tiefgehend verursacht erhebliche zusätzliche Latenz, bevor Ihr gewähltes Modell eine Antwort erzeugt. Die Scanzeit von Swift und GLiNER2 hängt von Eingabelänge, Nachrichtenanzahl und Hardware ab. Die Frist gilt für den gesamten NER-Scan aller Nachrichten, Anhänge und Fenster einer Anfrage, nicht pro Fenster: 30 Sekunden bis 320.000 Zeichen, dann 30 Sekunden mehr je weitere 320.000 Zeichen, höchstens 10 Minuten. Das ist ein Höchstwert, keine typische Latenz. Die optionale gehostete LLM-Prüfung fügt vor der Antwortgenerierung weitere Wartezeit hinzu, abhängig von Eingabe, Anbieterauslastung und Wiederholungen; sie fällt nicht unter diese NER-Frist.
| Modell | Abdeckung | Gemessene Genauigkeit | Latenz |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Gemessen am 2026-08-12 in einem internen Benchmark: WikiANN-Testsätze in sechs Sprachen (NL, EN, DE, FR, ES, IT; 150 pro Sprache), bewertet als Mikro-F1 über (Label, Text)-Paare auf Textebene mit angewandtem Produktions-Fehlalarmfilter, auf einer Apple-Silicon-Entwicklungsmaschine in FP32. WikiANN ist automatisch annotiertes Wikipedia-Material und spaCys Heimterrain: Lesen Sie die Zahlen als relative Orientierung zwischen den Stufen, nicht als absolute Feldgenauigkeit.
Security-Scanning
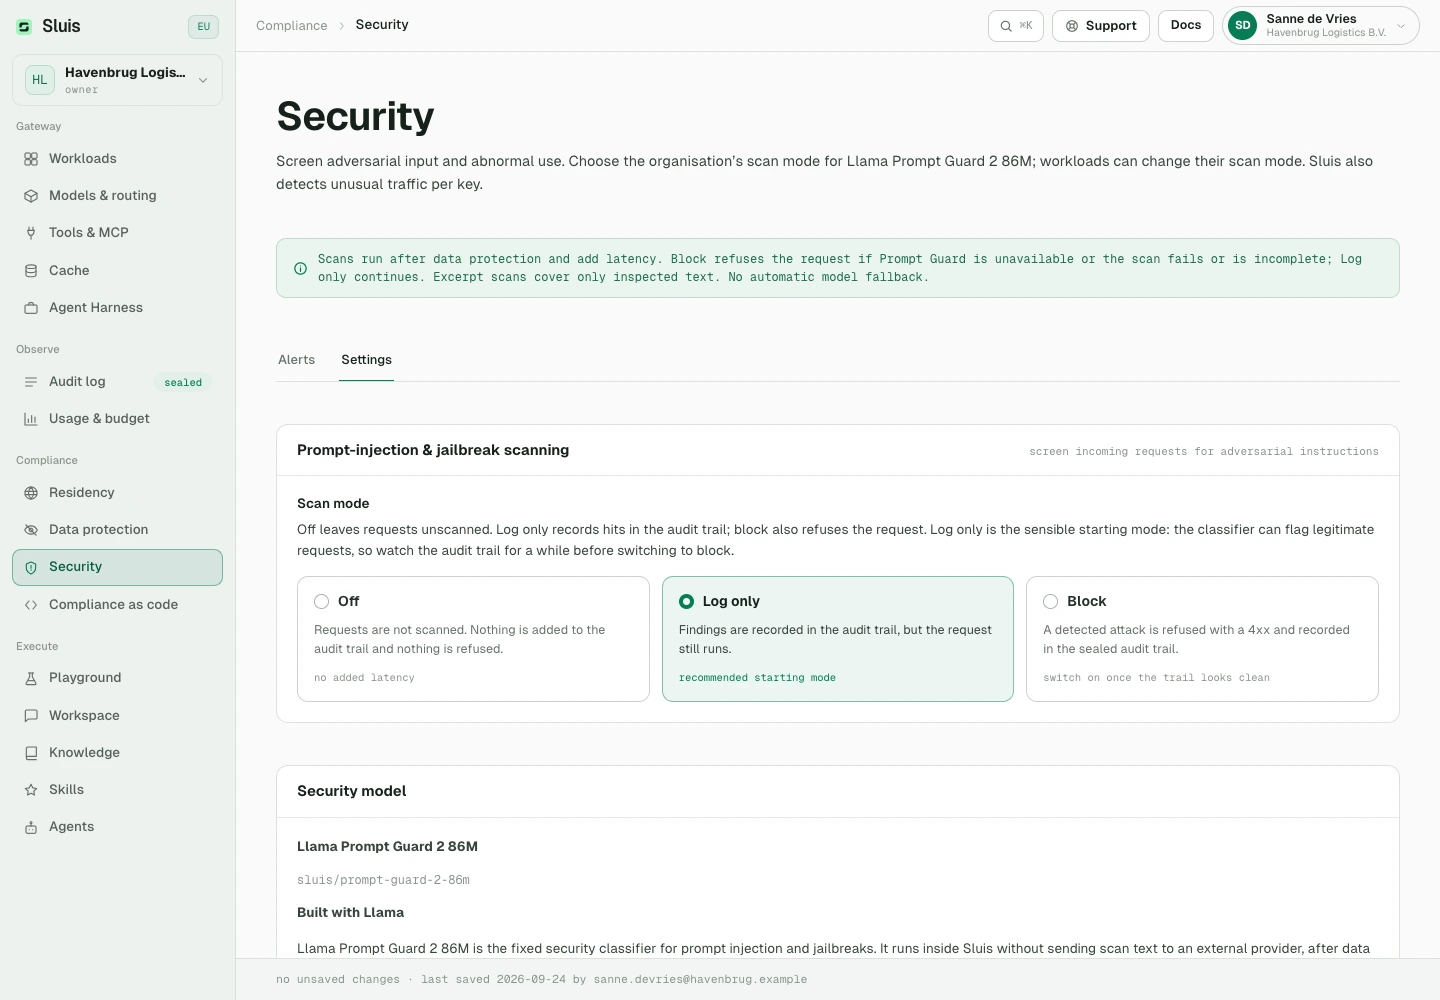
Optionale Prompt-Injection- und Jailbreak-Erkennung an der Schleuse, gescannt vor dem Versand. Drei Modi: off | log | block. off überspringt die Prüfung. log protokolliert Funde ohne den Verkehr zu blockieren. block verweigert erkannte Angriffe und blockiert bei nicht verfügbarem Modell sowie fehlgeschlagener oder unvollständiger Klassifikation. Kein automatischer Modellwechsel.
Die Sicherheit verwendet immer Llama Prompt Guard 2 86M (sluis/prompt-guard-2-86m), innerhalb von Sluis ohne externe Übertragung des Prüftexts. 0,01 EUR pro abgeschlossener logischer Prüfung, einmalig unabhängig von Fenstern und Urteil, auch bei sicheren Stichproben; kein Tokenaufschlag. Aus, Vorabverweigerungen und technische Fehler werden nicht berechnet. Überlappende Fenster mit höchstens 512 Modelltokens erhalten Segmentgrenzen innerhalb des konfigurierten Gesamtbudgets von 4096 bis 65536 Tokens. Die feste Erkennungsschwelle beträgt 0,8. Die Prüfung folgt dem Datenschutzfilter, der bei Aus oder reinem Protokollieren personenbezogene Daten beibehalten kann. Prüfungen erhöhen die Latenz und haben begrenzte Fristen. Lange Eingaben nutzen Auszüge; ein sicheres Urteil deckt nur geprüften Text ab. Audit erfasst geprüfte und gesamte Bytes. Built with Llama. Meta Llama 3.1 Community License.
Jede Prüfung hat einen separaten, verknüpften abrechenbaren Audit-Eintrag: security.scan. Kosten können auch bei blockierten oder aus dem Cache beantworteten Anfragen entstehen. Schlüsselbezogene Ausnahmen können den Prüfmodus ändern. Die separate optionale Nemotron-Datenschutzprüfung verwendet Nebul gemäß Ihrer Residenzrichtlinie und wird nach Tokens abgerechnet.
Getrennt davon läuft die optionale Anomalie-Erkennung des Key-Verhaltens als Hintergrund-Job ohne jede Request-Latenz: Baselines pro Key aus robusten Statistiken mit Wochenstunden-Saisonalität, plus eine multivariate Isolation-Forest-Ebene. Alerts sind erklärbar, nie ein nackter Score, und erscheinen im Bereich Sicherheit der Console, auf Wunsch per E-Mail.
Modell-Hinweis
Wenn die Tokenisierung eine Anfrage umgeschrieben hat, fügt Sluis eine vorangestellte System-Nachricht ein, die dem Modell mitteilt, dass die «…»-Tokens undurchsichtige Platzhalter sind, die es unversehrt lassen muss; genau das hält die Wiederherstellung zuverlässig. Standardmäßig aktiviert; pro Organisation anpassbar oder abschaltbar.
Aufbewahrung & Audit-Fidelität
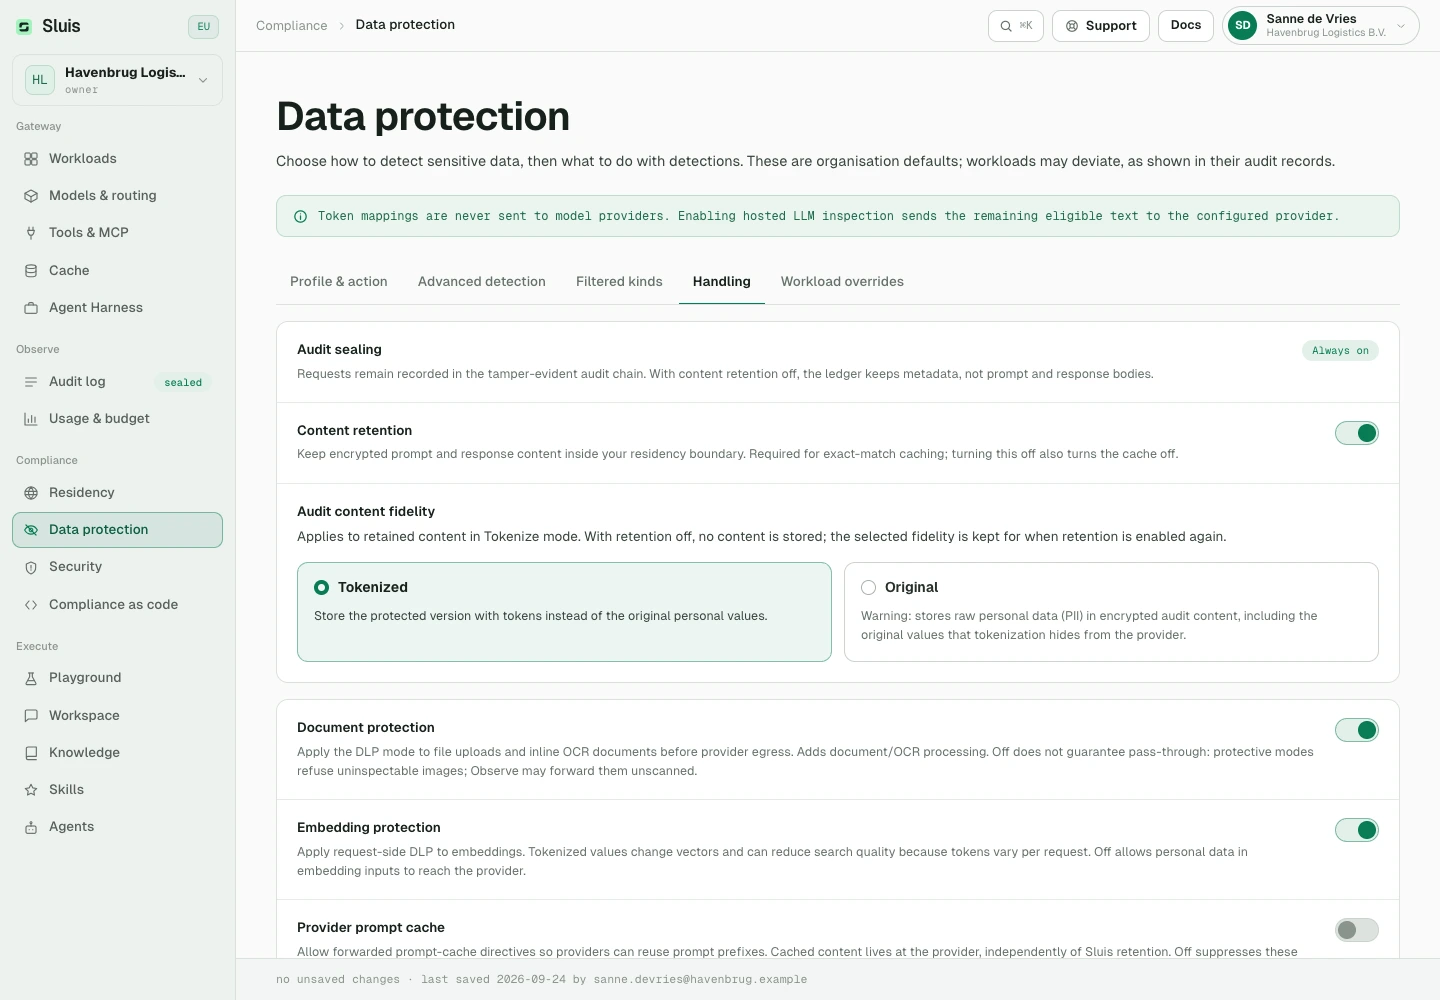
Die Inhaltsaufbewahrung (Request- und Response-Bodies für das Audit-Log) ist standardmäßig aktiv und im Ruhezustand verschlüsselt; die Audit-Fidelität entscheidet, ob der aufbewahrte Inhalt die Tokens oder die Originalwerte speichert. Aufbewahrter Inhalt bleibt erhalten, bis Sie ihn löschen, es sei denn, Sie legen in der Datenschutz-Ansicht der Console eine Aufbewahrungsfrist in Tagen fest. Eine tägliche Bereinigung wendet die aktuelle Frist auf bereits gespeicherten Inhalt an; eine kürzere Frist entfernt also auch älteren Inhalt. Inhalt aus Sluis Workspace-Chats wird nach der kürzeren dieser Frist und der Workspace-Frist für personenbezogene Werte in Chats gelöscht (standardmäßig 7 Tage). Das Register der Audit-Metadaten bleibt erhalten und wird nie verändert. Schalten Sie die Aufbewahrung ab für ein reines Metadaten-Register; das deaktiviert auch den Response-Cache.
Dokument-Anonymisierung
Senden Sie eine docx-, pdf-, Bild- oder Textdatei an POST /v1/documents/anonymize und dasselbe Dokument kommt zurück, mit PII und Secrets ersetzt durch Platzhalter wie «PERSON_NAME_1» im Text und unkenntlich gemacht in Bildern und PDF-Seiten. Die Verarbeitung bleibt lokal in der gateway, OCR inklusive; der Vorgang wird in der Audit-Kette versiegelt und pro Seite/Bild abgerechnet. Die Token-Zuordnung wird nur auf Anfrage zurückgegeben und nie gespeichert. Geschwärzte PDFs behalten eine unsichtbare, durchsuchbare Textebene aus dem anonymisierten Text. Für große Dokumente reihen Sie einen asynchronen Job ein und holen das Ergebnis später über eine zeitlich begrenzte signierte URL ab. Bei Scans werden Zeilen, die die OCR nicht zuverlässig lesen kann, etwa Unterschriften und unleserliche Handschrift, sowie Tinte außerhalb jeder erkannten Textzeile, etwa Paraphen und Stempel, vernichtet statt erraten. Sie erscheinen als «UNREADABLE» in der Textebene, und die Antwort meldet die Kategorie UNREADABLE_REDACTED.
Derselbe Schutz wirkt im Transit: mit aktiver dlp_documents-Policy werden über /v1/files hochgeladene Dateien und Inline-OCR-Dokumente vor dem Versand an einen Provider anonymisiert, unter block abgelehnt und unter allow_log gescannt.
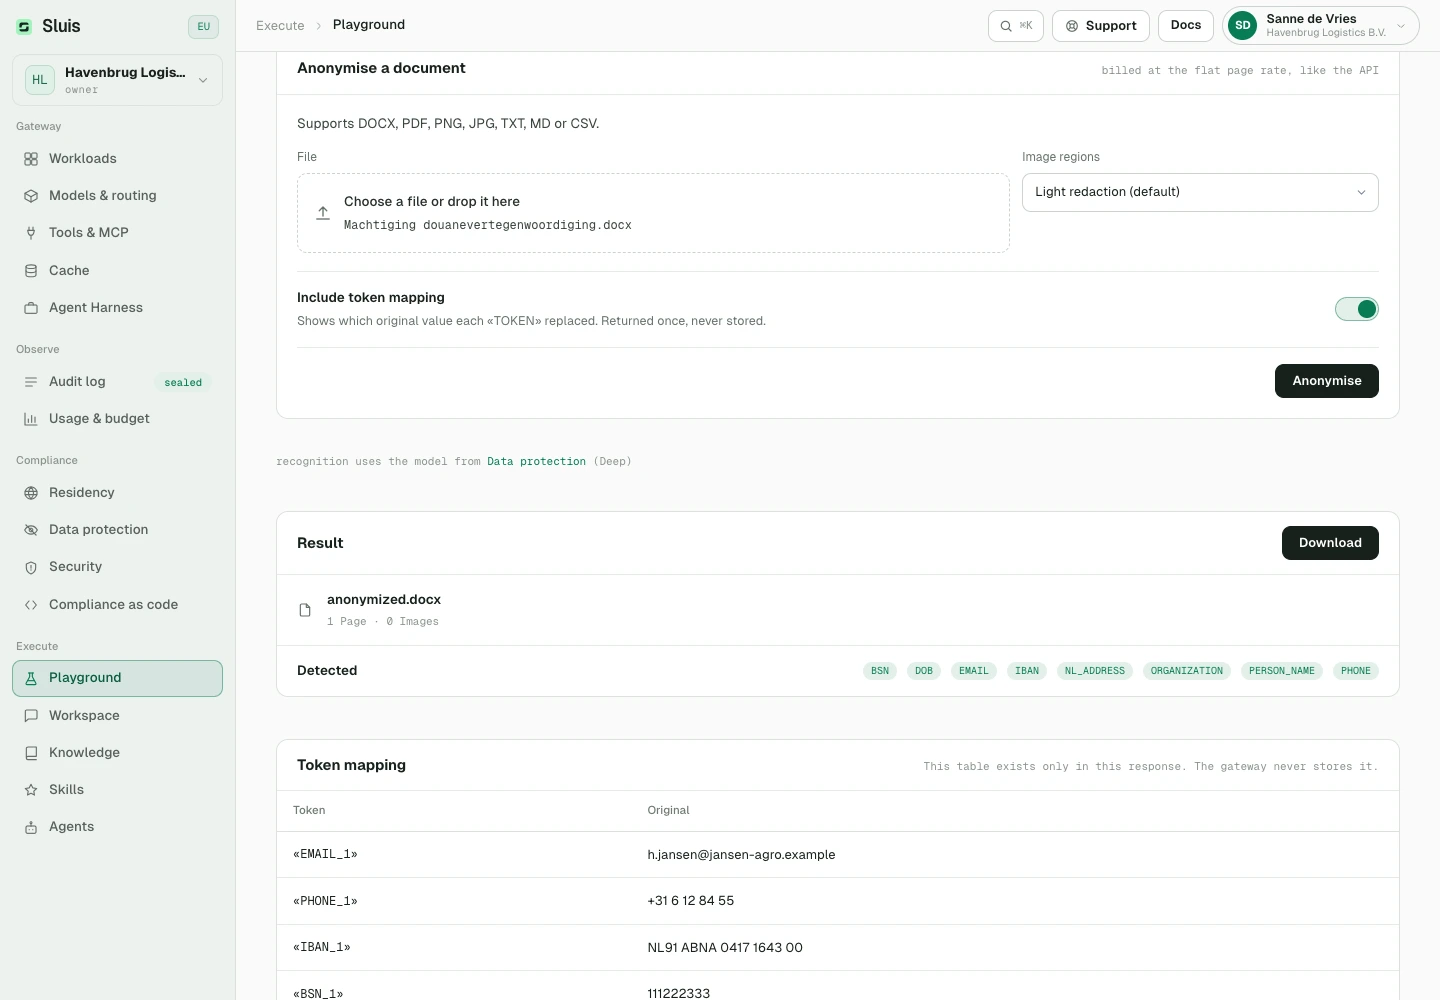
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Pseudonymisierte Token sind innerhalb einer Anfrage stabil, nicht über Anfragen hinweg; Embeddings tokenisierten Texts können daher zwischen Aufrufen abweichen. Die Einstellung dlp_embeddings steuert, ob der Scan /v1/embeddings abdeckt: standardmäßig an, mit off gehen Embedding-Eingaben ungescannt an den Provider. Jeder ausgenommene Aufruf wird im Audit-Protokoll festgehalten.
Entfernungsbegriffe pro Anfrage
Jede JSON-Anfrage auf der Datenebene — chat completions, completions, embeddings, responses sowie die nativen Anthropic-Ingresses — darf eine sluis-Erweiterung auf oberster Ebene tragen. Ihre Liste remove benennt die Begriffe, die die gateway vor dem Versand aus dem Prompt entfernen muss: ein reiner String oder ein Objekt mit text und einem kind aus person | organization | location | term. Höchstens 128 Einträge, jeder nach dem Trimmen nicht leer und höchstens 256 Zeichen lang; verglichen wird an Wortgrenzen und ohne Rücksicht auf Groß-/Kleinschreibung. Die Erweiterung selbst ist ein Konstrukt der gateway und wird immer vor dem Versand entfernt: Sie erreicht nie einen Provider, den Cache oder aufbewahrte Inhalte.
# name the terms the gateway must remove — the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out — the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Jeder Treffer wird zu einem umkehrbaren Token — «PERSON_NAME_1» —, der sich der normalen Pseudonymisierung anschließt: unter tokenize, dem Standard, werden die Originalwerte in der Antwort wiederhergestellt, Streaming eingeschlossen; unter mask wird der Begriff durch [REDACTED:<kind>] ersetzt; unter block wird die Anfrage mit 422 abgewiesen. Die Anweisung wird immer befolgt, auch wenn der Key dlp: off setzt, die Organisation in allow_log läuft oder /v1/embeddings ausgenommen ist: Sie kann den Schutz nur verstärken, nie schwächen, und darum ist sie pro Anfrage erlaubt, wo der abgeschaffte Header x-sluis-dlp es nicht war. Der genannte Begriff erreicht den Provider nie.
Eine fehlerhafte Direktive wird nie stillschweigend ignoriert: ein unbekanntes kind, ein Eintrag über den Grenzen oder ein unbekanntes Feld in der Erweiterung werden mit 422 abgewiesen. Was tatsächlich lief, wird auf der versiegelten Audit-Zeile offengelegt, wo vom Aufrufer gelieferte Begriffe die Ebene request tragen — dlp:tokenize:person_name(request) —, unterschieden von den Ebenen (ner) und (directory), sodass das Protokoll zeigt, woher jede Entfernung stammt. Dieselbe Liste wird als remove-Option auf /v1/documents/anonymize und dessen asynchronen Jobs akzeptiert.
Workload-Option-Overrides
Overrides gehören zum Workload und gelten für alle seine Zugangsdaten. Ein Owner oder Admin konfiguriert option_overrides in Console → Workloads oder beim Erstellen mit POST /admin/workloads. Nicht gesetzte Optionen erben die Organisations-Policy. PATCH /admin/workloads/{workload_id} benötigt zum Bearbeiten sämtliche veränderbaren Einstellungen einschließlich Name, Status, Limits und Budget; sie werden ersetzt, nicht feldweise zusammengeführt.
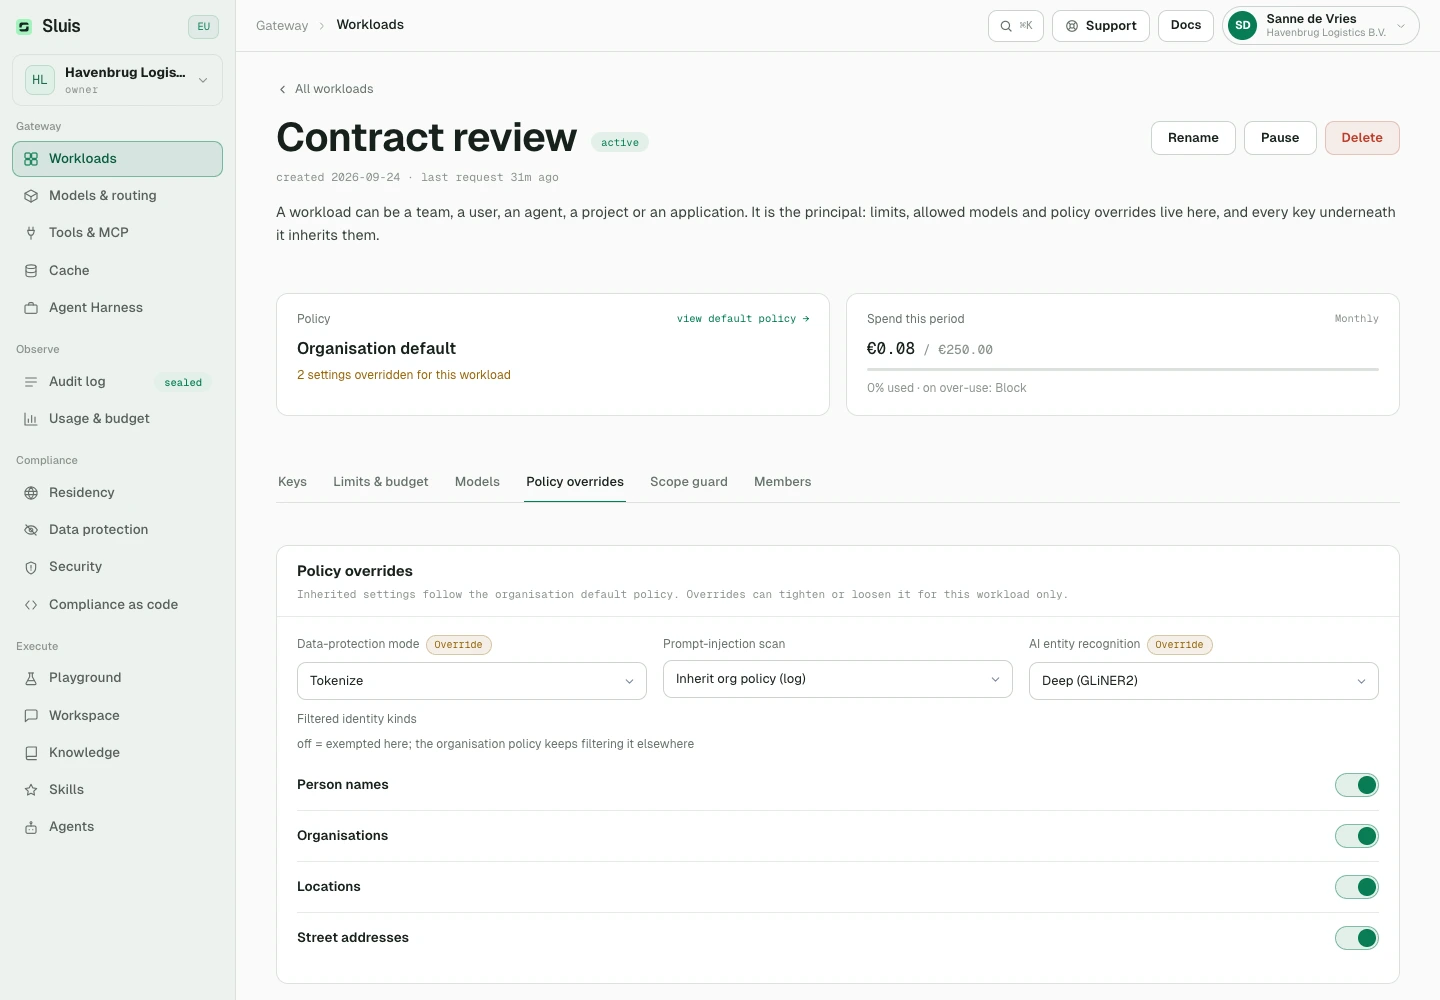
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "mode": "off" },
        "ner_model": "deep",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
Der Request-Header x-sluis-dlp wurde entfernt. Anfragen damit erhalten 400; konfigurieren Sie stattdessen den Workload. Wirksame Overrides werden im versiegelten Audit-Trail erfasst.