Gegevensbescherming
Detectiemodi, de bibliotheek met 60 detectoren, entiteitsdetectie met keuzemodellen, securityscanning, de modelnotitie en retentie.
Gegevensbescherming draait op elk verzoek vóór verzending. De standaardmodus is tokenize: elke gedetecteerde waarde wordt vervangen door een stabiele getypeerde token zoals «EMAIL_1». Gedetecteerde waarden bereiken de provider alleen als tokens, en op de terugweg naar jou wordt het antwoord hersteld naar de echte waarden, gestreamd of niet. De tokenmap leeft in het geheugen zolang het verzoek duurt en wordt nooit opgeslagen. Pseudonimisering werkt één kant op: ze beschermt wat jij verstuurt. In Sluis Workspace worden openbare webzoekresultaten en de eigen uitvoer van het model eerder in dezelfde beurt niet opnieuw getokeniseerd; een waarde die het gesprek al tokeniseerde, blijft vervangen door zijn token, en het auditlog vermeldt wanneer dit gold.
# tokenize mode (the default): what you send
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "sluis/auto", "messages": [{ "role": "user",
        "content": "Mail j.devries@acme.nl that IBAN NL91ABNA0417164300 is active." }] }'
# what the model provider receives — only stable typed tokens
{ "role": "user",
  "content": "Mail «EMAIL_1» that IBAN «IBAN_1» is active." }
# what you get back — restored at the single client egress, streaming included
{
  "choices": [{
    "message": {
      "role": "assistant",
      "content": "Draft: Dear j.devries@acme.nl, your account NL91ABNA0417164300 is active…"
    }
  }]
}
Andere modi: mask herschrijft gedetecteerde waarden onomkeerbaar, block weigert het verzoek met 422, en allow_log laat het door en markeert tegelijk de auditregel.
60 ingebouwde detectoren zijn er meteen: 28 voor persoonsgegevens, van het Amerikaanse Social Security-nummer tot een pakket nationale ID's met checksumvalidatie voor 12 EU-landen, en 32 voor secrets en credentials. Elke detector is per organisatie in/uit te schakelen, en eigen termen (gewoon of regex) dekken alles wat specifiek is voor jouw bedrijf:
Entiteitsdetectie
Personen, organisaties en locaties zijn alleen met patronen moeilijk te herkennen. Sluis combineert contextheuristieken, e-mailcorrelatie, een namenlijst per tenant, meegeleverde woordenboeken en optionele NER. Het NER-model draait als netwerkinterne sidecar: tekst blijft binnen de deployment. Deze lagen inspecteren ook geëxtraheerde document- en OCR-tekst wanneer documentbescherming aanstaat. Met NER aan mag één verzoek tot 100.000 verschillende entiteiten noemen; boven die grens telt de scan als onvolledig. Een naam die het model één keer vindt, wordt overal vervangen waar hij in het verzoek terugkomt, als hetzelfde hele woord met dezelfde hoofdletters en hetzelfde token, ook in berichten waarin het model hem niet meldde. Losse algemene woorden en korte afkortingen gelden alleen op de plek die het model meldde.
Het namenwoordenboek is de deterministische tegenhanger van NER: voornamen en achternamen, samengesteld uit open overheidsdata tot een woordenboek dat in de gateway meegeleverd wordt. Het vangt volledige namen en namen na een aanspreektitel, zonder extra vertraging en zonder dat er iets je perimeter verlaat. Namen die ook gewone woorden zijn worden alleen gevangen met naamvormige context; zeldzame namen blijven het werk van de naamdirectory of NER.
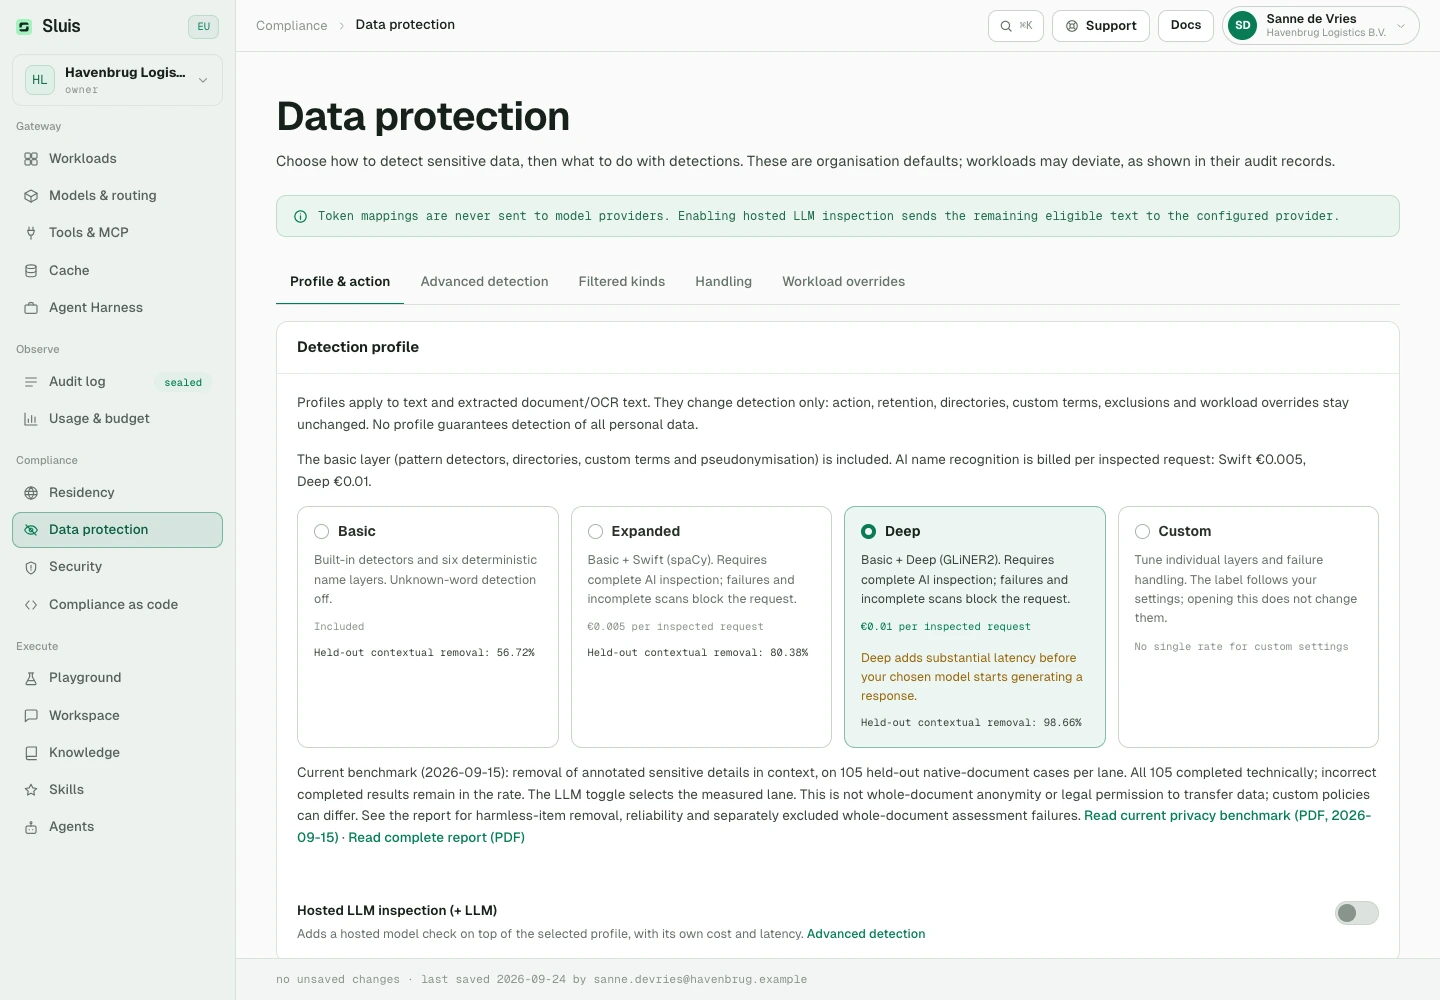
NER-modelopties
Kies Basis, Uitgebreid of Diepgaand in Gegevensbescherming. Basis gebruikt ingebouwde detectoren en zes deterministische naamlagen zonder modelaanroep; nieuwe organisaties starten hiermee. Uitgebreid voegt Swift (spaCy) toe; Diepgaand gebruikt in plaats daarvan GLiNER2-PII. Beide ML-profielen vereisen volledige inspectie en blokkeren modeluitval of onvolledige scans. Diepgaand kost meer verwerkingstijd, maar garandeert geen hogere recall. Aangepast laat individuele verfijning toe. Bestaand beleid, uitsluitingen, namenlijsten en workload-afwijkingen blijven behouden; onbekendewoorddetectie staat in alle drie profielen uit. Een workload kan NER niet aanzetten als de organisatie de laag uit heeft. AI-naamherkenning wordt één keer per geïnspecteerd klantverzoek afgerekend: € 0,005 met Swift (Uitgebreid), € 0,01 met GLiNER2 (Diepgaand); Basis is inbegrepen. Vervolgaanroepen die Sluis binnen dat verzoek doet, worden niet opnieuw gerekend, en een onvolledige inspectie kost niets. Elke afrekening is een gekoppeld auditbewijs dat meetelt voor je budgetten.
Diepgaand voegt aanzienlijke wachttijd toe voordat uw gekozen model een antwoord begint te genereren. De scantijd van Swift en GLiNER2 hangt af van tekstlengte, aantal berichten en hardware. De limiet geldt voor de totale NER-scan van alle berichten, bijlagen en vensters in één verzoek, niet per venster: 30 seconden tot 320.000 tekens, plus 30 seconden per volgende 320.000 tekens, maximaal 10 minuten. Dit is een maximum, geen gebruikelijke latentie. Optionele gehoste LLM-inspectie voegt een aparte wachttijd toe vóór antwoordgeneratie, afhankelijk van tekstlengte, providerbelasting en nieuwe pogingen; deze valt buiten de NER-limiet.
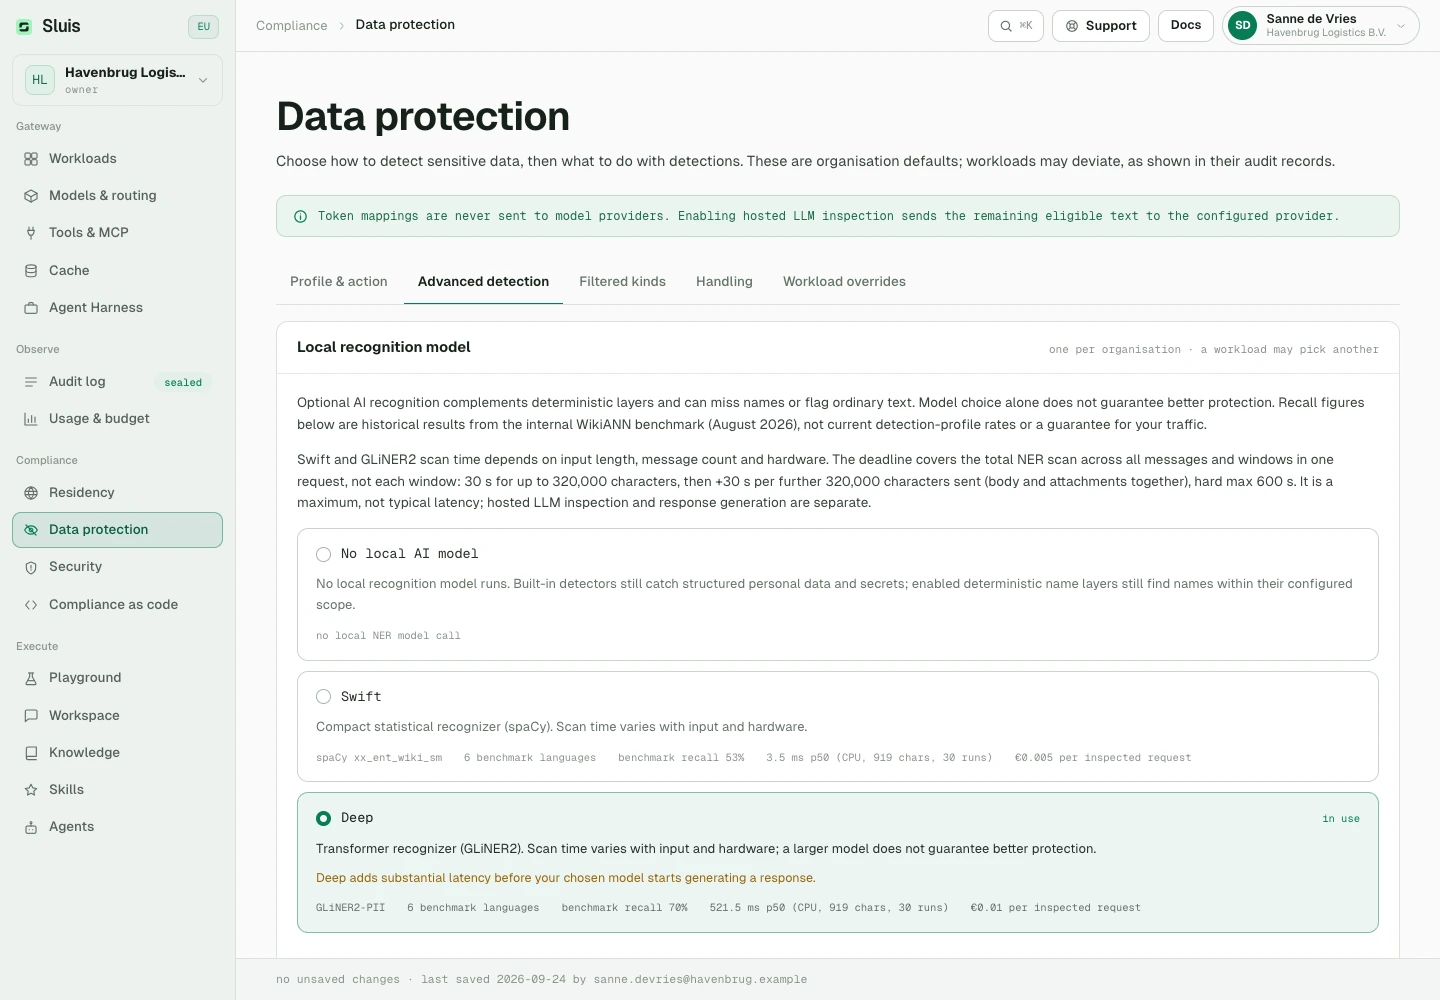
| Model | Dekking | Gemeten nauwkeurigheid | Latency |
|---|---|---|---|
| swift · spaCy xx_ent_wiki_sm | multilingual, basic | all-entity F1 0.58 · person F1 0.72 · recall ~0.53 | 3.5 ms p50 (CPU, 919 chars, 30 runs) |
| deep · GLiNER2-PII (mDeBERTa-v3, Apache-2.0) | 7 trained languages (EN, FR, ES, DE, IT, PT, NL) + multilingual backbone transfer | all-entity F1 0.61 · person F1 0.76 · recall ~0.70 | 521.5 ms p50 (CPU, 919 chars, 30 runs) |
Gemeten op 2026-08-12 in een interne benchmark: WikiANN-testzinnen in zes talen (NL, EN, DE, FR, ES, IT; 150 per taal), gescoord als micro-F1 over (label, tekst)-paren op tekstniveau met het productiefilter tegen valse positieven toegepast, op een Apple Silicon-ontwikkelmachine in FP32. WikiANN is automatisch geannoteerd Wikipedia-materiaal en het thuisterrein van spaCy: lees de cijfers als relatieve richtlijn tussen de niveaus, niet als absolute nauwkeurigheid in het veld.
Securityscanning
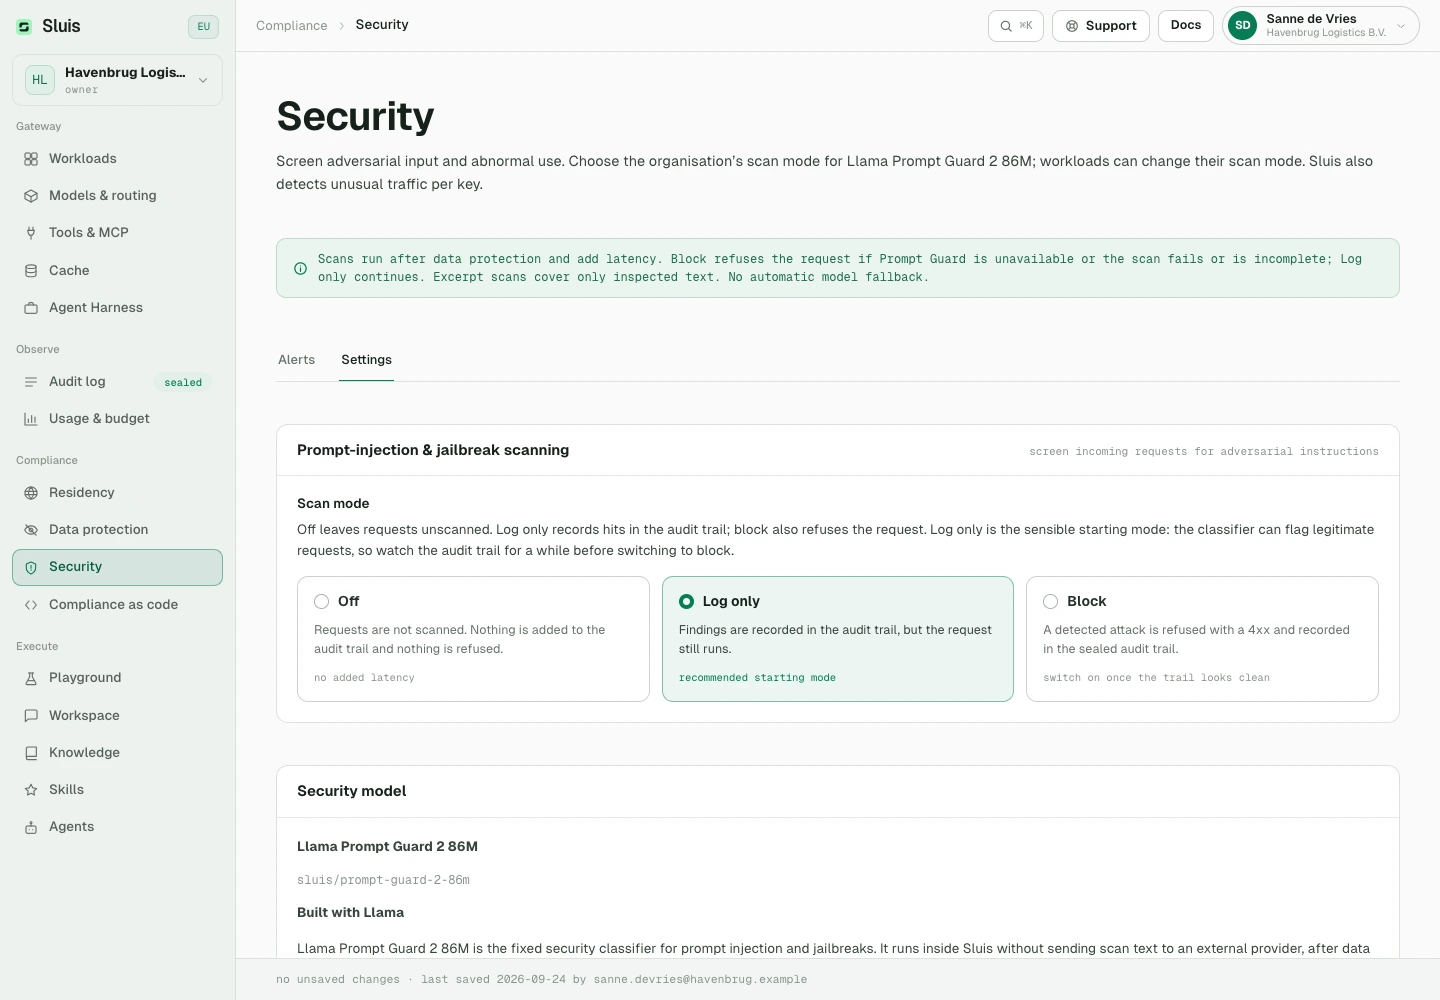
Optionele detectie van prompt injection en jailbreaks bij de sluis, gescand vóór verzending. Drie modi: off | log | block. off slaat de scan over. log registreert bevindingen zonder verkeer te blokkeren. block weigert gedetecteerde aanvallen en blokkeert als Prompt Guard niet beschikbaar is of de classificatie mislukt of onvolledig is. Geen automatische modelterugval.
Beveiliging gebruikt altijd Llama Prompt Guard 2 86M (sluis/prompt-guard-2-86m), binnen Sluis zonder externe overdracht van scantekst. EUR 0,01 per afgeronde logische scan, eenmaal ongeacht vensters of oordeel, ook bij veilige steekproeven; geen tokentoeslag. Uit, vooraf geweigerde scans en technische fouten worden niet berekend. Overlappende vensters van maximaal 512 modeltokens behouden segmentgrenzen, binnen het ingestelde totale scanbudget van 4096 tot 65536 tokens. De vaste detectiedrempel is 0,8. De scan draait na gegevensbescherming, die persoonsgegevens kan behouden als deze uitstaat of alleen logt. Scans voegen latentie toe en hebben begrensde deadlines. Lange invoer gebruikt fragmenten; een veilig oordeel dekt alleen onderzochte tekst. Audit registreert onderzochte en totale bytes. Built with Llama. Meta Llama 3.1 Community License.
Elke scan heeft een aparte, gekoppelde factureerbare auditregel: security.scan. Kosten kunnen ook ontstaan als het oorspronkelijke verzoek wordt geblokkeerd of uit de cache wordt beantwoord. Uitzonderingen per workload kunnen de scanmodus wijzigen. De aparte optionele Nemotron-privacycontrole gebruikt Nebul onder uw residentiebeleid en wordt per token afgerekend.
Los daarvan draait optionele anomaliedetectie op key-gedrag als achtergrondtaak, zonder enige latency op verzoeken: baselines per key uit robuuste statistiek met uur-van-de-week-seizoenspatronen, plus een multivariate isolation-forest-laag. Alerts zijn uitlegbaar, nooit een kale score, en verschijnen in het onderdeel Beveiliging van de Console, optioneel per e-mail.
Modelnotitie
Als tokenisatie een verzoek heeft herschreven, injecteert Sluis vooraan een systeembericht dat het model vertelt dat de «…»-tokens ondoorzichtige placeholders zijn die het intact moet laten; dat is wat het herstel betrouwbaar houdt. Standaard aan; pas het aan of schakel het uit per organisatie.
Retentie & auditgetrouwheid
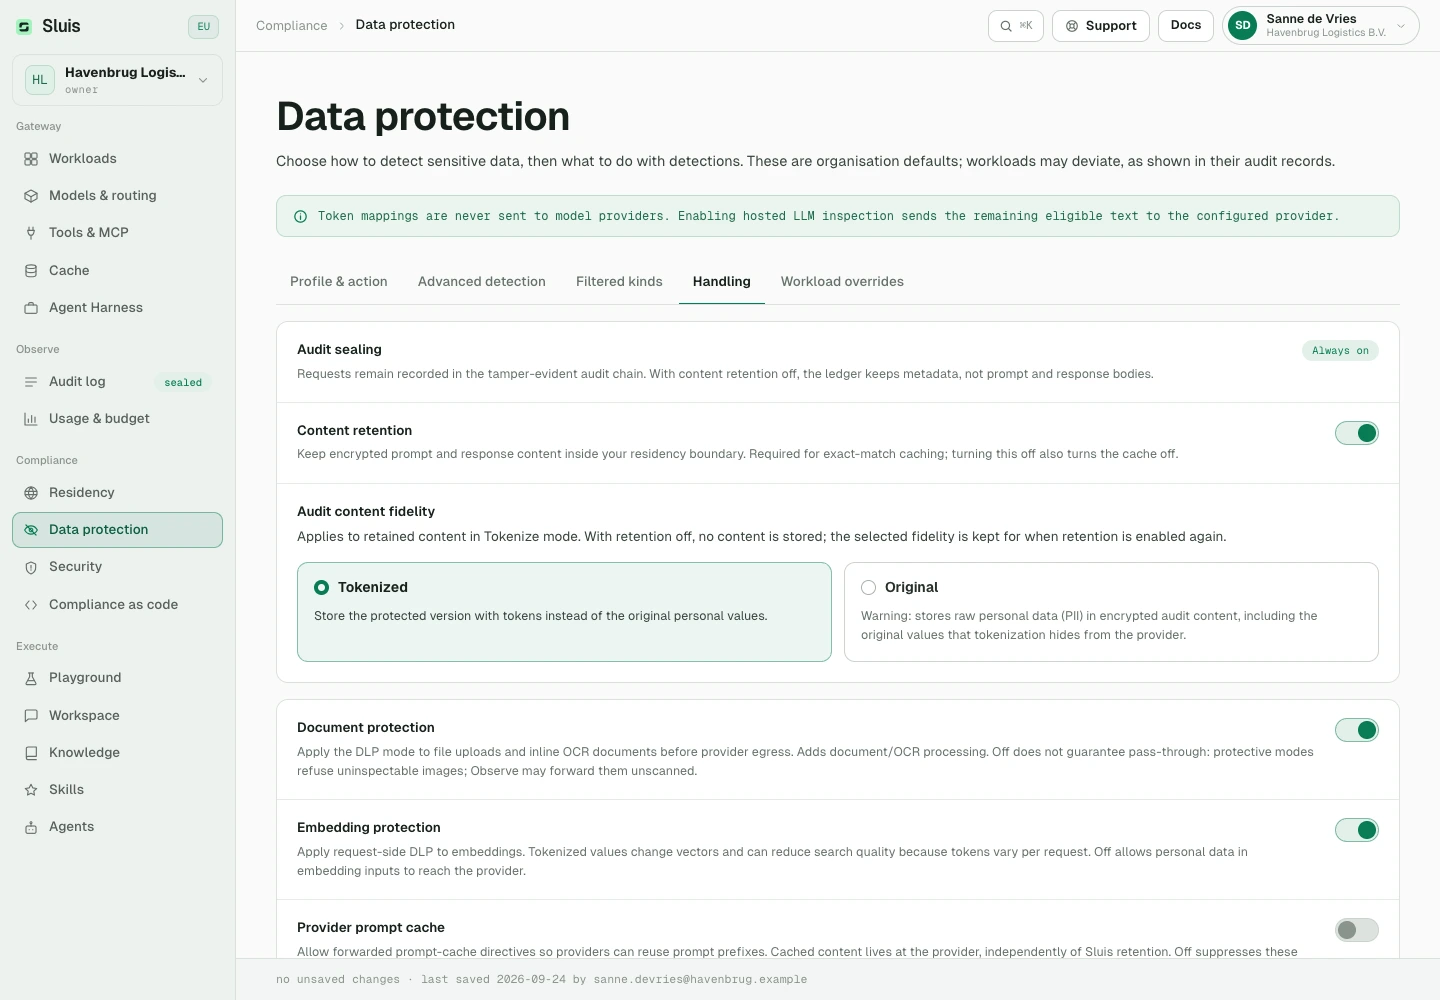
Contentretentie (request- en response-bodies voor het auditlog) staat standaard aan en is versleuteld in rust; auditgetrouwheid bepaalt of bewaarde content de tokens of de originele waarden opslaat. Bewaarde content blijft staan tot u die wist, tenzij u in de weergave Gegevensbescherming van de Console een bewaartermijn in dagen instelt. Een dagelijkse opschoning past de huidige termijn toe op content die al is opgeslagen, dus een kortere termijn verwijdert ook oudere content. Content uit Sluis Workspace-chats wordt verwijderd na de kortste van die termijn en de Workspace-termijn voor persoonlijke waarden in chats (standaard 7 dagen). Het grootboek met auditmetadata blijft bewaard en wordt nooit gewijzigd. Zet retentie uit voor een grootboek met alleen metadata; dat schakelt ook de response-cache uit.
Documentanonimisering
Stuur een docx-, pdf-, afbeeldings- of tekstbestand naar POST /v1/documents/anonymize en hetzelfde document komt terug met PII en secrets vervangen door merge tags zoals «PERSON_NAME_1» in tekst, en vervaagd in afbeeldingen en PDF-pagina's. De verwerking blijft lokaal in de gateway, OCR inbegrepen; de operatie wordt verzegeld in de auditketen en gefactureerd per pagina/afbeelding. De tokentabel wordt alleen teruggegeven als je erom vraagt en nooit opgeslagen. Geredigeerde PDF's behouden een onzichtbare doorzoekbare tekstlaag opgebouwd uit de geanonimiseerde tekst. Voor grote documenten zet je een asynchrone job in de wachtrij en haal je het resultaat later op via een tijdgebonden ondertekende URL. Op scans worden regels die de OCR niet betrouwbaar kan lezen, zoals handtekeningen en onleesbaar handschrift, en inkt buiten elke herkende tekstregel, zoals parafen en stempels, vernietigd in plaats van geraden. Ze staan als «UNREADABLE» in de tekstlaag en het antwoord meldt de categorie UNREADABLE_REDACTED.
Dezelfde bescherming werkt onderweg: met het dlp_documents-beleid aan worden bestanden die via /v1/files binnenkomen en inline OCR-documenten geanonimiseerd voordat ze naar een provider vertrekken, geweigerd onder block en gescand onder allow_log.
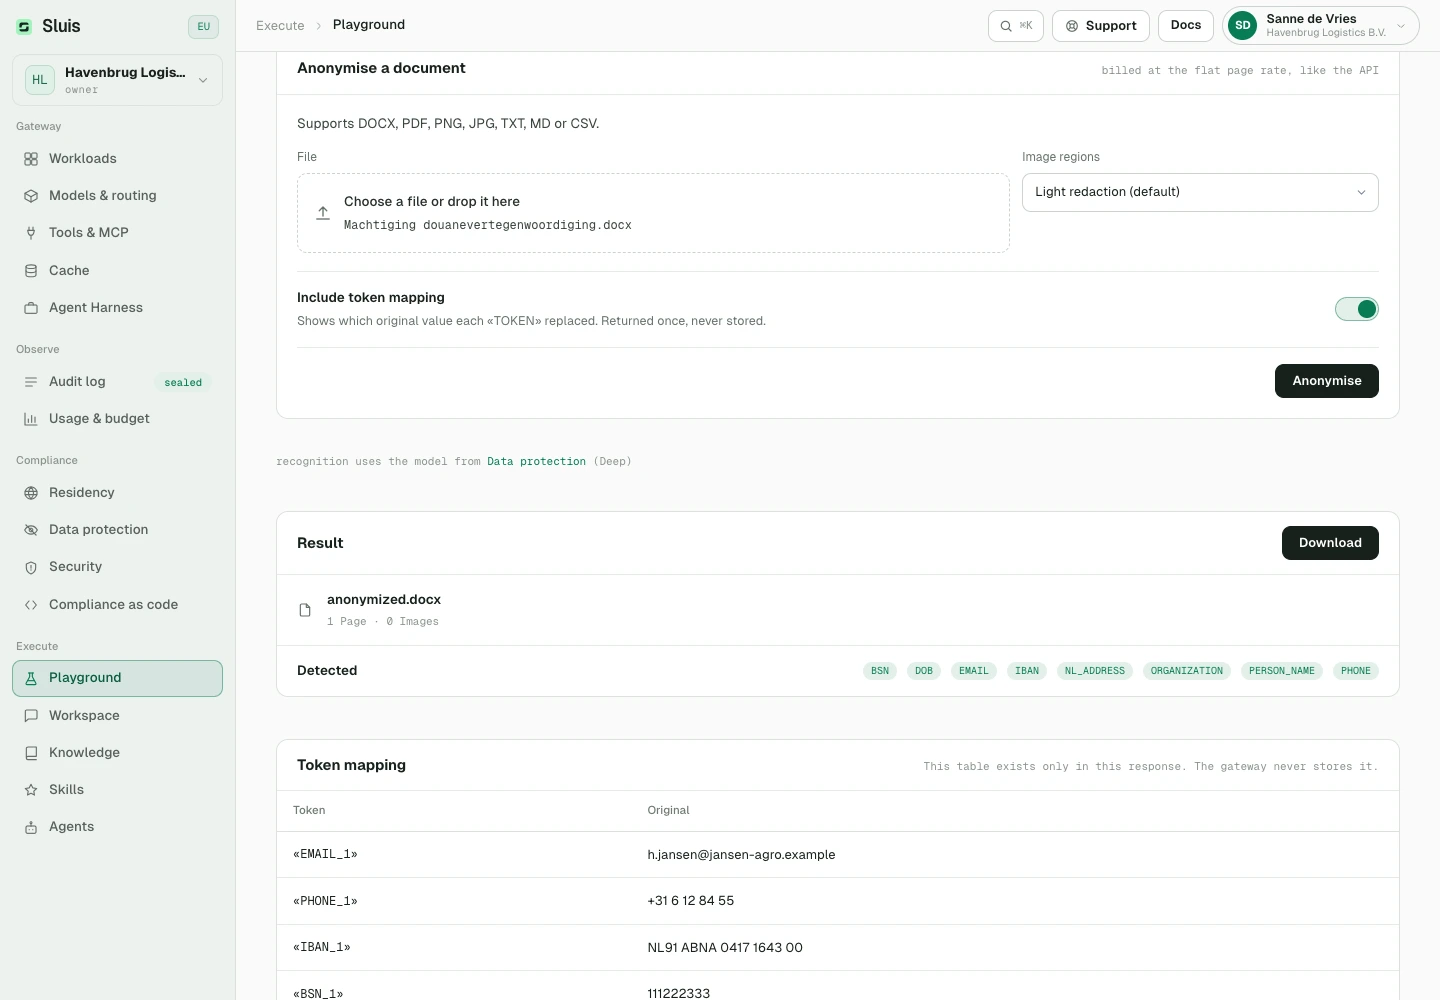
# enqueue a large document (202 + job id; Idempotency-Key honoured)
curl https://api.sluis.ai/v1/documents/anonymize/jobs \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -F file=@archive.pdf

# poll until succeeded; the signed download_url then needs no API key
curl https://api.sluis.ai/v1/documents/anonymize/jobs/9c31… \
  -H "Authorization: Bearer $SLUIS_KEY"
{
  "id": "9c31…",
  "state": "succeeded",
  "filename": "archive.pdf",
  "summary": { "pages": 12, "images": 3, "categories": ["PERSON_NAME", "EMAIL"], "downgraded": false },
  "download_url": "https://api.sluis.ai/v1/documents/deliverables/9c31…?tenant=…&exp=…&sig=…"
}
Embeddings
Gepseudonimiseerde tokens zijn stabiel binnen een verzoek, niet tussen verzoeken; embeddings van getokeniseerde tekst kunnen dus per aanroep verschillen. De instelling dlp_embeddings bepaalt of de scan /v1/embeddings dekt: standaard aan, op off gaat embedding-invoer ongescand naar de provider. Elke uitgezonderde aanroep wordt vastgelegd in het auditlogboek.
Verwijdertermen per verzoek
Elk JSON-verzoek op het datavlak — chat completions, completions, embeddings, responses en de native Anthropic-ingresses — mag een sluis-extensie op het hoogste niveau dragen. De lijst remove daarin noemt de termen die de gateway vóór verzending uit de prompt moet verwijderen: een kale string, of een object met een text en een kind uit person | organization | location | term. Hoogstens 128 items, elk niet leeg na trimmen en maximaal 256 tekens; matching gaat op woordgrenzen en negeert hoofdletters. De extensie zelf is een constructie van de gateway en verdwijnt altijd vóór verzending: ze bereikt nooit een provider, de cache of bewaarde inhoud.
# name the terms the gateway must remove — the top-level "sluis" object never leaves the gateway
curl https://api.sluis.ai/v1/chat/completions \
  -H "Authorization: Bearer $SLUIS_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "model": "mistral/mistral-large-latest",
        "messages": [{ "role": "user",
          "content": "Bas Alderding did a good job, send an email explaining how happy you are with that" }],
        "sluis": { "remove": [{ "text": "Bas Alderding", "kind": "person" }, "Project Nightingale"] } }'

# provider receives  → "«PERSON_NAME_1» did a good job, send an email explaining how happy you are with that"
# you receive back   → "Dear Bas Alderding, I am delighted with your work on Project Nightingale…"
# audit note         → dlp:tokenize:person_name(request)|dlp:tokenize:term(request)
# the OpenAI SDKs forward the gateway extension through extra_body
resp = client.chat.completions.create(
    model="mistral/mistral-large-latest",
    messages=[{"role": "user", "content": "Bas Alderding did a good job…"}],
    extra_body={"sluis": {"remove": [{"text": "Bas Alderding", "kind": "person"}]}},
)
# the originals are restored on the way out — the provider only ever saw «PERSON_NAME_1»
print(resp.choices[0].message.content)
Elke match wordt een omkeerbaar token — «PERSON_NAME_1» — dat meelift op de gewone pseudonimisering: onder tokenize, de standaard, worden de oorspronkelijke waarden in het antwoord hersteld, streaming inbegrepen; onder mask vervangt [REDACTED:<kind>] de term; onder block wordt het verzoek geweigerd met 422. De instructie wordt altijd gehonoreerd, ook als de key dlp: off zet, de organisatie in allow_log draait of /v1/embeddings is uitgezonderd: ze kan de bescherming alleen versterken, nooit verzwakken, en daarom mag ze per verzoek waar de ingetrokken header x-sluis-dlp dat niet mocht. De genoemde term bereikt de provider nooit.
Een misvormde directive wordt nooit stil genegeerd: een onbekend kind, een item boven de limieten of een onbekend veld binnen de extensie wordt geweigerd met 422. Wat er werkelijk draaide staat op de verzegelde auditregel, waar door de aanroeper aangeleverde termen de laag request dragen — dlp:tokenize:person_name(request) — onderscheiden van de lagen (ner) en (directory), zodat het logboek toont waar elke verwijdering vandaan kwam. Dezelfde lijst wordt aanvaard als remove-optie op /v1/documents/anonymize en zijn asynchrone jobs.
Workloadinstellingen overschrijven
Overrides horen bij de workload en gelden voor alle bijbehorende credentials. Een owner of admin configureert option_overrides in Console → Workloads of bij het aanmaken met POST /admin/workloads. Niet-ingestelde opties erven het organisatiebeleid. Voor wijzigen vereist PATCH /admin/workloads/{workload_id} alle wijzigbare instellingen, inclusief naam, status, limieten en budget; deze worden vervangen, niet per veld samengevoegd.
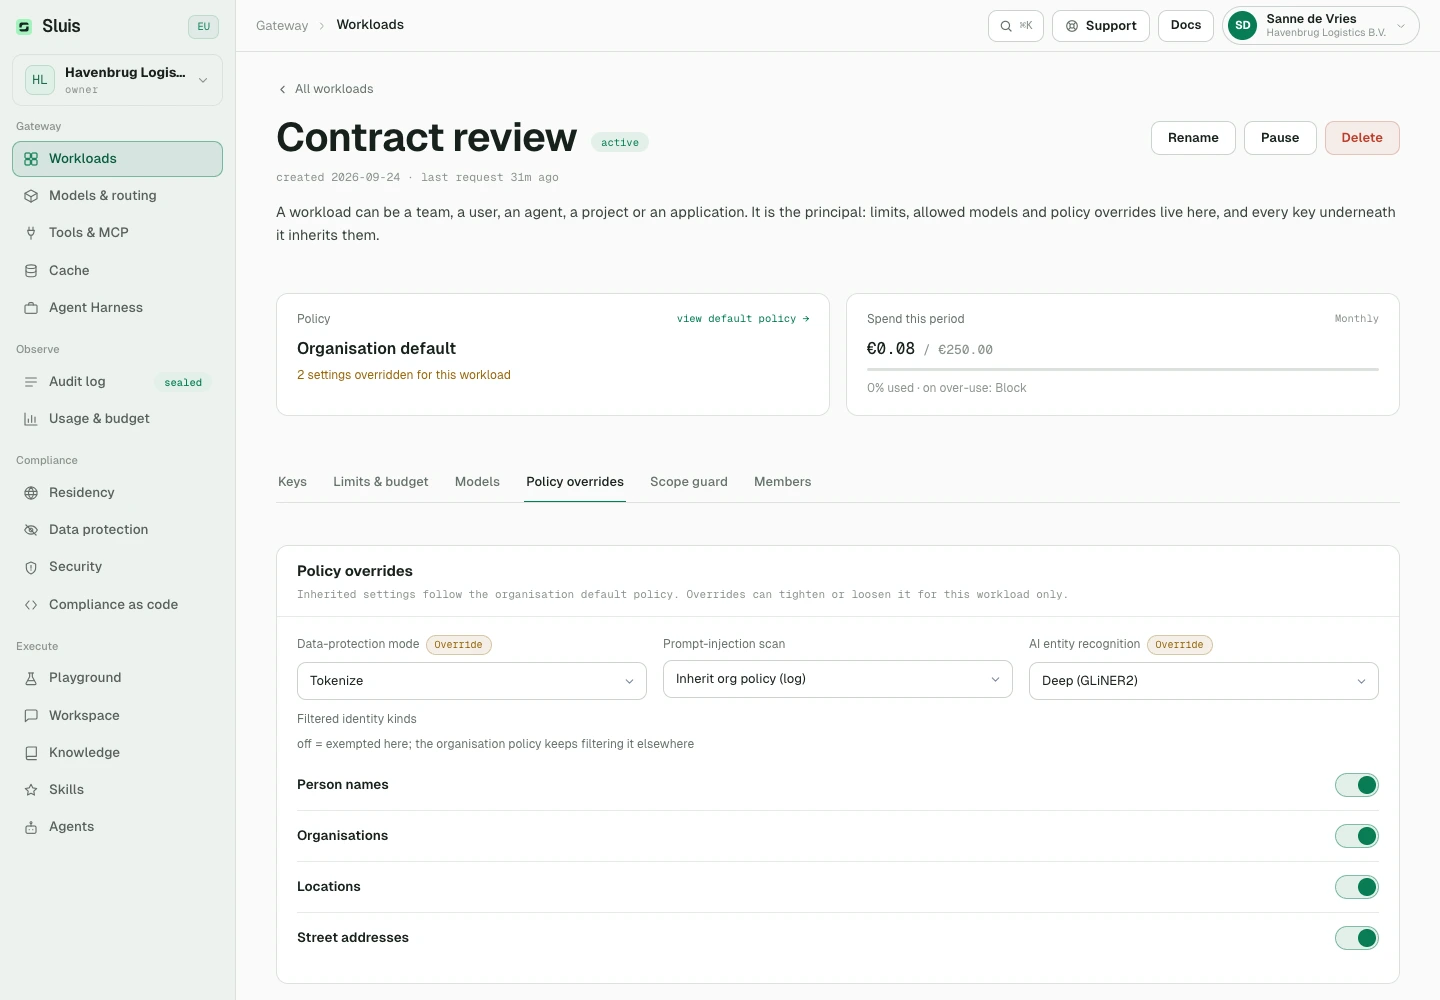
# create a workload with governed overrides; keys inherit its settings
curl -X POST https://api.sluis.ai/admin/workloads \
  -H "Authorization: Bearer $SLUIS_ADMIN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{ "name": "document-review", "option_overrides": {
        "dlp": { "mode": "off" },
        "ner_model": "deep",
        "security": { "prompt_injection": { "mode": "block" } } } }'
# sparse: absent fields inherit org policy; every deviation is sealed in the audit trail
De requestheader x-sluis-dlp is verwijderd. Verzoeken hiermee krijgen 400; configureer de workload. Geldende afwijkingen worden vastgelegd in het verzegelde auditlog.